原文:arXiv:2301.00808 · Woo et al., CVPR 2023
摘要: 在 2020 年代初期,得益于架构的改进和更好的表示学习框架,视觉识别领域经历了快速的现代化和性能提升。例如,以 ConvNeXt 为代表的现代卷积神经网络在各种场景中展现出强大的性能。虽然这些模型最初是为使用 ImageNet 标签进行监督学习而设计的,但它们也可能从自监督学习技术(如遮蔽自编码器 MAE)中受益。然而,我们发现简单地将这两种方法结合会导致性能欠佳。在本文中,我们提出了一个全卷积遮蔽自编码器框架和一个新的全局响应归一化(GRN)层,可以添加到 ConvNeXt 架构中以增强通道间特征竞争。这种自监督学习技术和架构改进的协同设计产生了一个名为 ConvNeXt V2 的新模型系列,该系列在各种识别基准测试上显著提高了纯卷积神经网络的性能,包括 ImageNet 分类、COCO 检测和 ADE20K 分割。我们还提供了各种规模的预训练 ConvNeXt V2 模型,从一个高效的 370 万参数的 Atto 模型(在 ImageNet 上实现 76.7% 的 top-1 准确率),到一个 6.5 亿参数的 Huge 模型(仅使用公开训练数据就达到了 88.9% 的最先进准确率)。
1. Intro
ConvNext 是针对来源于 NLP 中的 Transformer,对 Convolution Network 进行改造。ConvNext V2 则是对 NLP 中应用的很好的 Mask Autoencoder 方法改进到 ConvNext V1 中。这种改造主要遇到了以下几个问题:
- MAE 是设计给 Encoder-Decoder 的 Transformer 使用的,patch seq 的计算范式和 ConvNext 的基于卷积的方法不兼容;为了解决这个问题,ConvNext V2 在训练过程中使用类似稀疏卷积的方式实现,但在微调时可以切换回标准的密集层;
- 直接用 MAE+ConvNext 训练起来非常困难,尤其是 MLP 层可能出现特征崩溃;为了解决这个问题,提出了 Global Response Normalization layer。
2. Related Work
ConvNets
传统的监督学习为主,自监督的工作慢慢出现;重新吹了一下 ConvNext。
Masked Autoencoders
以 MAE 为代表的遮蔽图像建模是最新的自监督学习策略之一。作为神经网络预训练框架,MAE 对视觉识别产生了广泛影响。然而,由于其非对称的编码器 - 解码器设计,原始的遮蔽自编码器不能直接应用于 ConvNets。像这样的替代框架尝试调整该方法以用于 ConvNets,但结果好坏参半。MCMAE 使用几个卷积块作为输入标记器。据我们所知, 目前还没有预训练模型显示自监督学习可以改进最佳的 ConvNeXt 监督学习结果。
3. Fully Convolutional Masked Autoencoder
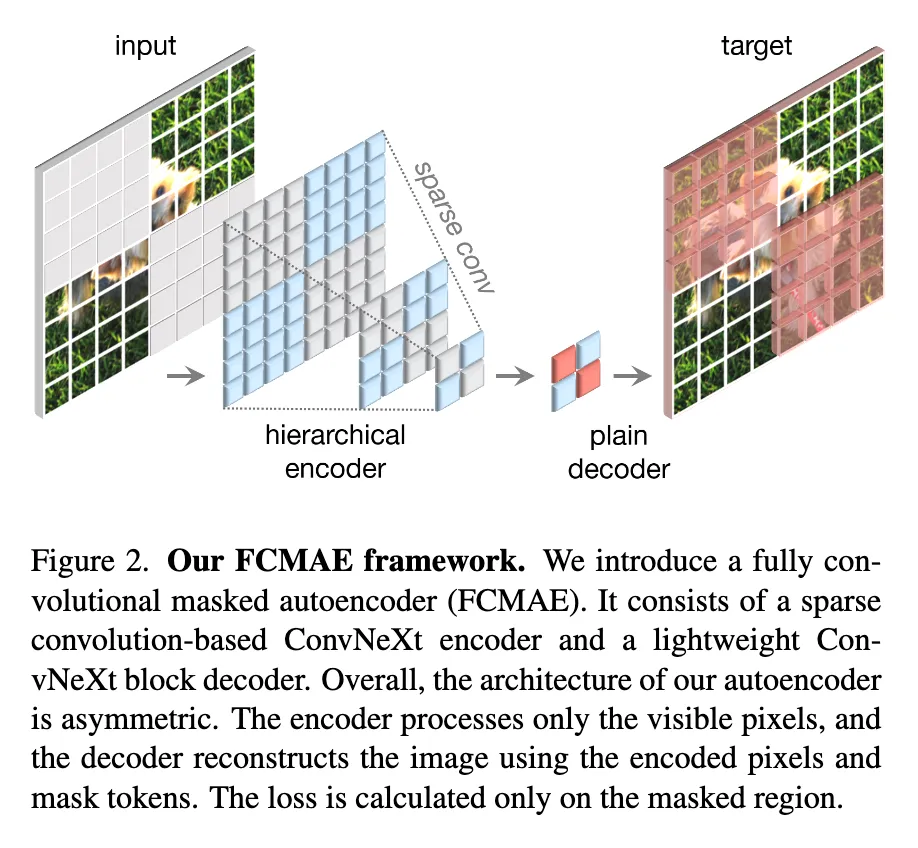
在原来的输入上随机生成 mask,然后让模型根据上下文预测缺失的部分。
Masking
随机遮罩,比例为 0.6。在最后阶段(特征图最小的时候)生成 mask,然后做上采样。采用 minimal 的数据增强,只包含随机的 resized cropping。
Encoder design
使用 ConvNext 作为 Encoder。在传统的 NLP 模型中,因为输入是一个 sequence,让模型看不到被 masked 的位置很简单;但是对于图片输入而言,要保证空间结构的同时 mask 一些内容,如果处理不好就会让模型学到本来看不到的内容。
ConvNext V2 学习 3D 点云卷积,新见解是 “稀疏数据视角” 看待 masked image。Pretrain 的过程中,将标准卷积换成 submanifold sparse convolution,然后在做微调的时候换回普通的卷积。也可以直接用卷积 + 二进制 mask 的方法,计算量会更大,但是对 GPU 等芯片更加友好。
Decoder design
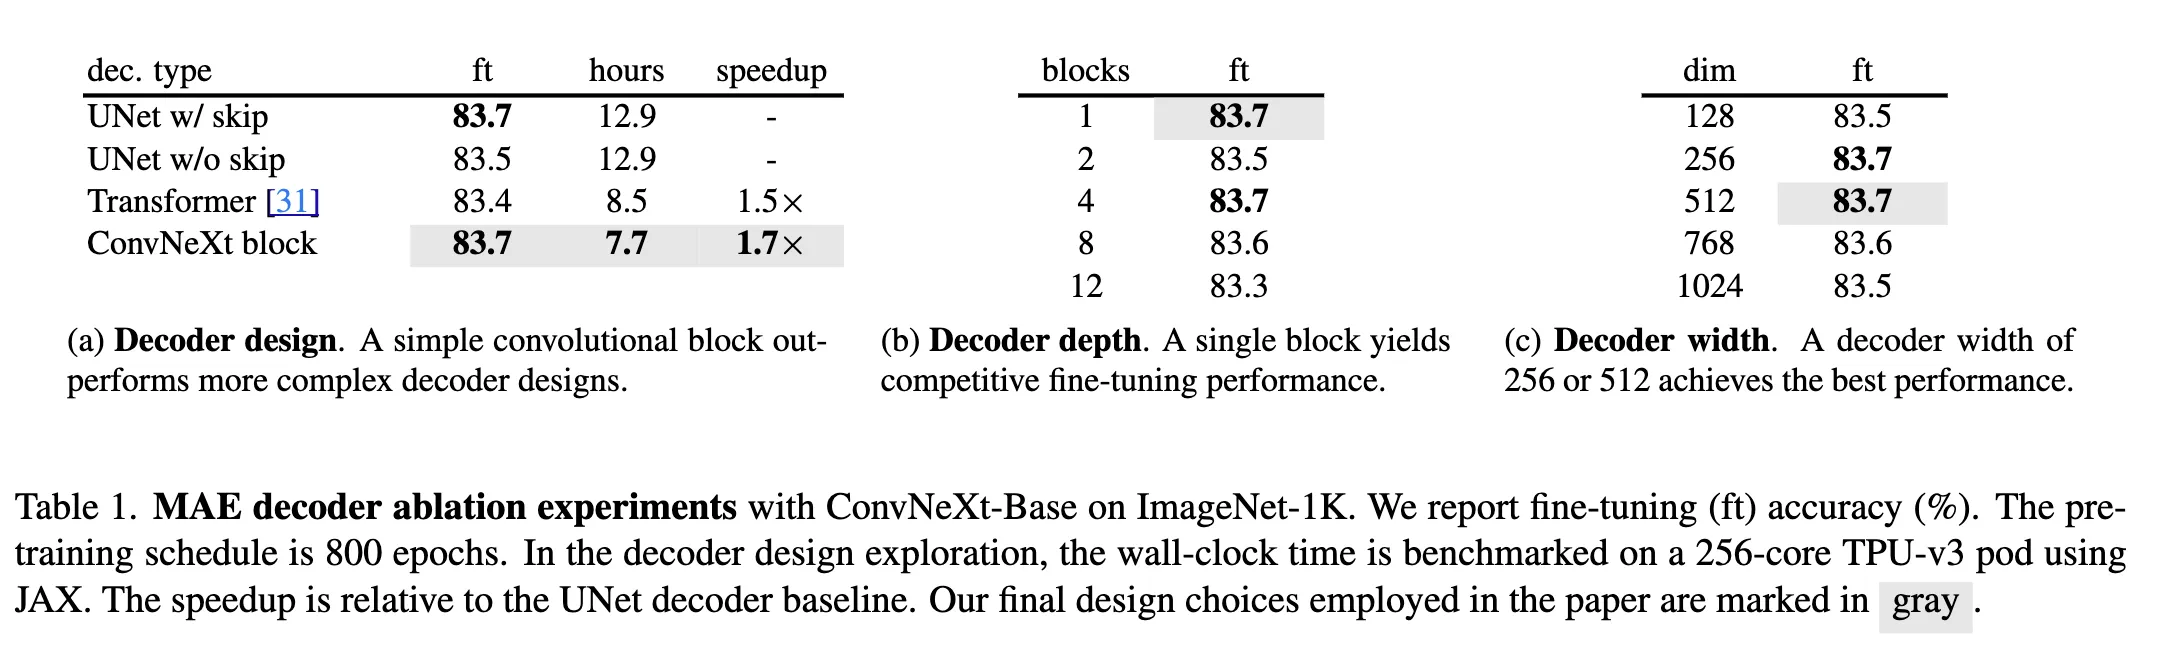
用了一个简单的 ConvNext 块作为 Decoder,构成了一个非对称的 Encoder-Decoder 结构。尝试了更加复杂的 Decoder,但是这个简单的方案表现就很好,并且训练需要的时间很短。
Reconstruction target
计算生成图像和原图的 MSE,只在 masked 的部分计算。
FCMAE
在 ImageNet-1K 上分别做 800 个 epoch 的 pretrain 和 100 个 epoch 的 finetuning。
- 不使用 Sparse Conv 的 Acc 是 79.3,使用后为 83.7,减少信息泄露很重要;
- 训练 100/300 个 epoch 的全监督模型的精度是 82.7 和 83.8,性能已经基本比得上全监督的模型了;
4. Global Response Normalization
Feature collapse
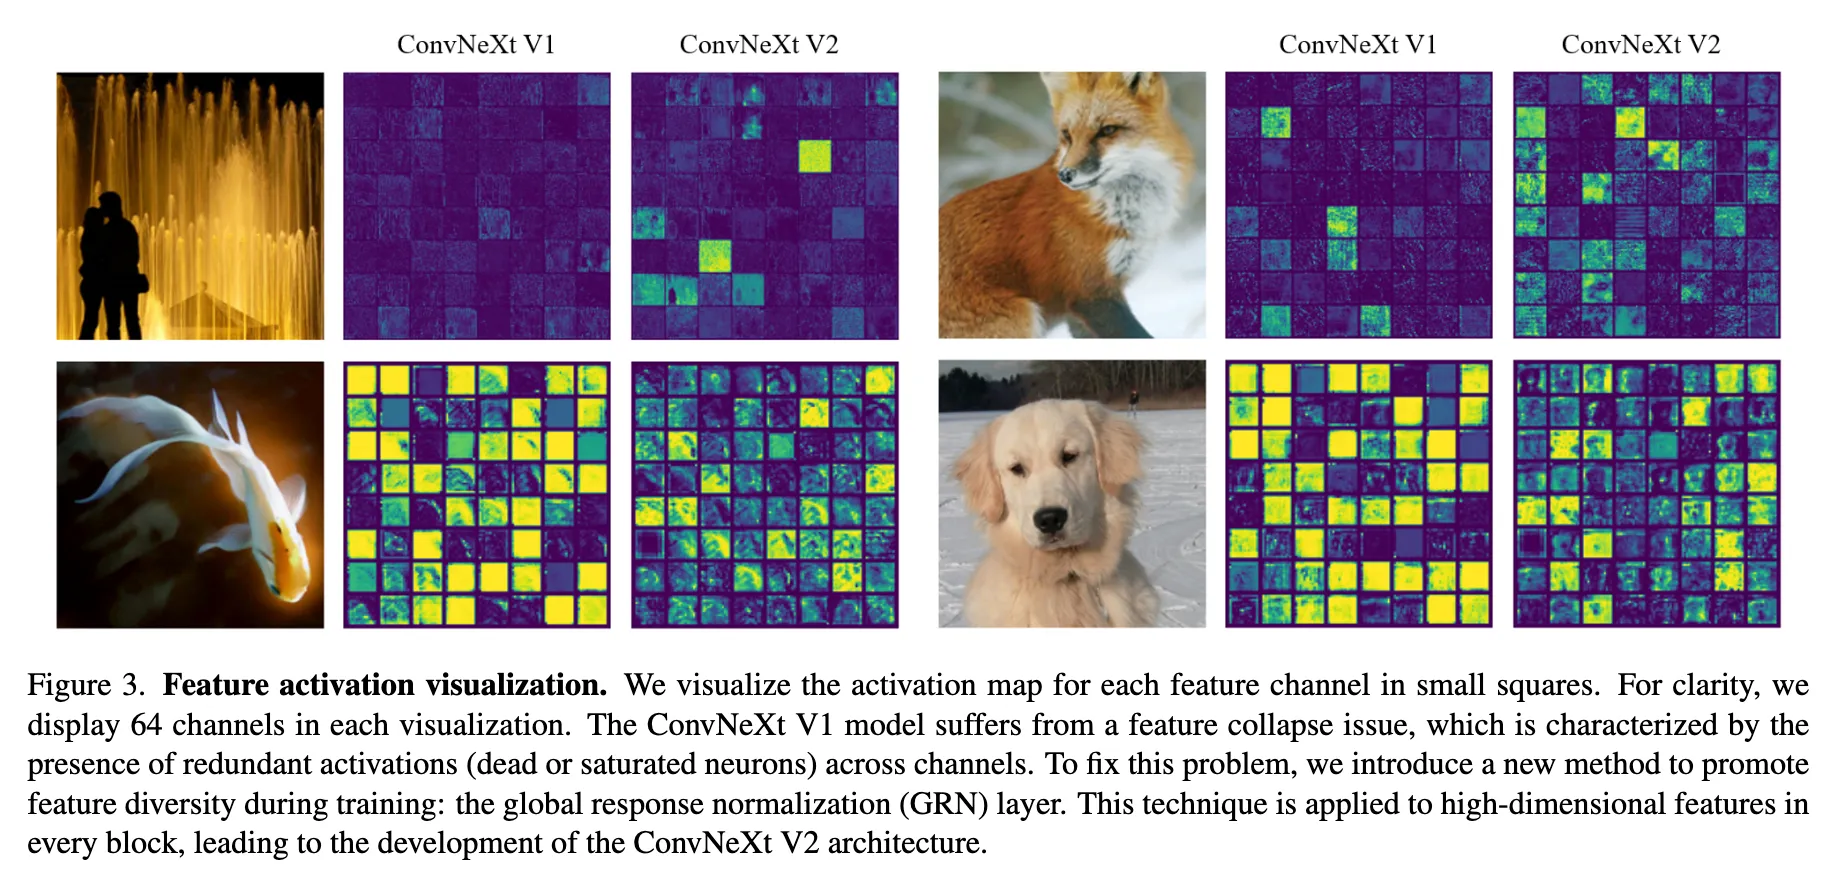
在 ConvNext V1 中,可以看到很多通道都是饱和(发放太多)的或死亡(不发放)的,导致产生了太多冗余信号。这种现象主要在 MLP 层发现。
Feature cosine distance analysis
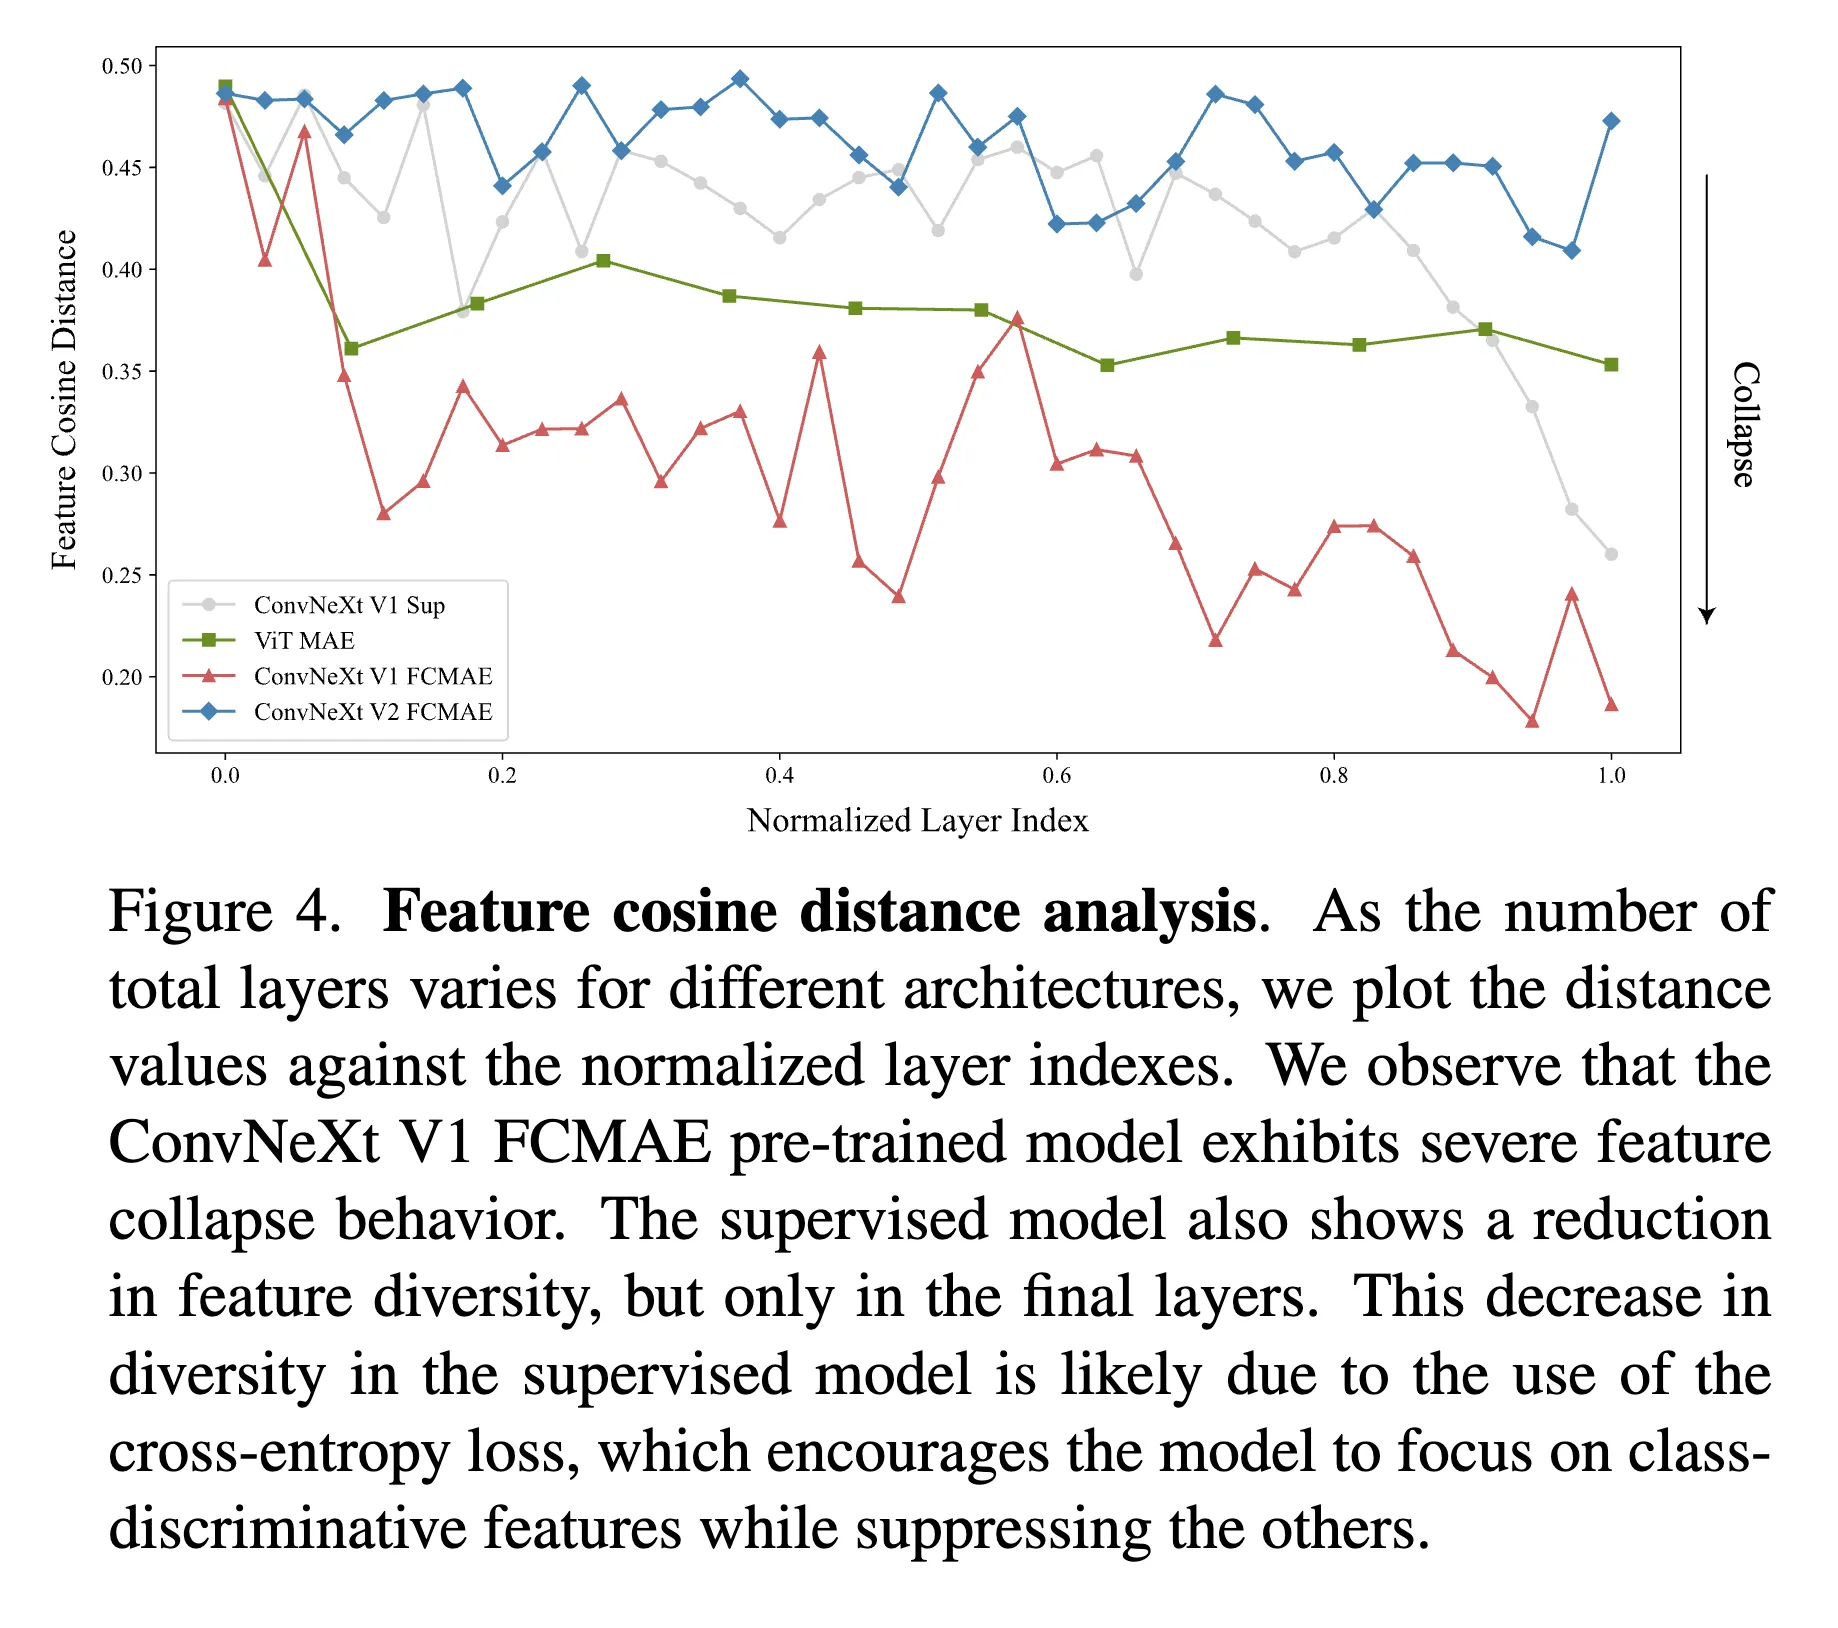
对 feature collapse 做定量的观察。给定一个 activation是第个通道。在通道之间计算 average pair-wise consine distance by ,更高的值说明 feature 之间有更多的 diversity。可以看到实验结果表明 V2 的 diversity 比 V1 更好,符合可视化中的 insight。
Approach
灵感来源于大脑的侧抑制机制。过程:
1. global feature aggregation
将聚合成一个 vector 通过:
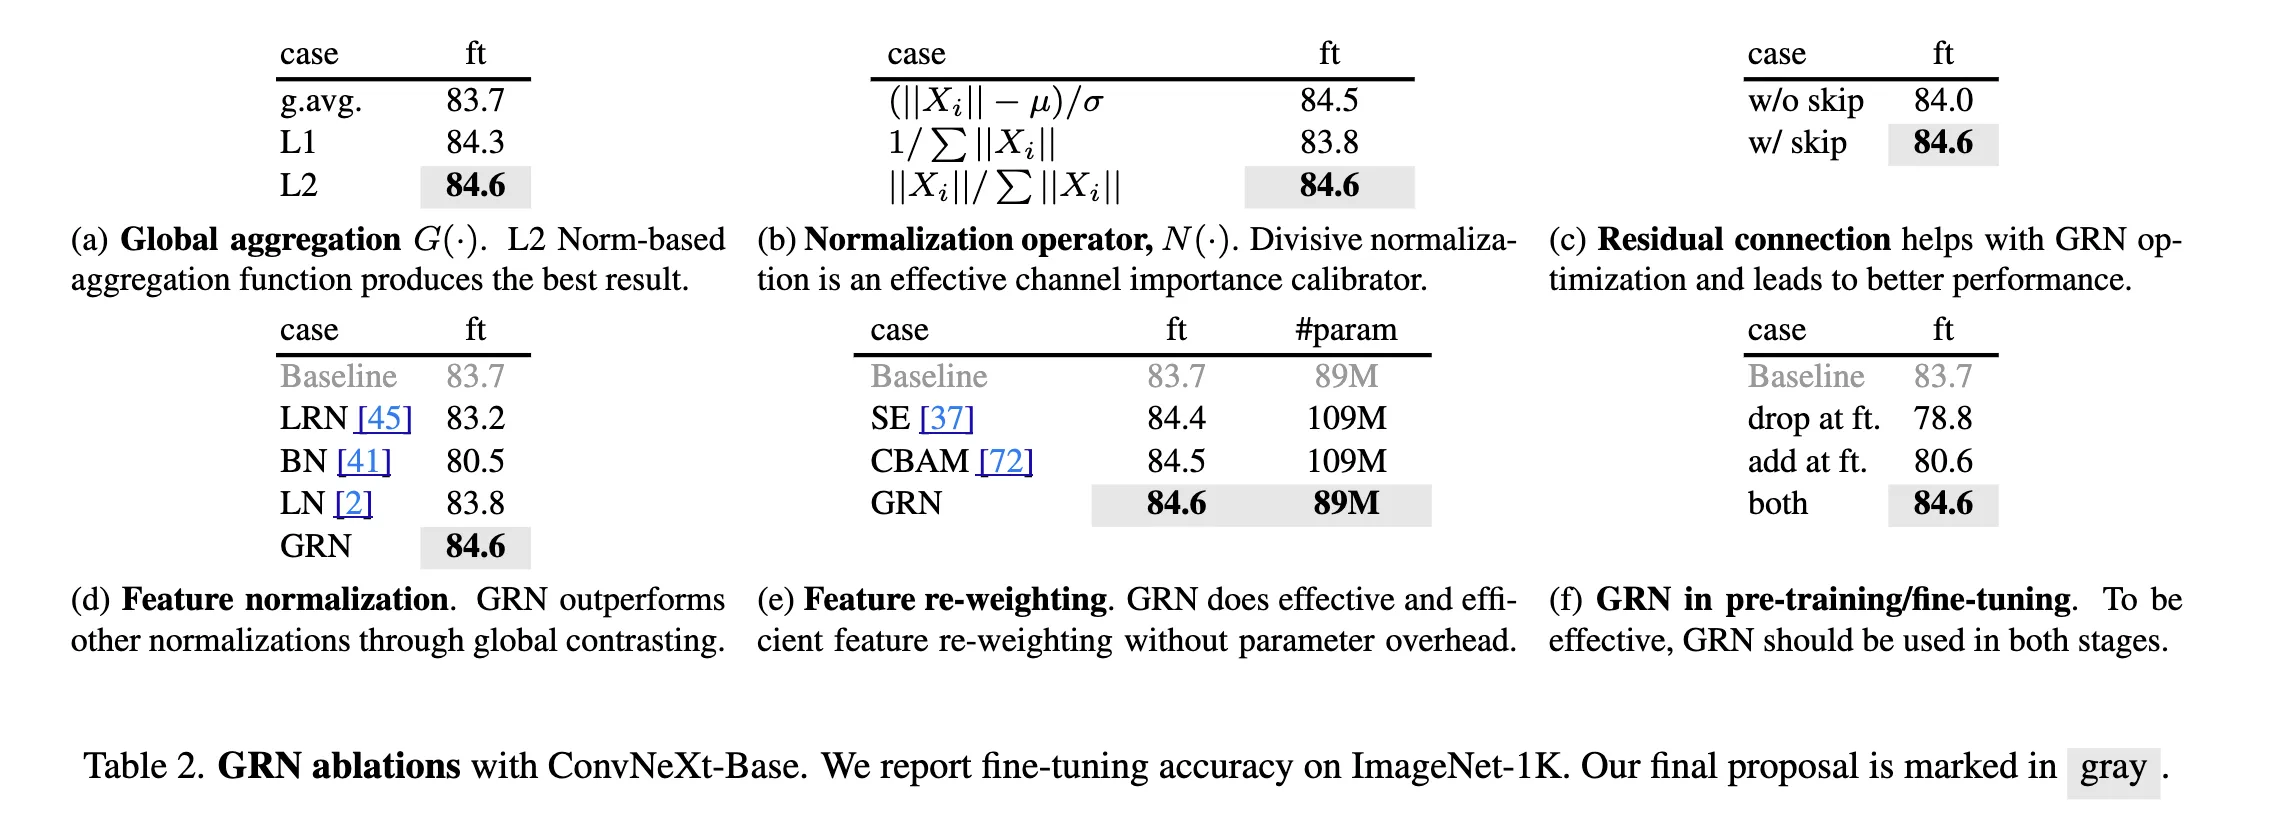
a 中尝试了不同的函数,最后采用了 L2 范数。
2. feature normalization
做归一化,b 中有不同的尝试,最后做了简单的除法归一化。
3. feature calibration
上面这个流程完全不需要学习,为了简化优化的过程还加入了两个课学习的参数,写作
两个参数一开始都设成 0。这种类似残差连接的设计让模型可以慢慢引入 GRN 层。
ConvNextV2
加入 GRN 就形成了 ConvNeXt V2 Block。
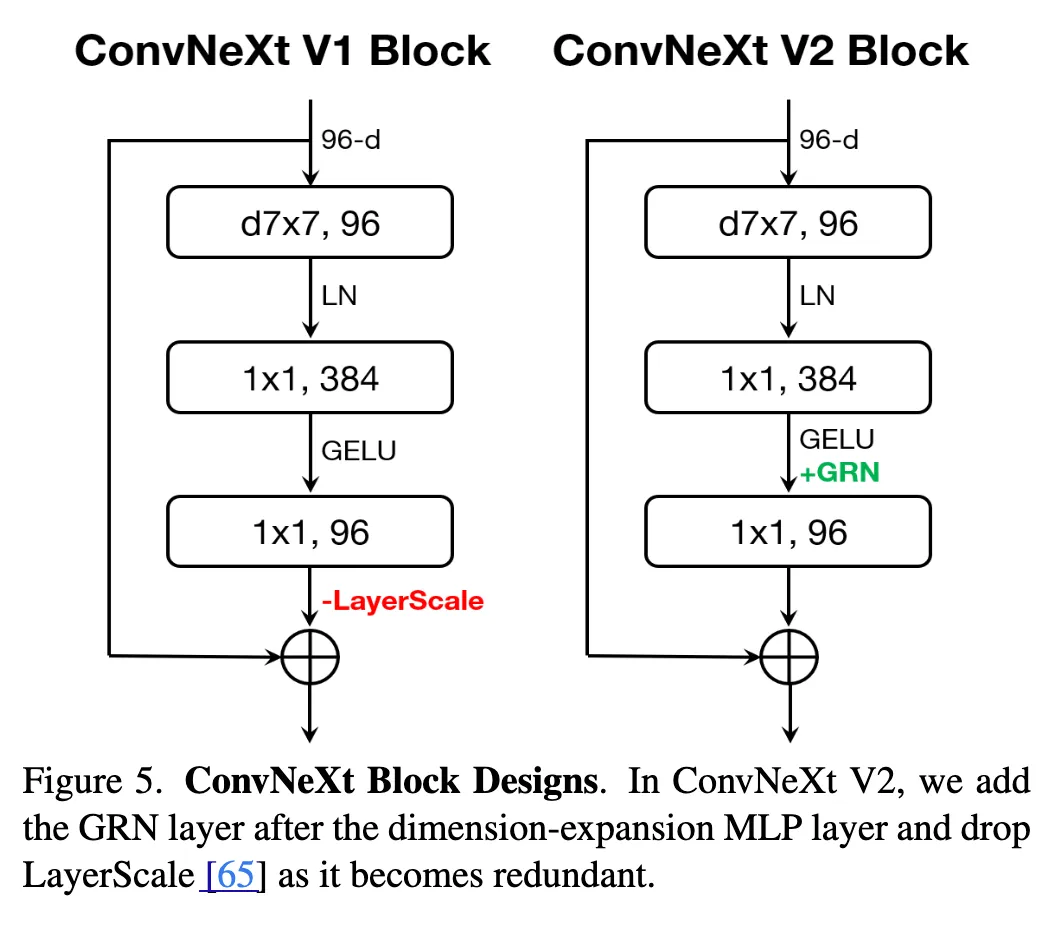
Impact of GRN
从上面那个 feature 余弦距离的图可以看出来。V2 + FCMAE 的精度继续提高到 84.6,超过了全监督的 baseline。
Relation to feature normalization methods
Table 2D。
Relation to feature gating methods
Table 2E。GRN 更简单。
The role of GRN in pre-training/fine-tuning
Table 2F。
5. ImageNet Experiments
Co-design matters
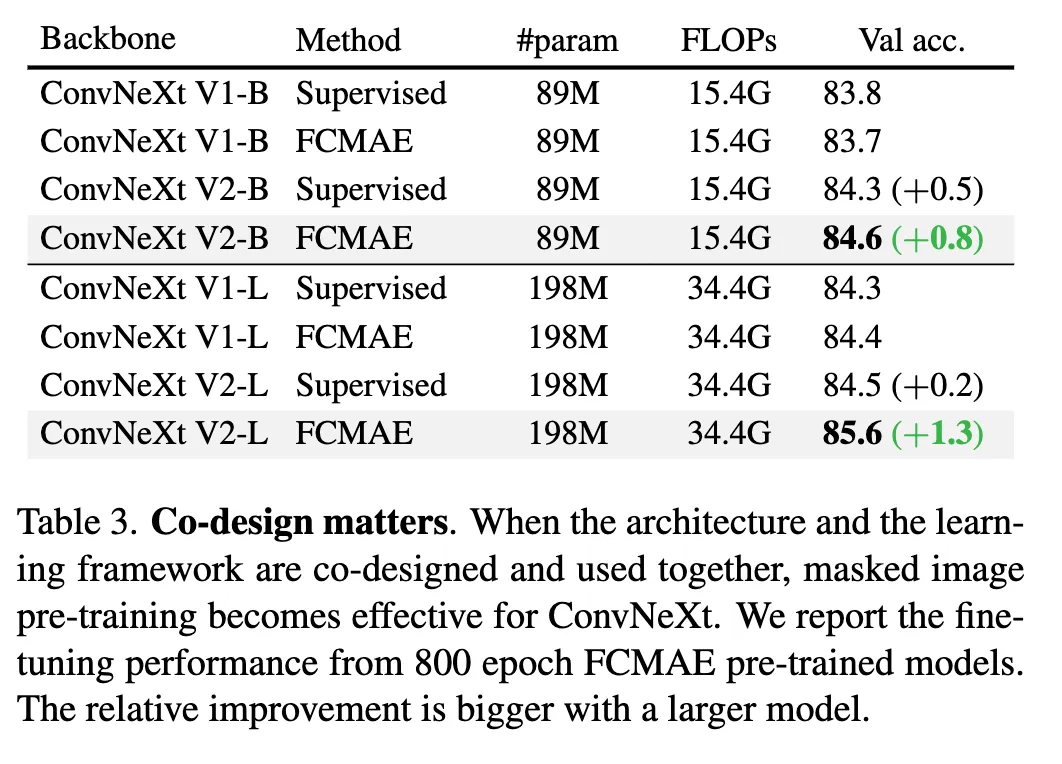
如果不修改网络的框架,直接做 MAE 没什么效果;如果只修改网络的框架添加 GRN 而不做 MAE,效果也不怎么样。这证明模型和学习的框架应当一起考虑。
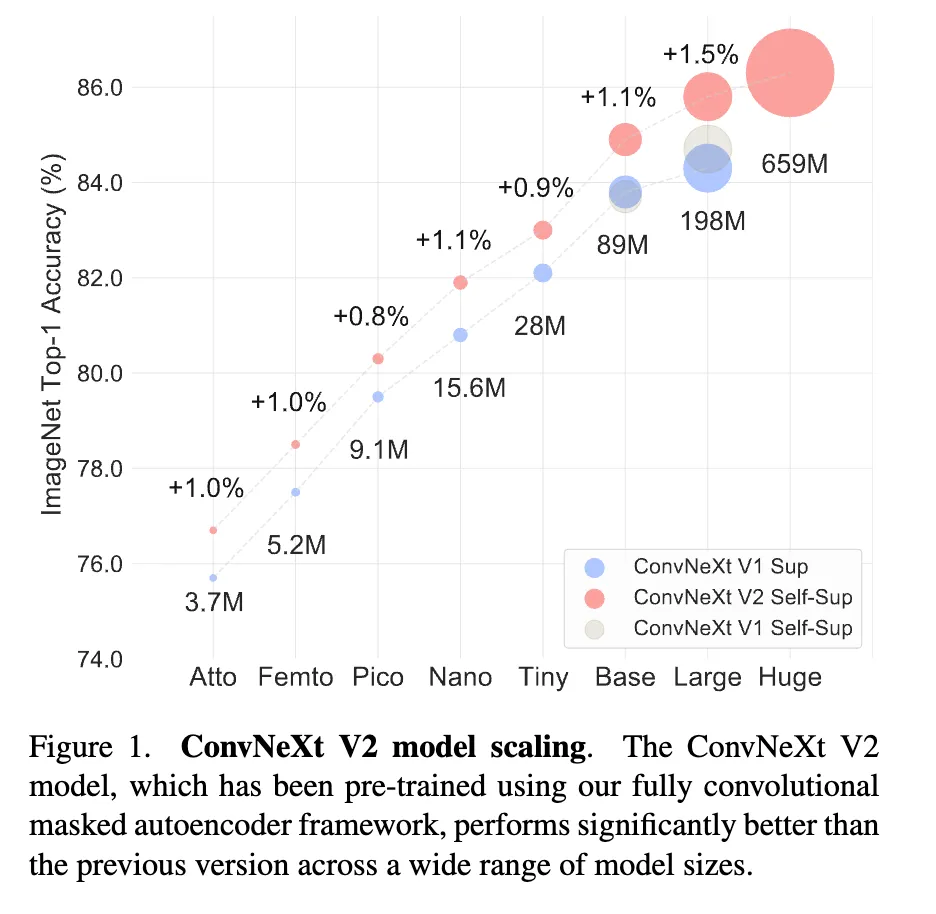
Model scaling
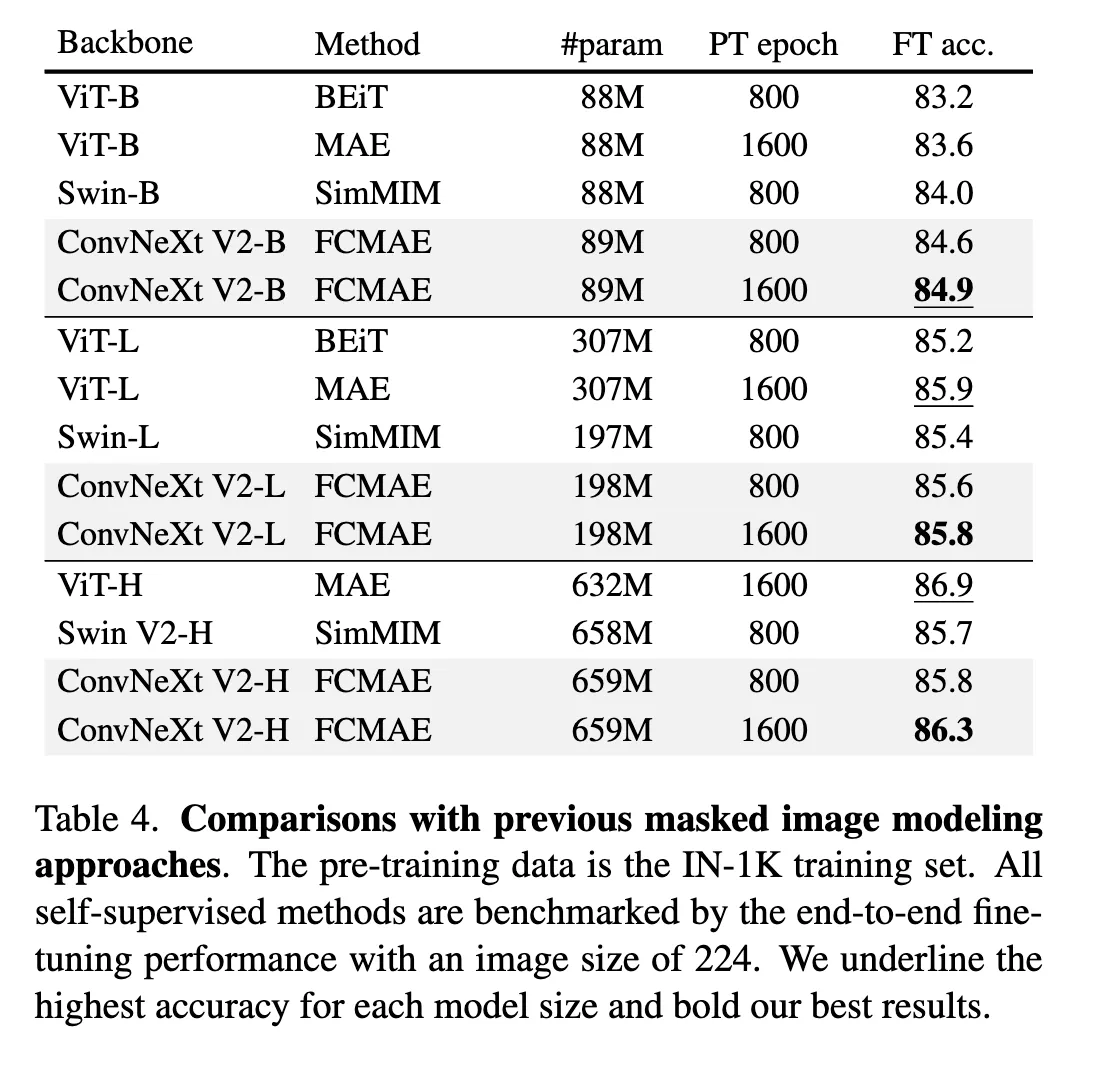
Comparisons with previous methods
绝对数值上和 ViT-H 这种超大模型还有差距,但是在后面可以看到如果做 finetune 这个差距就会缩小。
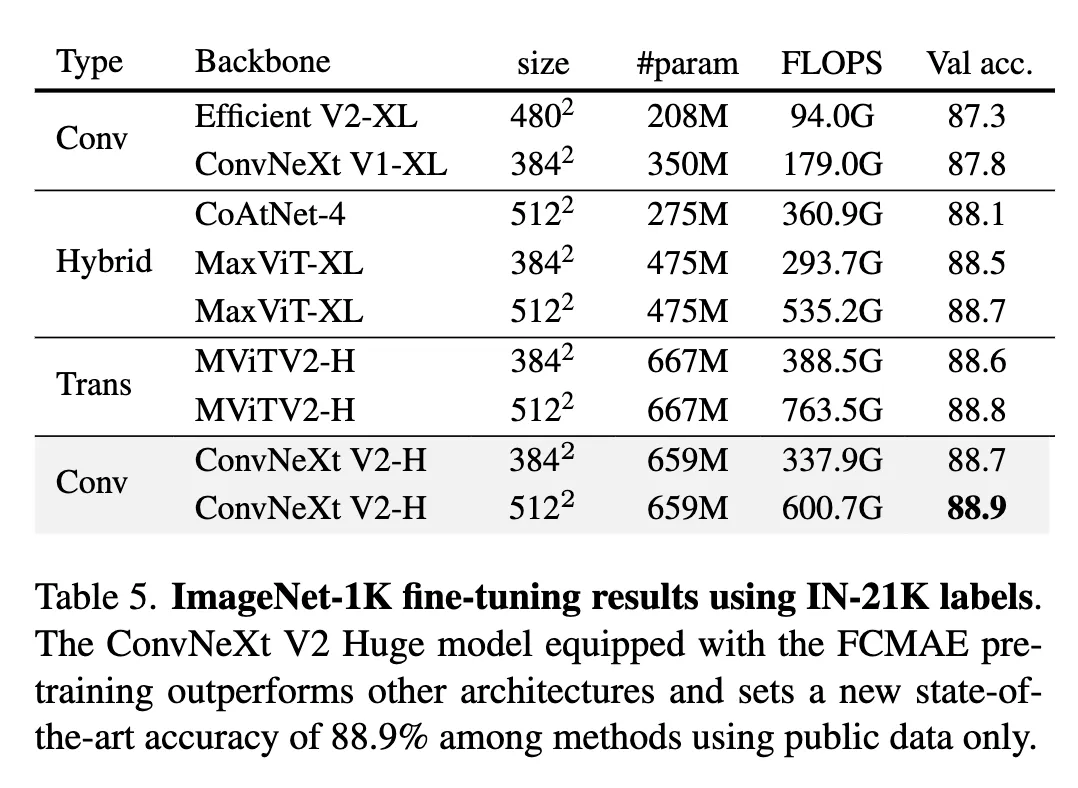
ImageNet-22K intermediate fine-tuning
我们的方法,使用基于卷积的架构,仅使用公开可用的数据(即 ImageNet-1K 和 ImageNet-22K)就创造了新的 state-of-the-art 准确率。
6. Transfer Leaning Experiments
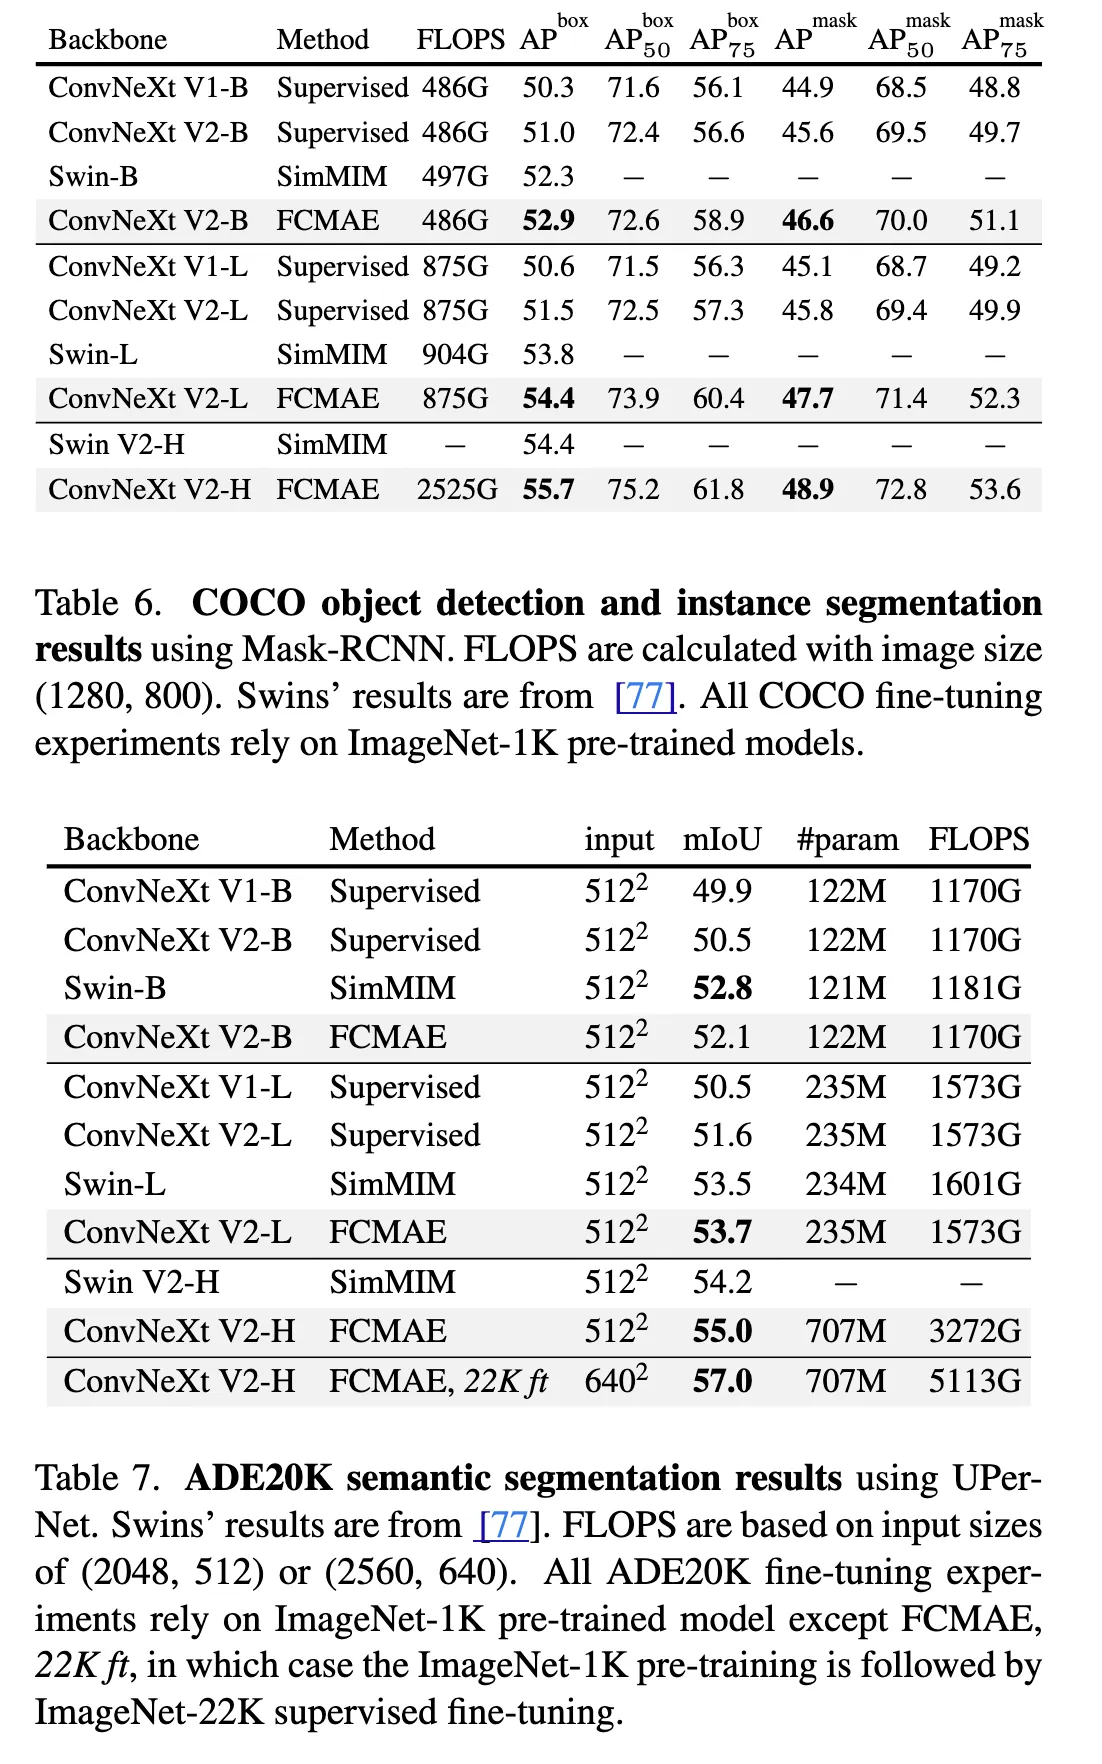
Object Detection and segmentation on COCO
Semantic Segmentation on ADE20K
和 ConvNeXt V1 的实验对齐。
7. Conclusion
在本文中,我们介绍了一个新的 ConvNet 模型家族,称为 ConvNeXt V2,涵盖了更广泛的复杂度范围。虽然架构变化很小,但它专门设计为更适合自监督学习。使用我们的全卷积掩码自编码器预训练,我们可以显著提高纯 ConvNets 在各种下游任务中的性能,包括 ImageNet 分类、COCO 目标检测和 ADE20K 分割。
没有 ConvNeXt V1 那么惊喜,小修小补的工作。关于 Training 和 Arch 需要一起设计的想法和师兄那边印证起来了。中间的操作适不适合 SNN 化,包括我在 Video Stream 上能不能做 MAE 都还需要思考。