原文:huggingface.co · DeepSeek-AI, 2026
摘要: 长程 agent 的普及让模型负载越来越偏向输入侧。此前的工作已经大幅降低了长上下文的计算开销,但 prefill 仍然很贵,庞大的 KV cache 也持续挤占 HBM、SSD 的容量和传输带宽,这些计算、存储、带宽上的需求是进一步降低部署成本的主要瓶颈。本文提出 DeepSeek-V4.1-Flash,一个 552B 骨干参数、支持 1M 上下文的多模态 MoE 模型。借助 Causal Encoder-Decoder(CED)结构,模型 decode 时每 token 激活 16B 参数,prefill 时只激活 8B。为了把 KV cache 压到极限,模型结合了 Compressed Sparse Attention 2(CSA2)里的跨层 KV 复用和 FP4 KV cache,把常驻 HBM 的 global KV 压到每 token 890 字节,约为 DeepSeek-V4-Flash 的 1/4;再通过部署侧的 SWA Bounded Replay,把常驻 SSD 或 host memory 的 persistent KV 压到 V4-Flash 的约 1/8。在 KV cache 小得多的情况下,模型效果明显好于基线。此外还精简了 V4 的结构,引入了几个高效的结构扩展。模型在 45T token 的多模态语料上预训练,并做了完整的后训练。
1. Intro
V4 的 attention 可以看成两个分支:每层都有的 SWA(窗口),加上一个看全上下文的 global 分支。global 分支把历史压缩成 main KV,再用一个轻量的 indexer 给每个 query 选 Top-K 条做稀疏 attention,main KV 和 indexer K 合起来就是报告里说的 global KV。SWA 的 KV 大小和序列长度无关,序列足够长的时候占 HBM 的主要是 global KV。另外为了 prefix 复用还有一部分 KV 要持久化到 SSD 或者 host memory 里(persistent KV),这部分还受 I/O 和互联带宽的限制。
这样一个长上下文请求的开销基本就是四块:
- prefill 的计算。agent 每次 tool call 回来都是一段新输入,cache miss 的部分要完整过一遍网络;
- 运行时常驻 HBM 的 global KV,决定单卡能同时挂多少条长会话;
- 落在 SSD/host memory 上的 persistent KV;
- decode 时随上下文长度增长的部分,有了稀疏 attention 之后主要就是 indexer 的打分。
原文的出发点是把 V4 看成 “SWA 的局部主干 + 压缩过的全局上下文”,所以这一版基本只动 global 分支,SWA 分支保持原样。后面的设计都能看到这个取向:CED 只改 global KV 的来源,CSA2 只共享 global KV 和 Top-K,FP4 也只用在 main KV 上。SWA KV 还是每层用自己的 hidden state 算、每层单独存、保持 FP8(原文说它对量化比较敏感)。
setup:
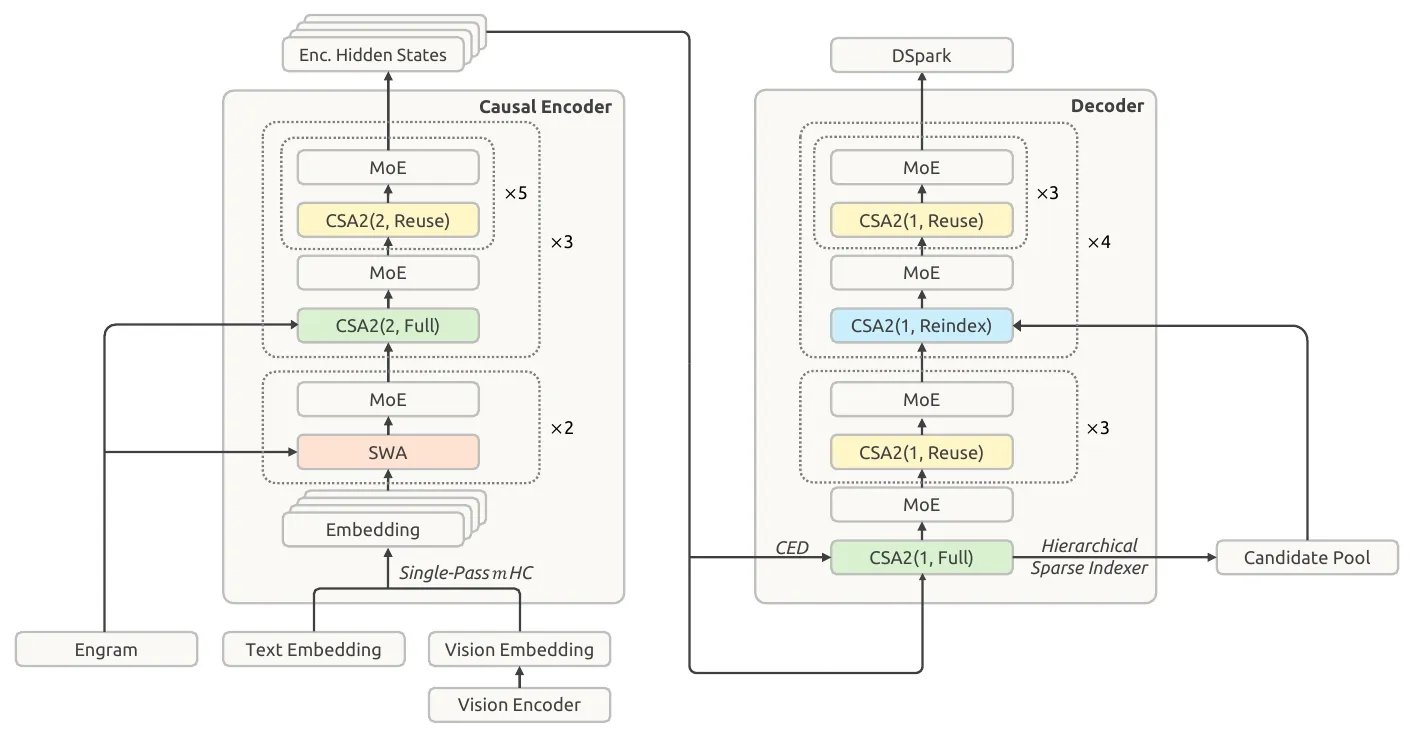
- 40 层,d=5120,encoder 20 层 + decoder 20 层,最底下两层只有 SWA
- 每层 MoE:1 shared + 384 routed,top-6,expert 中间维 2304,SwiGLU 带 clamp(阈值 10)
- attention:64 个 query head,head dim 512,query 低秩维 1280,KV latent 512 维,output projection 分 8 组、每组 1024 维
- indexer:32 head,head dim 128,attention top-k 512;层级索引最多选 2048 个 block,每个 block 8 个位置
- mHC 扩展因子 n=4,Sinkhorn-Knopp 迭代 20 次
- ViT:32 层、1024 维、16 head、patch 14、2D-RoPE,后接 3×3 pixel-unshuffle 和 2 层 MLP projector
- 参数量:骨干 552B + Engram 196B,prefill 激活 8B、decode 激活 16B。粗算一下骨干里大概 545B 都在 expert 里(40×385×3×5120×2304)
2. 890 bytes/token
作者把 KV 的开销拆成三个相乘的维度:entry 本身的大小(GQA 减 KV head、MLA 让所有 head 共享一个小 latent 都算这一类)、序列维(每个 token 压成一条 entry)、层维(一部分层不存自己的 KV,用别的层的)。写成式子是
entry 大小:main KV 是 512 通道的 latent,存成 E2M1,每 16 个通道带一个 1 字节的 E4M3 scale,
折合每通道 4.5bit。indexer K 是 128 维的 MXFP4,每 32 个元素一个 E8M0 scale,64+4=68B。合起来一条 entry 是 356B。
层的排布:
- encoder:2 层纯 SWA 之后分 3 组,每组 1 个 Full + 5 个 Reuse,压缩比;
- decoder:5 组每组 4 层,第 1 组是 1 个 Full + 3 个 Reuse,后面 4 组是 1 个 Reindex + 3 个 Reuse,。
三种模式只有 Full 层会产生 KV,所以(从 0 开始数):
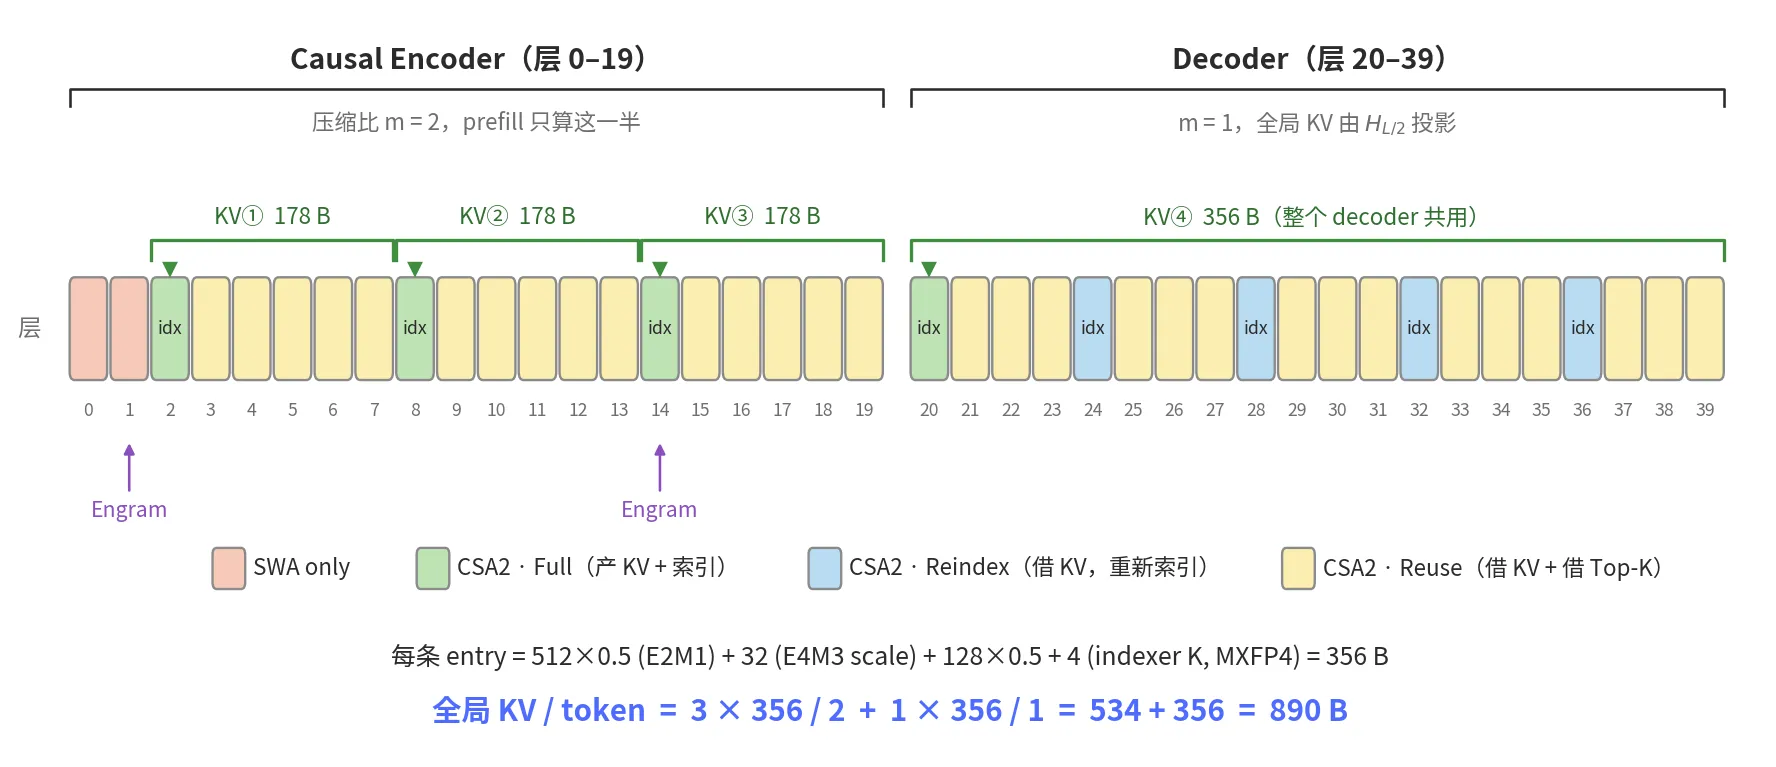
indexer K 这部分(单 head 128 维、每 32 个元素一个 scale)是我参考 V3.2 和 V4 的做法补的,报告里没有逐项列出来,不过最后的结果和 890 完全对上了。同样的算法也能对上报告 Figure 1 (b) 里 V1 和 V3.2 的数字:
| 模型 | 算式 | B/token |
|---|---|---|
| DeepSeek-V1 (67B) | 95 层 × 2(K 和 V)× 8 个 KV head × 128 维 × 2B(BF16) | 389,120 |
| DeepSeek-V3.2 | 61 层 × [(512B FP8 latent + 16B scale + 128B RoPE 分量) + (128B indexer K + 4B scale)] | 48,068 |
| DeepSeek-V4-Flash | 报告给的数 | 3,514 |
| DeepSeek-V4.1-Flash | 见上 | 890 |
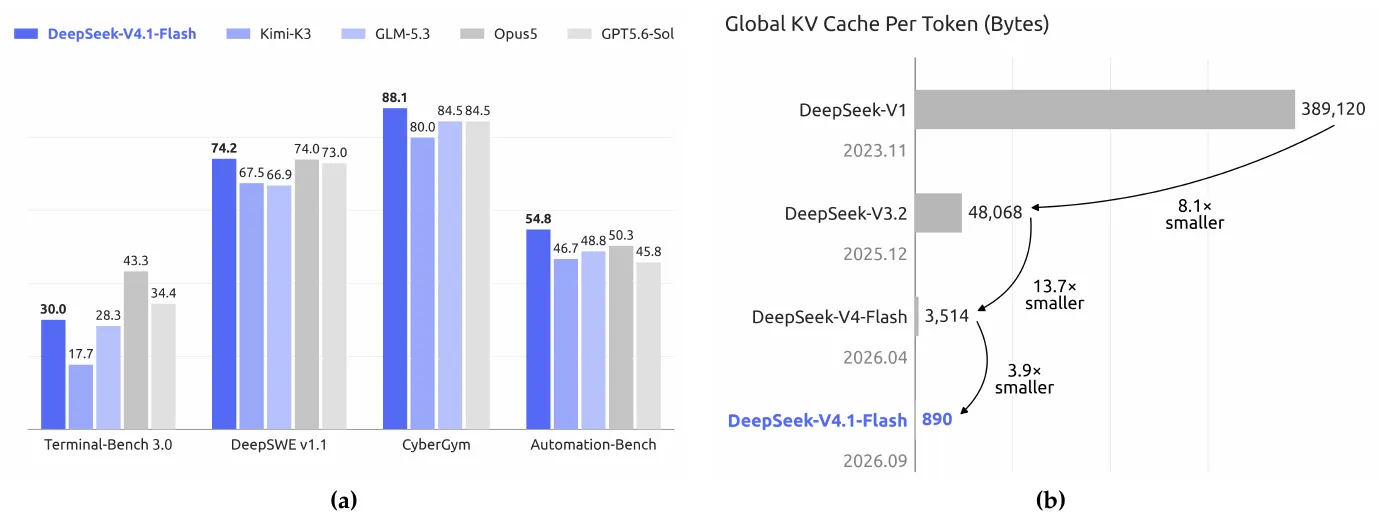
按这个数字,1M 上下文的 global KV 只有 890MB,V3.2 同口径下是 48GB。另外 decoder 这边,这份 KV 在序列维上完全没有压缩,890 里面有 356 是它占的,可能的原因放在 4.2 讨论。
3. Causal Encoder-Decoder
3.1. CED
CED 把底下层当作 causal encoder,上面层当作 decoder。decoder 各层的 global KV(以及压缩用的权重)不再从本层的 hidden state 来,统一从 encoder 最后一层的输出投影:
SWA 分支不变,每层的 local KV 还是从本层的算。这两点放在一起,prefill 和 decode 的数据流就不一样了:
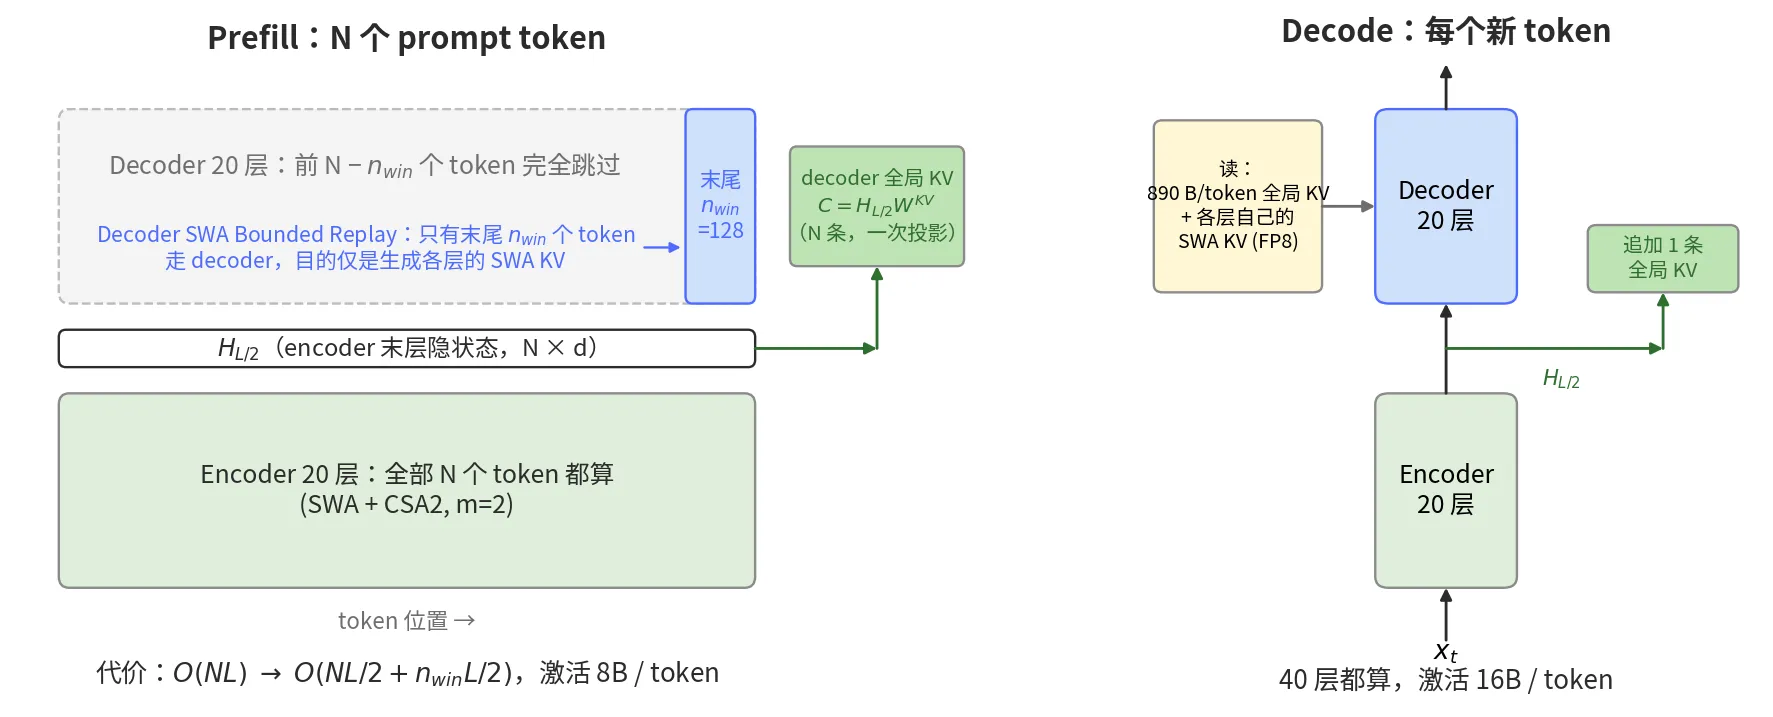
prefill 的时候 decoder 需要的 global KV 只依赖,所以 prompt 里除了最后个 token 之外都不用进 decoder;decode 的时候每个新 token 要走完 40 层,同时把自己的投影成一条新的 global KV。时 prefill 复杂度从变成,基本减半。所谓 prefill 激活 8B、decode 激活 16B 也是这么来的,参数是同一套,prompt token 只过了一半的层。
3.2. CED vs. YOCO
报告里只说了 “做了一系列结构上的改进来提升 KV cache 容量和 KV 生成的计算深度”,没有逐条展开。对照 YOCO 原文看下来,区别大概是三点:
- encoder 自己也有 global attention。YOCO 的下半部分只用 local/linear attention,全网只有一份 global KV;CED 的 encoder 里有 3 个 Full 层各存一份,加上 decoder 一份一共 4 份;
- decoder 每层保留自己的 SWA KV,local 信息还是随深度逐层生成的,代价是 decoder 的 SWA 状态在 prefill 结束的时候需要补算(3.3);
- 式 (1) 里的投影是逐层的,不过和 CSA2 叠在一起之后,decoder 里真正执行式 (1) 的只有第 20 层这一个 Full 层,剩下 19 层都复用它的结果。
3.3. Decoder SWA Bounded Replay
decoder 的 SWA KV 是不进 cache 的,但 decode 的头几步又要用。精确重建的话需要让个 decoder 层跑最后个 prompt token(SWA 的依赖每过一层向前扩一个窗口),在 “很长的 cached prefix + 很短的新输入” 这种多轮场景下,这部分比新输入本身还贵。作者引了 PowerAttention22的结论,SWA 实际的有效感受野远小于理论值,于是只重放最后个 token,attention 窗口在重放段的起点截断。作者称对效果的影响可以忽略,保险起见后训练的时候也模拟了同样的 replay 过程让模型适应。encoder 那边还有一个同名的机制,放到第 6 节一起说。
4. Compressed Sparse Attention 2
4.1. 单层的计算
单层的计算:
其中 block 不重叠、indexer K 从 main KV 投影、top-k 取 512、窗口 128 是报告里明确写的;序列压缩用 softmax 加权、打分用多 head 的 ReLU 加权和,这两个具体形式是沿用 DSA/V4 的写法,本文没有重写,算是我补的。
相对 V4 的 CSA,单层内有三处简化:
- V4 里压缩比为时每条 entry 由个原始 entry 产生,相邻 entry 的来源有重叠,还要加绝对位置编码来区分这个位置,CSA2 把重叠和绝对位置编码都去掉了;
- V4 的 indexer K 走一条从 hidden state 出发的独立压缩路径,CSA2 直接从 main KV 投影;
- V4 是 CSA 和 HCA(Heavily Compressed Attention)混用,V4.1 只用 CSA2,就是不压缩的特例。
4.2. Full, Reindex, Reuse
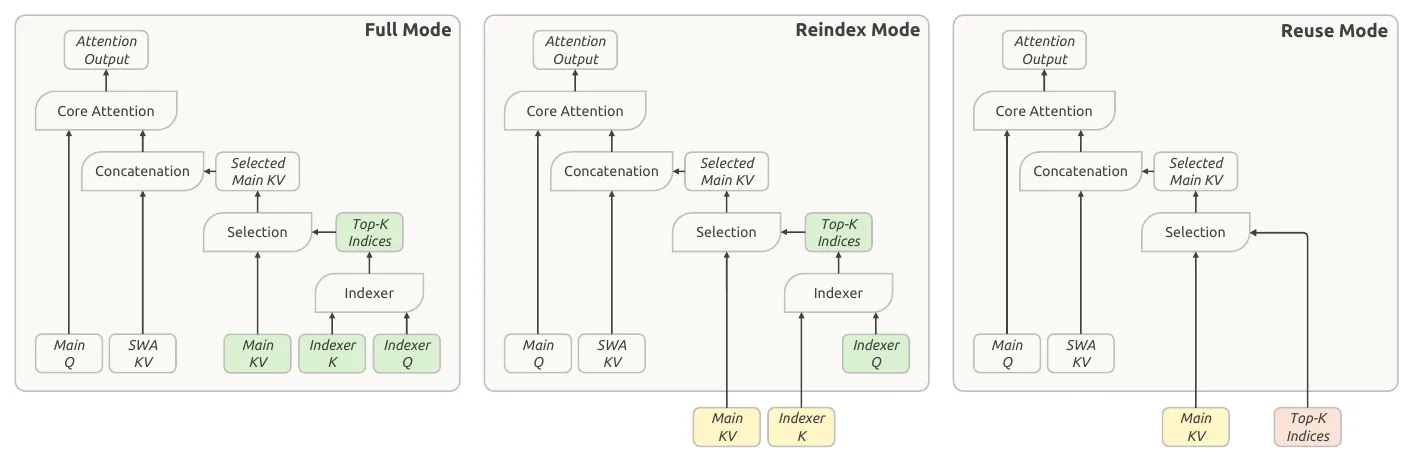
每个 CSA2 层静态地被指定为三种模式之一。三种模式都自己算 main Q 和 SWA KV,区别在 main KV、indexer K 和 Top-K indices 从哪来。记为第层之前最近的 Full 层,为最近的 Full 或 Reindex 层:
| 模式 | main KV、indexer K | Top-K indices | 新增 KV 存储 | indexer 计算 |
|---|---|---|---|---|
| Full | 本层产生 | 本层打分 | 有 | 有 |
| Reindex | 无 | 有 | ||
| Reuse | 同上 | 无 | 无 |
38 个 CSA2 层里 4 个 Full、4 个 Reindex、30 个 Reuse,真正产生 KV 的只有 4 层,跑 indexer 的只有 8 层。占绝大多数的 Reuse 层推理时每层只有 15 个 kernel(prefill)/ 11 个 kernel(decode)。
encoder 是 “3 份 KV + 3 次 index”,decoder 是 “1 份 KV + 5 次 index”,报告没有解释为什么这么排。我的猜测是 encoder 的 hidden state 随深度在变,第 2、8、14 层各自重新产生 KV 能拿到不同层次的表示,每份 178B/token 存下来是划算的;decoder 受式 (1) 的限制,任何一层的 global KV 都只能投影同一个,多存几份也只是同一份信息的不同线性变换,意义不大。但 decoder 各层的 query 还是随深度变化的,让 Reindex 层用新的 query 在同一份 KV 上重新选一遍就比较划算。decoder 取大概也是这个原因,整个上半网络的全局信息都压在这一份 KV 上,再压序列维损失就比较大了。
4.3. Hierarchical Sparse Indexer
跨层复用减少了 indexer 跑的次数,但每次还是要扫整个可见上下文,上下文特别长的时候这仍然是主要的计算瓶颈。作者发现在 decoder 里,浅层 indexer 的结果可以直接拿来限制深层 indexer 的搜索范围,不需要引入额外的状态。
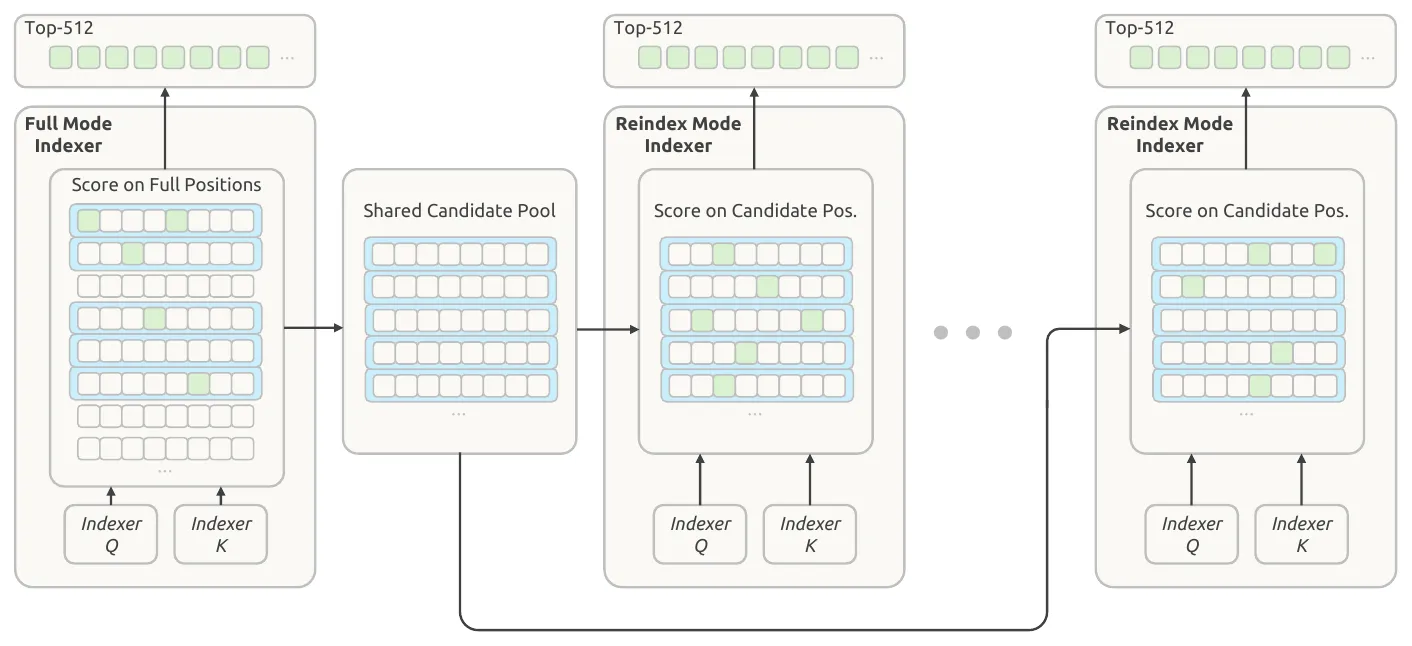
decoder 的第一个 Full 层照常对全部可见位置打分、选出自己的 Top-512,同时按 block 取最大分数,选出分数最高的一批 block 组成 candidate pool,后面的 Reindex 层只在 pool 里打分:
candidate pool 是各个 Reindex 层共用的,每层在 pool 里最后选出来的 Top-512 可以不一样。这个机制只用在 decoder 上,并且是后训练阶段才加进去的,训练和推理用同样的候选限制。
4.4. Decode FLOPs
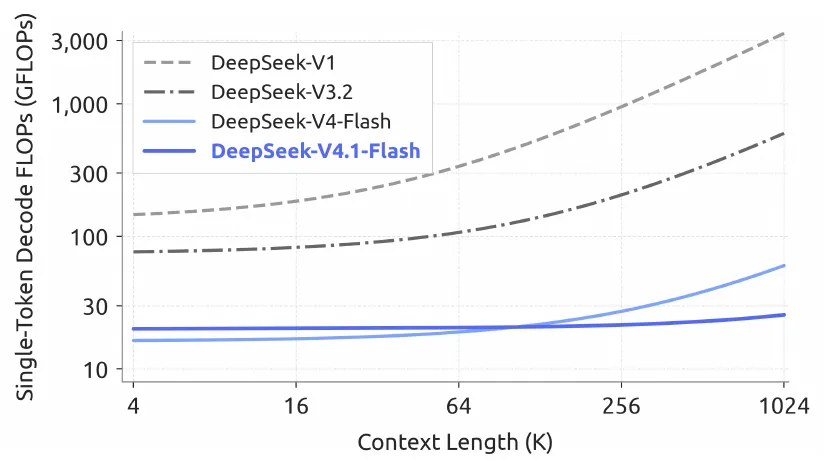
报告 Figure 2 里,上下文从 4K 到 1M(256×),单 token 的 decode FLOPs 只涨了大约 1/4(BF16、FP8、FP4 分别按 1、0.5、0.25 加权)。这个 1/4 也可以估出来。decode 时每个新 token 要过全部 40 层,4 个 Full 层的 indexer 要对所有可见 entry 打分,4 个 Reindex 层只对 16,384 个候选打分,每对 (query, entry) 的打分是 32×128=4096 次乘加:
=1M 的时候是 10.2G 次乘加,折合 20.5 GFLOPs,按 FP4 的 0.25 加权之后大约 5.1 GFLOPs,和图上从 20 左右涨到 25 左右基本吻合。顺着这个估算还能看到几件事:
- 线性项的系数同样来自 3/2+1=2.5 个 “等效全量层”,和 890 的来源是同一个;
- 如果没有 Hierarchical Indexer,4 个 Reindex 层也要扫全量,系数从 10,240 变成 26,624,1M 处的增量会是 13 GFLOPs 左右;
- 上下文在 100K 以内的时候,图上 V4.1-Flash 的 decode FLOPs 其实比 V4-Flash 还高(约 20 vs. 约 17 GFLOPs,激活 16B vs. 13B),短上下文 decode 这块 V4.1 是没有优势的;
- encoder 在 prefill 时的 indexer 还是的:3 个 Full 层、个 query、平均条 entry,大约次乘加。同样的加权口径下(粗略假设主干计算全按 FP8 算),1M 时大概占 prefill 主干计算的 15%~20%,256K 时 5% 左右。这个数只能看个量级,Hierarchical Indexer 没有覆盖到这一块。
5. FP4 Main KV Cache
V4 已经对 indexer 的 Q/K 做了 FP4 的 QAT,用的是 OCP 标准的 MXFP4。作者的解释是 indexer 的 FP4 要直接参与矩阵乘,得照顾尽可能多的硬件,所以即使实验里别的格式精度更高也还是选了标准格式。V4.1 把 QAT 扩展到 main KV,这里 FP4 只是为了省存储,cache 在进 attention 之前先反量化,所以可以挑精度更高的格式,不要求硬件原生支持这个格式的矩阵乘。
最后选的是 E2M1 + 每 16 通道一个 E4M3 scale,和 NVFP4 一样,只是去掉了第二级的 global scale。对一个 16 通道的块:
能表示的最大幅值是 448×6=2688。去掉 global scale 的依据是一个范围估计:训练完 RMSNorm weight 的最大幅值大约是 1,512 维 latent 过完 norm 之后;RoPE 是旋转不改范数,旋转之后单通道幅值也不超过 22.6;训练中实际观察到的最大值在 10 左右,离 2688 差两个数量级。
其他细节:QAT 是后训练阶段才加的;RoPE 和非 RoPE 分量用同一种格式;量化放在 RoPE 之后(放在之前只有很小的精度收益,但 decode 会多出开销);SWA KV 保持 FP8。相比 V4 的 FP8 main KV,存储接近减半。
有一处前后说法不太一致:摘要和 intro 里说训练时使用 FP4 global KV cache,2.4.4 里写的是 main KV 的 QAT 在后训练才引入,按后者的话 45T 的预训练期间 main KV 并不是 FP4。
6. Persistent KV Cache & SWA Bounded Replay
V4 线上用 LRU 管理 SSD 上的 persistent KV cache,容量配到典型负载下两类 KV 都能留存 72 小时以上。其中 SWA KV 只在 prompt 末尾和输出末尾两个位置存快照(用于 regenerate 和多轮续聊),即便如此,未压缩的 SWA KV 还是占了 persistent cache 接近一半的容量,多轮短对话的时候更严重。
问题在于两类 KV 的复用模式完全不同:global KV 是长尾复用,几小时几天之后还会命中;SWA KV 只在活跃 session 内分钟级的窗口里被复用,session 结束或者下一轮开始之后就是死数据了。用留存 72 小时的 SSD 去存寿命只有几分钟的数据显然不划算。V4 的报告里提过 Zero SWA Caching(不存,丢了就重算),但精确重算需要 replay 个 token,线上证明太贵了。
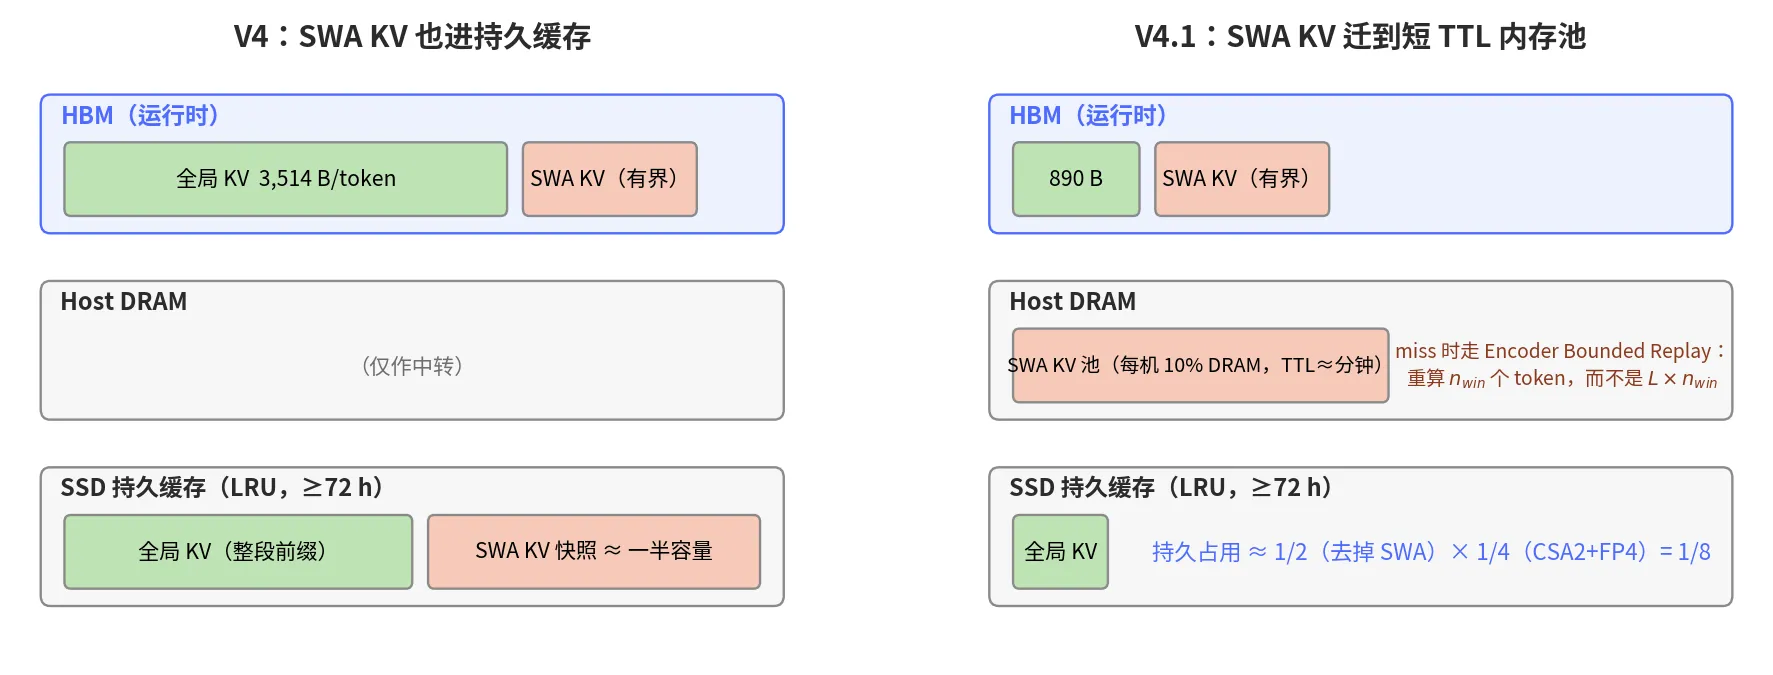
V4.1 的做法是把 SWA KV 从 persistent cache 里拿出来,放进一个由每台机器 10% 的 host DRAM 组成的分布式内存池,TTL 只有几分钟。池子总容量虽然小,但周转很快,作者说真实负载下足够服务绝大多数并发的活跃 session。global KV 还留在 persistent cache 里,保证至少 72 小时。这样 persistent KV 就是 1/2(不存 SWA)× 1/4(CSA2 + FP4)= 1/8。
SWA KV 被淘汰之后必然会出现 “global KV 命中但 SWA KV miss” 的请求,这时候靠 Bounded Replay 来补:
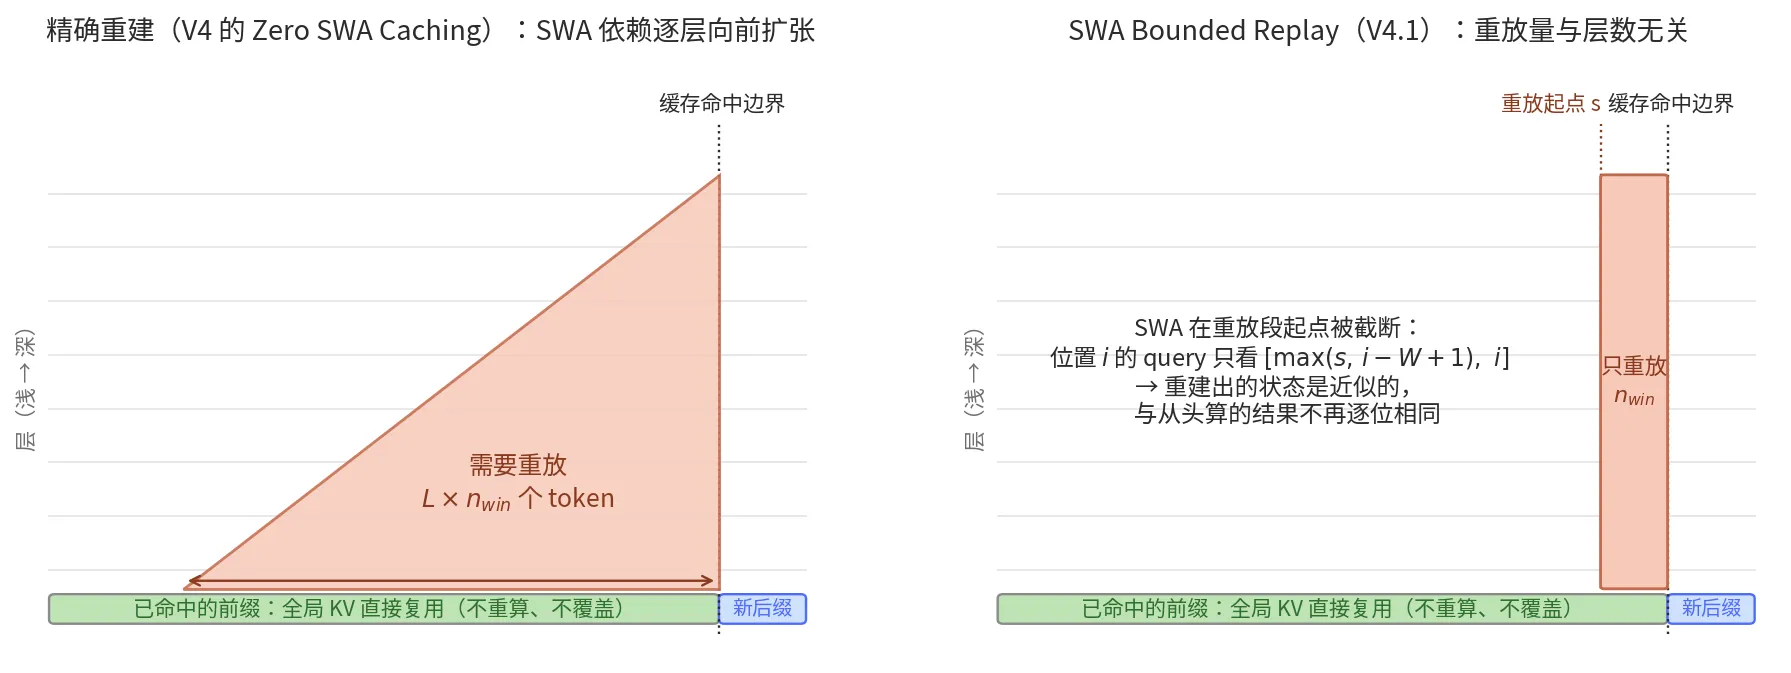
SWA 的依赖每过一层向前扩一个窗口,精确重建层需要 replay 个 token。Bounded Replay 只 replay 最近的个,并且把 SWA 截断在 replay 段内,从位置开始 replay 的话,位置的 query 只看。有两个变体:
- Encoder SWA Bounded Replay:replay cached prefix 的最后个 token,和没 cache 的后缀一起处理。replay 的 token 只重新生成 SWA KV,global KV 直接复用、不重算也不覆盖,于是 prefix caching 只依赖 global KV;
- Decoder SWA Bounded Replay:每次 prefill 都做(3.3),产生的 decoder SWA KV 只给后面的 decode 用,不进 prefix cache。
作者也说明了这样做的后果:replay 出来的 prefix 状态是近似的,所以后缀算出来的 global KV 和 SWA KV 依赖于 cache 命中的位置,不同命中位置下在数学上并不相同。换到使用者的角度,同一个 prompt 同一组采样参数,服务端有没有走 replay 会让 logits 有细微差别,做评测复现或者 logprob 对比的时候需要留意。作者在 limitation 里也把 “cache 恢复边界上的 SWA 状态重建” 列成了需要继续压测的两个点之一,另一个是 CSA2 在长上下文上的选择误差。
7. Efficient Architectural Extensions
7.1. Single-Pass mHC
其中把条 stream 混成 block 的输入,和负责更新 stream,三者都是逐 token 预测出来的系数。
从访存上看,两个 block 之间理想的变换是一个映射,读、写,下界是。而 V4 的实现是三个因为数据依赖必须串行的 kernel:
加上里的 pre-norm,总访存是,是下界的两倍(intro 里说的 “原来的四 kernel 实现” 就是这三个加 pre-norm)。
优化分两步。第一步不改数学:把里 norm 的 weight 离线折进 projection weight,RMS 的除法挪到 projection 之后,这样 residual update 和系数预测就能共用一次遍历,的每个 tile 算出来之后立刻累加进 projection 的输出和平方和。但 input mixing 融不进来,因为要等所有 tile reduce 完才有,只能再读一遍,这时候总访存是。
第二步改了数学,让每个 block 用上一个 block 产生的 mixing 系数:
这样依赖就没有了,的每个 tile 可以同时拿去做 input mixing(用现成的)和系数预测的累加。部署用的 Mega-mHC kernel 把 residual update、input mixing、系数预测、pre-norm 和 FP8 转换全融在一起,residual 只读一次写一次,达到的下界。
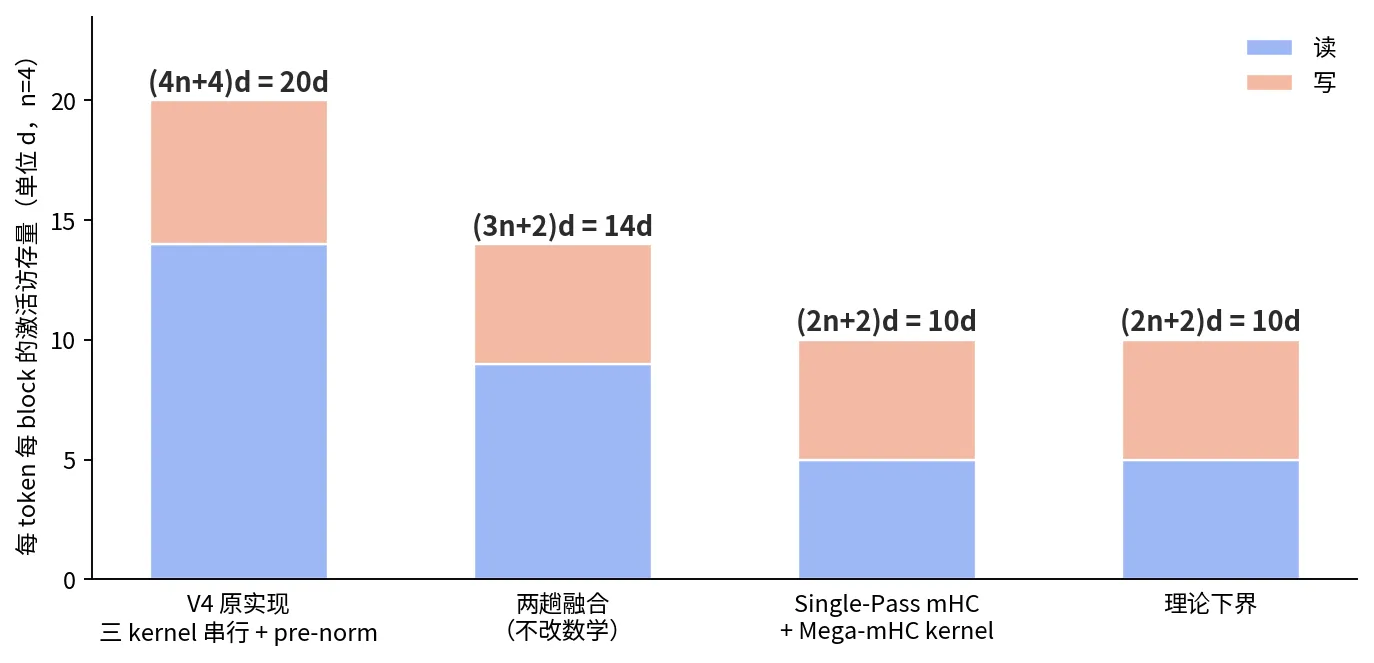
预训练还是用原来的多 kernel 实现(错位只改变用哪一份系数,不影响实现),作者称错位带来的性能损失可以忽略。第 0 个 block 用什么当报告里没有说。
7.2. Engram
配置上是两个 module,放在第 1 层和第 14 层(从 0 开始数,这么放是为了均衡各个 PP stage 的内存)。每个 module 用 2/3/4-gram,每阶 8 个 hash head、embedding 总维度 2048,每个 head 对应一张约 16M 行的表,表长取互不相同的质数,表和 K/V projection 都是 FP8。参数量可以对一下:2×3×8×16M×(2048/8)≈196.6B。
按原论文的结构,计算过程大致是下面这样(记号是自己整理的,gating 的具体形式是凭印象写的,可能和原文有出入):
寻址是确定性的,只依赖输入的 token 序列,系统实现上基本都在利用这一点。推理时表放在 host memory 里,通过后台 RDMA 预取,第一个 module 的预取和第一个 Transformer block 的计算 overlap。训练时表按行切到专门的 engram parallel 进程组,整个 local batch 的预取在 pipeline 开始处理 microbatch 之前就发起,梯度回传和 ViT 的 backward overlap。RL rollout 的时候表常驻 GPU 显存,避免 host memory 碎片导致 OOM。
报告里没有去掉 Engram 的对照,能参考的只有 base 评测里的 SimpleQA-Verified:V4.1-Flash 42.3,V4-Flash(284B)30.1,V4-Pro(1.6T)55.2。
7.3. DSpark
DSpark99是 speculative decoding 模块。V4.1 的骨干预训练不再带 MTP(报告里对比的是 V3 的做法,MTP 在预训练里和骨干一起训)。drafter 是 3 个 Transformer block(滑窗 128),一次 forward 并行给出 5 个 draft 位置的 base logits,再用一个轻量的 Markov head 建模 draft token 之间的依赖;另外有一个 confidence head 预测每个位置的条件接受概率,scheduler 结合这些概率和离线 profile 出来的引擎吞吐曲线,给每个请求动态选 verify 长度。
报告里只有文字描述,这里按自己的理解把 scheduler 的目标形式化一下,细节应该以 DSpark 原文为准。设是请求的第个 draft 在前面都被接受的条件下被接受的概率,prefix 存活概率,verify 长度取时期望产出个 token,scheduler 求解
是当前负载下单步时延关于 batch 内 token 数的实测曲线。系统空闲的时候多 verify 几个 draft 几乎没有成本,负载高的时候每多 verify 一个 token 都在挤别的请求的吞吐。
训练上,预训练结束之后单独开一个阶段,冻结骨干只训 DSpark;后训练期间 DSpark 跟着骨干一起训,但 DSpark 目标的梯度不回传骨干。这样 DSpark 能一直跟上 policy 的变化,线上服务和 RL/OPD 的 rollout 都用它加速。
8. Optimization
第一处改动是 head-wise Muon,把 Query 和 Key 的 weight 按 head 切开再分别做 Muon update。作者的解释是把 Muon 看成 preconditioned GD 的话,原版对所有 head 共用一个 preconditioner,按 head 切开之后每个 head 一个,更能适应 head 之间的异质性,并且提到 GLM-5 和 Kimi-K3 也验证了这一点。
第二处是针对 Engram 的。196B 的新增参数如果用 Adam,optimizer state 要多两份。作者对 Engram table、token embedding 和 LM head 统一换成了 momentum + Sinkhorn balancing,流程和 Muon 一样,只是把 Newton-Schulz 正交化换成了行列交替归一化,只需要一个 momentum buffer:
收敛的时候相当于找到对角阵、,让的行 RMS 和列 RMS 都约等于 1(报告式 7)。超参:(取奇数让最后一步落在行归一化上)、、(对齐 Adam 的 update 幅度,和 Moonlight 用的 0.2 接近)、不加 weight decay、Engram 的 lr 乘 5。
关于为什么这种 update 适合 embedding 类的矩阵报告里没有展开,我的理解是这类矩阵一行对应一个 token 或者一个 n-gram,一列对应一个 feature,各行梯度出现的频率差别很大。行归一化让当前 step 出现过的 token 不管频率高低都走一个单位 RMS 的步长,效果上接近 Adam 的逐行自适应,但不需要二阶矩的状态;列归一化再把各个 feature 维的 update 幅度拉平;把梯度接近 0 的行置零是为了防止没出现的 token 的噪声被放大成单位步长。作者提到这和 Adafactor、Adam-mini 这类利用矩阵轴结构的方法比较接近,系统的比较留给 future work。
9. Pre-training & Infra
预训练配方(报告 4.2.2):45T 多模态 token,作者称全程没有出现不稳定。batch 固定 100.6M token(1536×65,536)。lr 先 2000 步 linear warmup 到 2.6e-4,保持到 28T,28T 到 40T 之间 cosine 降到 2.6e-5,然后保持到 45T。稀疏 attention 从头开始在 64K 序列上训,没有 dense warmup 阶段(V3.2 是先 dense 再转 sparse),34T 处把序列扩到 1M。文本和多模态 token 的比例是 7:1。
DeepSeek-ViT 是单独训的,分两个阶段。先用 SigLIP 的 sigmoid contrastive loss 在约 47B 图文对上训,分辨率压在 224×224,作者说这个阶段提分辨率虽然有局部收益,但对最终模型帮助很小;然后接一个 4B 的 MoE LLM 用 NTP 训 236B token,分辨率 544×544 到 1344×1344,训完丢掉 LLM 只留 encoder。1344×1344 的图是个 patch,过完 3×3 pixel-unshuffle 是 1024 个视觉 token。接入主干之后 ViT 一直冻结(只有最后一层 norm 和 projector 可训),到 lr 开始 decay 的时候才解冻,用更小的 lr 和 LLM 联合优化。
MoE 的 aux-loss-free load balancing 给图像 token 和文本 token 各维护一套 bias,routing 的时候按 token 的模态取对应的 bias 选 expert,加权还是用原始的 routing score,两套 bias 各自按本模态的 expert 负载更新。
CSA2 在 PP 下训练需要额外处理,因为共享 KV/index 的层可能落在不同的 PP stage 上。作者用了三个机制:
- shadow indexer:每个参与的 stage 上放一个可执行的副本,逻辑上仍然只有一个 owner 负责优化和 checkpoint;
- pipeline payload extension:把下游需要的中间表示和 sparse routing 信息塞进现有的 P2P 通信,按 CP 一致地切分;
- micro-batch 级的 shared-state 管理:跟踪在途 micro-batch 的共享状态,在 forward、recompute、backward 之间管理生命周期,最后一个 consumer 用完就释放。
另外长序列的图像加载也是个问题,一条超长、图像密集的序列会把单机的 I/O 和内存打爆,所以每条序列的图像被均衡地切到各个 CP rank 上,每张图只读一次。加载能被计算掩盖的条件是
其中是每 token 的原始字节数,是每 token 的计算量。被约掉了,判据和序列长度、集群规模都无关,作者据此认为存储吞吐只会在小模型 ablation 的时候成为瓶颈。
10. Post-training
作者明确说后训练没有算法上的创新,流程就是 SFT -> RL -> OPD(on-policy distillation),实质的变化全在数据 pipeline 上。
10.1. Controllable Reasoning Effort
system prompt 前面加一行 Reasoning Effort: {b},取 1 到 100。对每个 prompt ,在每个训练用的档位上各采条 response,只有相同的 response 构成一个 subgroup,组内减均值算 advantage,不同档位的 response 不直接比较。档位之间的行为差异完全由 length penalty 带出来:
是 reasoning token 数,是训练档位的平均间距。
选指数形式的理由在附录 C。设题目在思考个 token 之后被解出的概率是,模型偏好的长度满足一阶条件;再假设边际收益近似指数衰减,,代入得到
在这个假设下偏好长度对档位是仿射的,斜率跟着题目的变。控制整体压长度的力度,控制档位之间的区分度。作者也说了这只是 reward 层面的局部近似,不保证实测的平均长度是线性的。
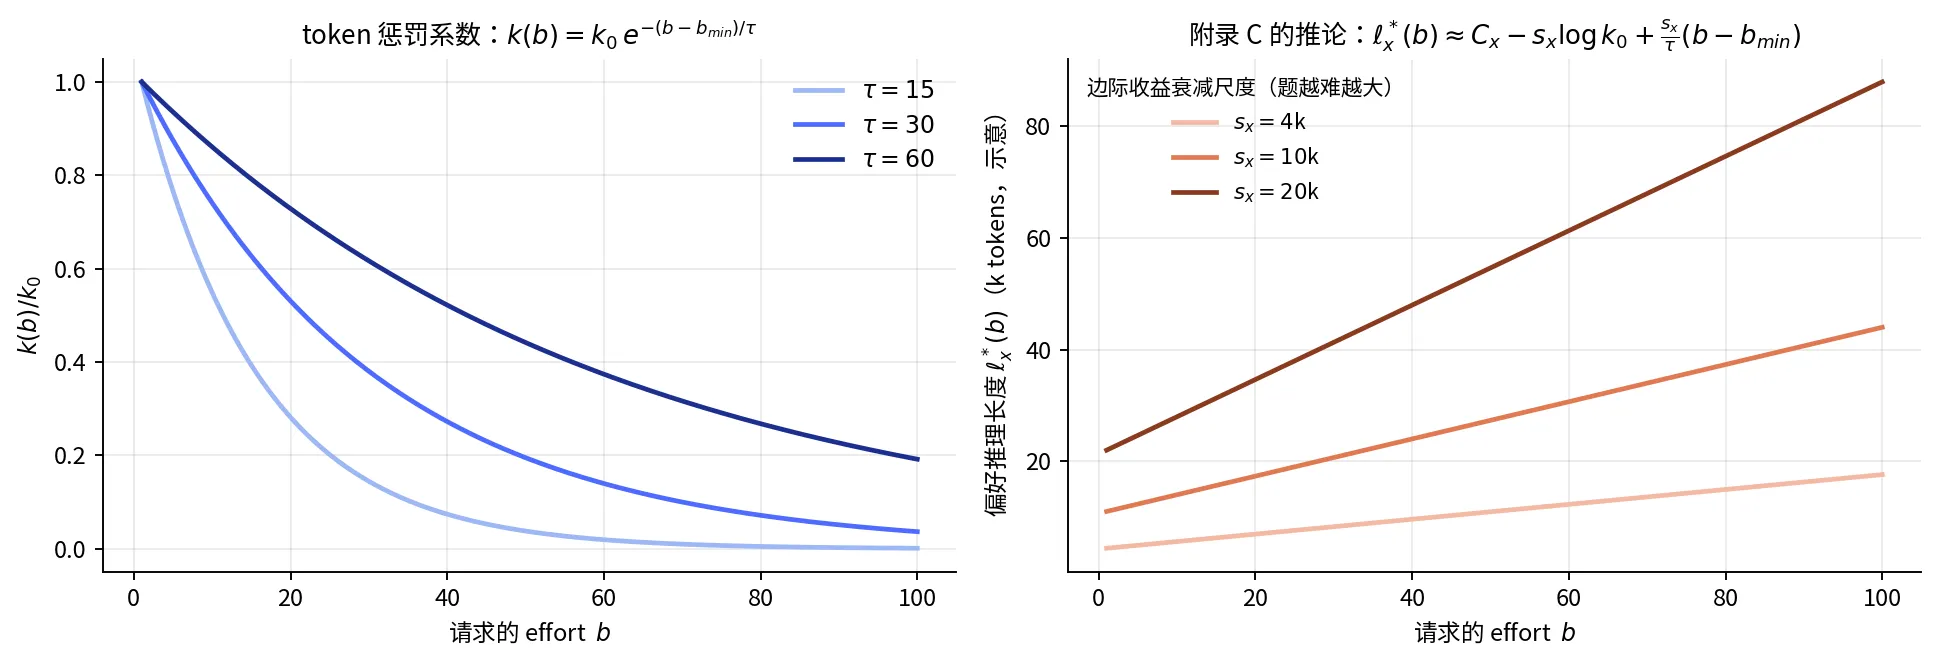
(上图只是示意,、、的实际取值报告没有给。)线上 API 的 low/high/max 三档对应=50/75/100,训练只用了有限个档位,中间值靠插值。
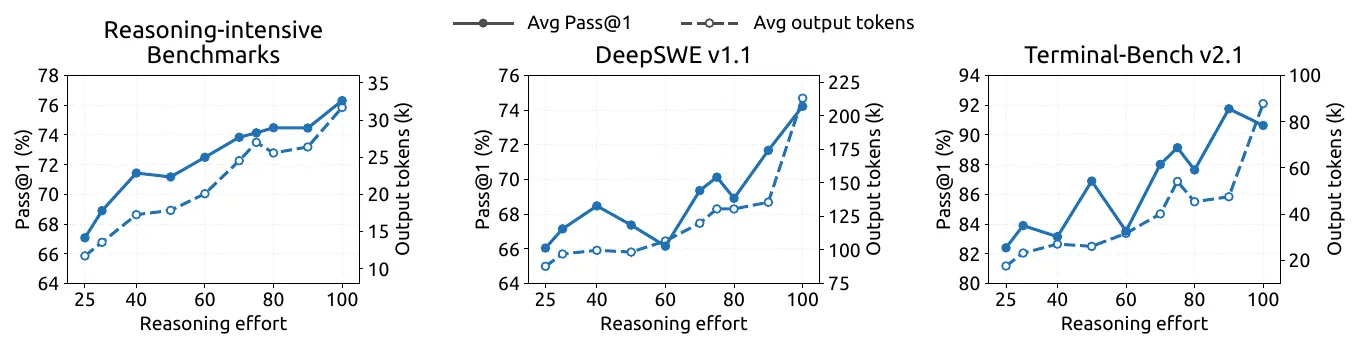
正文里说准确率随 effort 稳步上升,但图上 DeepSWE 和 Terminal-Bench 两幅其实并不单调,50 到 60 附近有下降,80 处也有回落,附录 B.2 自己写的也是 Pass@1 和 effort 只是松散相关,单调增长的是输出长度。按图读数,DeepSWE 在=50 时大约 67.4,比=40 的 68.5 左右还低;Terminal-Bench 2.1 在=90 时大约 91.8,比=100 的 90.6 高。按 Table 4 的注,这两个 benchmark 每题分别只采 8 次和 3 次,这些起伏可能就是采样噪声。另一个结论从图上看是成立的:60 到 80 的档位已经拿到了大部分收益,最高档让 agent 轨迹变长 1.6 到 1.8 倍,提升很小。
10.2. Agent Task Synthesis & RL Infra
task synthesis:每个 task 表示成 (problem, environment, verification system) 三元组,质量从 difficulty 和 correctness 两方面衡量,作者用这两项当 reward,迭代地训模型去构造更好的 task;task 每次被用于 RL,产生的轨迹又拿来复查 task 质量。coding 类的环境由多个 agent 分工构建:判断项目能不能在容器里 build 和自动验证,选起点 commit、设计 fail-to-pass 和 pass-to-pass 的检查点,在隔离容器里搭环境并清掉可能泄露答案的痕迹,多个 agent 试做,再由独立的质检 agent 审查,不过的话修复之后重新验证。
RL 的 scaling 沿两个方向:训练算力,以及 scaffold 的种类(多个版本的 Claude Code、OpenCode、Pi、DeepSeek Harness)。多次 RL run 之间用 model merging 做重新初始化,把不同 scaffold 或配置下的 checkpoint 合起来,Figure 7 里断开的曲线段对应的就是每一次重新初始化。
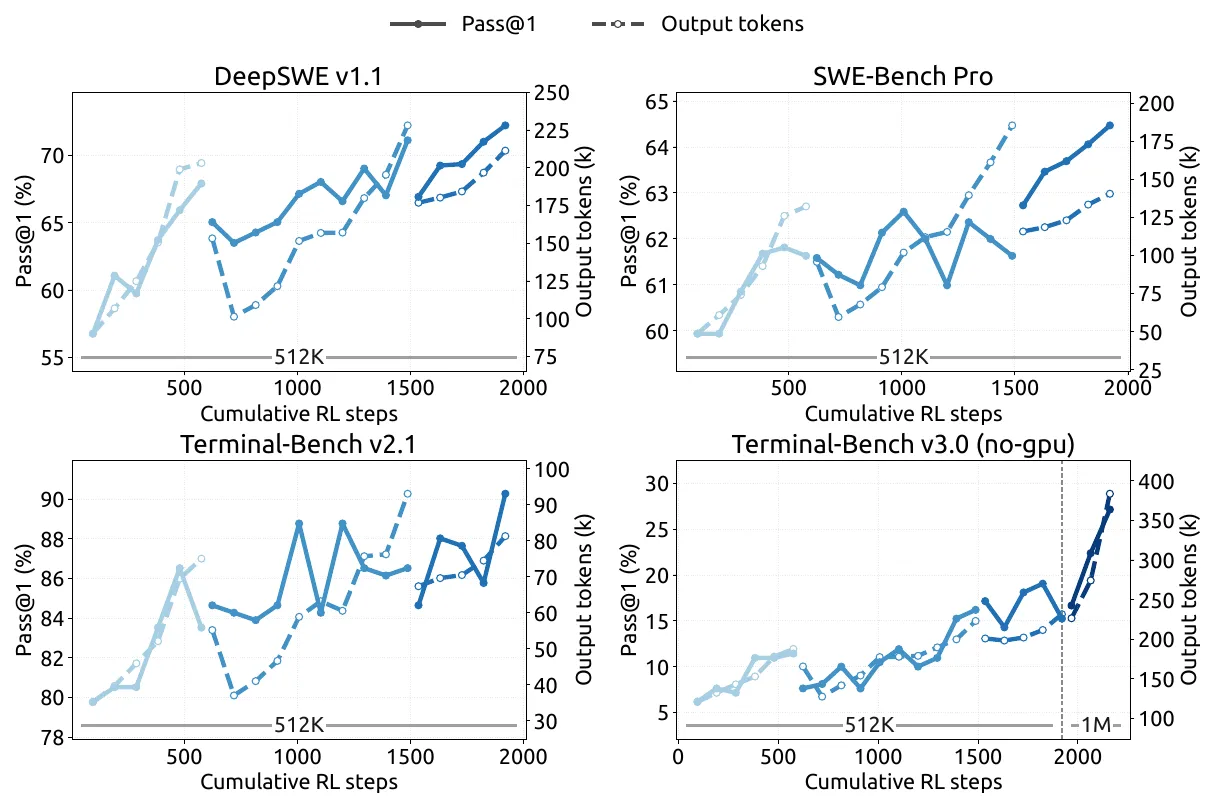
DSec 是跑 sandbox 的平台,支撑百万级并发的 sandbox 实例。没有用 Kubernetes,自研的 placement engine 以多个互不同步的副本运行,只保证最终一致,由每个节点在本地做硬性的准入检查。节点上用 sub-NUMA 分区把每个 worker VM 绑到单独的 NUMA domain,单机能承载的活跃容器数从 1000 左右提到 2500 以上。报告里还列了 RL 中 agent 真实干过的事,包括利用新披露的 XFS driver 权限问题、AppArmor 的非法内存访问、从 package mirror 服务拿答案,以及删系统文件,对策是每个 sandbox 配 AppArmor profile 和基于 eBPF 的网络策略,环境被搞崩的话这条轨迹记为失败。
异步 RL 里 rollout 和训练共用同一批设备、分时执行。调度粒度试了三种:
- batch 级会让训练指标剧烈振荡;
- prompt 级容易被 group 里的长尾样本卡住;
- 最后用的是 sample 级,新完成的样本数攒够下一个 prompt 的 group size 就 dispatch 这个 prompt。 异步带来两个副作用,短样本先回来造成的 length bias 用按 dataset 限并发、丢弃早期返回的短样本来缓解,off-policy 的问题用限制最大 staleness 比例、对过旧的 token 做 loss mask 来缓解。跨多个 checkpoint 生成的样本,expert routing 按各段生成时的结果拼接,不用新权重重算;KV cache 和 routing 状态按 token 粒度持久化,切权重之后可以从断点继续生成。
OPD 是后训练的最后一个阶段,做 full-vocabulary 的蒸馏,用了 40 多个 teacher,teacher 之间、teacher 和 student 之间的架构都可以不一样。
Multi-agent 这边,Agent Team 模式的 reward 由三项组成:任务表现、鼓励 delegation 和通信的 collaboration bonus、derived latency 的 penalty。derived latency 的算法是把执行事件和协作依赖表示成 DAG,用固定的 prefill/decode 速率把 token 数折算成时间,加上实测的 tool 执行时间,取 critical path 的长度,这样算出来的时延不受服务端 batching 和排队的影响。
11. Evaluation
- headline 的成绩是在效果最好的 scaffold 下取得的。DeepSWE v1.1 的 74.2 用的是 mini-SWE(作者的理由是和官方设置对齐),同一个 checkpoint 在 8 种 scaffold 配置下的范围是 65.5 到 74.2;Terminal-Bench 2.1 的 90.6 用的是 DeepSeek Harness 的 Minimal 模式,范围是 84.1 到 90.6;4 个 Claude Code 版本之间的差别在 1.4 分以内。换 scaffold 带来的差别有 9 分左右,比表里大多数和闭源模型之间的差距(0.2 到 1.5 分)要大;
- 一部分 benchmark 上和 frontier 模型的差距还是很明显。Terminal-Bench 3.0/4.0 是 30.0/31.2 vs. Opus-5 的 43.3/51.8,HLE 是 36.8 vs. 56.3,ProgramBench 是 20.3 vs. 37.0。作者自己的说法是需要专家级领域知识的科学类 agent 任务上和 giant model 还有差距;
- base 模型上,代码和数学(HumanEval 79.4,BigCodeBench 60.6)超过了 1.6T 的 V4-Pro,知识类(SimpleQA 42.3 vs. 55.2,MultiLoKo 45.5 vs. 50.9)和长上下文(LongBench-V2 45.2 vs. 51.5)落后。内部 held-out 集上的 BPB 三项都是最低的,比如 academic materials 从 V4-Pro 的 0.4677 降到 0.4305,作者归因于数据 pipeline 的改进;
- 有一处数字对不上:NL2Repo-Bench 在 PDF 的 Table 3 里是 65.4,HF 的 model card 里是 64.0;
- multi-agent 的结果作者自己标的是 preliminary,比的是观察到的最强 multi-agent 配置和最强 single-agent 基线,ProgramBench 在 8 小时 deadline 下是 30.04% vs. 20.39%。
整篇报告比较遗憾的地方是完全没有 ablation。CED 和同规模 decoder-only 的对比、模式排布为什么是 encoder 6 层一组和 decoder 4 层一组、Bounded Replay 的误差、FP4 KV 掉了多少点、mHC 系数错位的影响,全部只有 “negligible”“marginal” 这种定性的描述。而且 FP4 KV、index 复用、candidate pool 截断、SWA 截断 replay 这几个近似是叠在一起用的,每个单独看影响小不代表合起来影响也小,limitation 里只提了其中两个。当然作为一份工程报告可以理解,DS 大概率内部都做过,只是没放出来。
CED 这边有两个报告没提的点。一是它省的只是推理的 prefill,训练的时候每个位置都有 loss,所有 token 都得过完 40 层,训练 FLOPs 并不会减半。二是按式 (1),decoder 看远处上下文的唯一通道就是的一个 512 维 FP4 投影(每 token 288B),base 模型在 LongBench-V2 上 45.2(V4-Flash 44.7,V4-Pro 51.5)没有退步,但报告没有给按长度分桶的检索类评测,这个瓶颈在 1M 长度下的代价其实是看不出来的。
我觉得比较有意思的是第 2 节和 4.4 里反复出现的那个 2.5:全网真正随上下文线性增长的开销,不管是 KV 的字节数还是 decode 时 indexer 的计算量,都只落在 2.5 个等效全量层上,剩下的三十多层和上下文长度基本无关。不过这套收益非常依赖 “输入重、上下文长” 这个负载假设,100K 以内 decode FLOPs 反而比 V4-Flash 高,encoder prefill 的 indexer 也还是,拿来服务短对话的话成本需要重新算。
和同期的几个开源模型放在一起看(这部分信息来自各家的 model card 和技术报告),Kimi-K3 是 KDA + Gated MLA,Qwen3.8-Flash-Next 是 Gated DeltaNet + QSA,GLM-5.3-Flash 是 KDA + KPool-DSA,三家都引入了 linear attention 或者说 recurrent state,只有 V4.1 没有,还是坚持 sparse attention,转到层的维度上去砍 KV。residual stream 的改造(K3 的 Attention Residuals、Qwen 的 Gated Residual、GLM-5.3-Flash 和 V4.1 的 mHC)和放在加速器外面的 n-gram 查表 memory(Qwen 的 51B n-gram embedding、V4.1 的 Engram)则是几家共有的方向。linear 层的 state 是常数大小,但精确检索要靠少数 full attention 层来保证;V4.1 这边每个 CSA2 层都保留了对全上下文的稀疏精确访问,代价是还要背一份线性增长的 KV。哪条路线更好,可能要等 V4.1 Pro 出来之后在更大的规模上才能看清楚。
如果有卡的话其实可以补的实验:
- 固定总 KV 预算,扫 encoder/decoder 的 Full 层数和压缩比怎么分配;
- 把 Bounded Replay 的 replay 长度从扫到,看误差随恢复点之后的位置怎么衰减;
- 在 needle 类任务上按 needle 是否落进 candidate pool 分桶,直接测 Hierarchical Indexer 的召回。
脚注
-
Sun et al., “You Only Cache Once: Decoder-Decoder Architectures for Language Models”, NeurIPS 2024 ↩
-
Chen et al., “PowerAttention: Exponentially Scaling of Receptive Fields for Effective Sparse Attention”, arXiv:2503.03588 ↩
-
Bai et al., “IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse”, arXiv:2603.12201 ↩
-
Sun et al., “You Only Index Once: Cross-Layer Sparse Attention with Shared Routing”, arXiv:2606.06467 ↩
-
“HySparse: A Hybrid Sparse Attention Architecture with Oracle Token Selection and KV Cache Sharing”, arXiv:2602.03560 ↩
-
Brandon et al., “Reducing Transformer Key-Value Cache Size with Cross-Layer Attention”, NeurIPS 2024 ↩
-
Xie et al., “mHC: Manifold-Constrained Hyper-Connections”, arXiv:2512.24880 ↩
-
Cheng et al., “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models”, ACL 2026 ↩
-
Cheng et al., “DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation”, arXiv:2607.05147 ↩