原文:arXiv:2210.12899 · Moitra et al., TCAD 2023
摘要: 脉冲神经网络是以制作低能耗机器智能为目标的一个活跃的研究领域。与传统的人工神经网络(ANNs)相比,SNNs 使用时间脉冲数据和生物可信的神经元激活函数,如 LIF/IF 来处理数据。然而,SNNs 在标准的冯・诺伊曼计算平台上会产生大量的点积运算,导致高内存和计算开销。为此,提出了内存计算(IMC)架构来缓解冯・诺伊曼架构中普遍存在的 “内存墙瓶颈”。尽管近期的研究提出了基于 IMC 的 SNN 硬件加速器,但以下关键的实施方面被忽视了:1) 由于在多个时间步长上重复模拟点积运算,交叉电阻的非理想效果对 SNN 性能的影响;2) LIF/IF 和数据通信模块等 SNN 特定组件的硬件开销。为此,我们提出了 SpikeSim 工具,它可以对映射到 IMC 的 SNNs 进行现实性能、能源、延迟和面积评估。SpikeSim 由一个实用的单片 IMC 架构 SpikeFlow 组成,用于映射 SNNs。此外,非理想性计算引擎(NICE)和能源 - 延迟 - 面积(ELA)引擎对映射到 SpikeFlow 的 SNNs 进行硬件真实性评估。基于 65 纳米 CMOS 实现和在 CIFAR10、CIFAR100 和 TinyImagenet 数据集上的实验,我们发现 LIF/IF 神经元模块对总硬件面积的贡献显著(>11%)。为此,我们提出了 SNN 拓扑修改,这导致神经元模块面积减少 1.24 倍,总能量延迟产品值减少 10 倍。此外,在这项工作中,我们对 IMC 实现的 ANN 和 SNN 进行了全面比较,得出结论:与 4 位 ANN 相比,较少的时间步长是 SNN 实现更高吞吐量和能源效率的关键。SpikeSim 工具的代码仓库将在此 Github 链接中提供。
1. Intro
在传统的计算架构上实现 SNN 同样会因为需要执行大量点积操作导致执行低效、面临内存墙问题。为了解决这一问题,模拟存内计算(analog In-Memory Computing,IMC)也被用来实现 SNN。
目前的 IMC 已经有一部分工作评估在 IMC 上运行 ANN 了,但是对于 SNN 这样的工作还存在一些缺陷,因为它们缺乏时间脉冲处理和非线性激活函数(如 LIF/IF)所需的关键架构修改。在 SNNs 的硬件评估平台方面,已经提出了一些工作,用于在数字 CMOS 平台上基准测试 SNN 训练。此外,还有研究提出了用于 SNN 推断的 IMC 架构。然而,它们缺乏一些实际的架构考虑,如模拟 MAC 计算中产生的非理想性、数据通信开销等,使得它们不适合进行 IMC 映射 SNNs 的全面硬件评估。所有这些在表 I 中进行了定性比较和对比。因此,在当前文献中,存在 SNN 算法设计与硬件现实基准测试这些算法的全面评估平台之间的明显差距。
Contribution:
- 本文提出 SpikeSIM,对 SNN 进行端到端的硬件评估工具。SpikeSIM 包括一个大型的 IMC-based tiled hardware architecture 称为 SpikeFlow,可以将 SNN 映射到非理想的模拟 crossbar 电路上。在 SpikeFlow 中,我们结合了 SNN 特有的非线性激活函数,如 LIF/IF 神经元,并利用二进制脉冲输入数据提出了一个轻量级模块(DIFF 模块),以便在不需要传统双交叉阵列方法的情况下促进有符号 MAC 操作。
- 为了进行硬件现实 SNN 推断性能基准测试,我们开发了非理想性计算引擎(NICE)。NICE 结合了非理想性感知的权重编码,以提高 SNNs 在模拟交叉阵列上映射时的鲁棒性。NICE 利用电路分析方法实现非理想 MAC 操作,并提供硬件现实的 SNN 推断性能。此外,我们设计了一个能源 - 延迟 - 面积(ELA)引擎,来基准测试 SpikeFlow 映射 SNN 的硬件现实能源、延迟和面积。
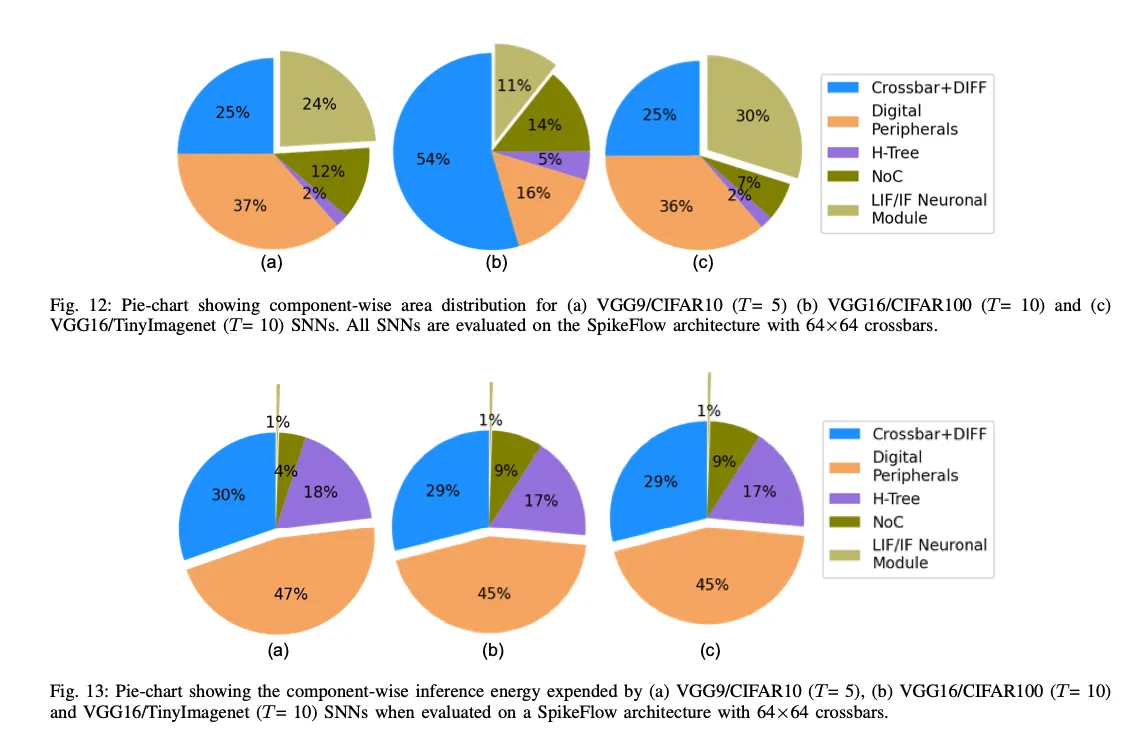
- 在 CIFAR10、100、TinyImagenet 上广泛测试了 SpikeSIM,并发现神经元模块占用了总芯片面积的显著部分(11 - 30%),这是由于在时间步之间需要存储大量膜电位。
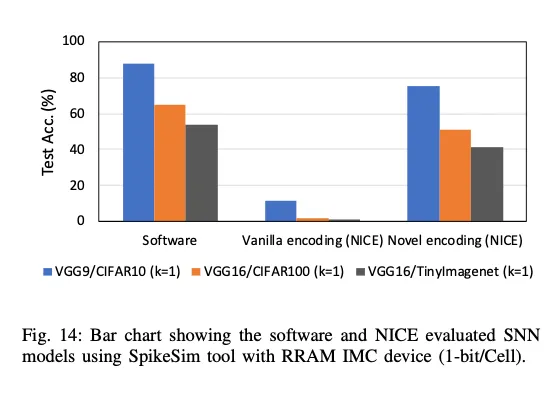
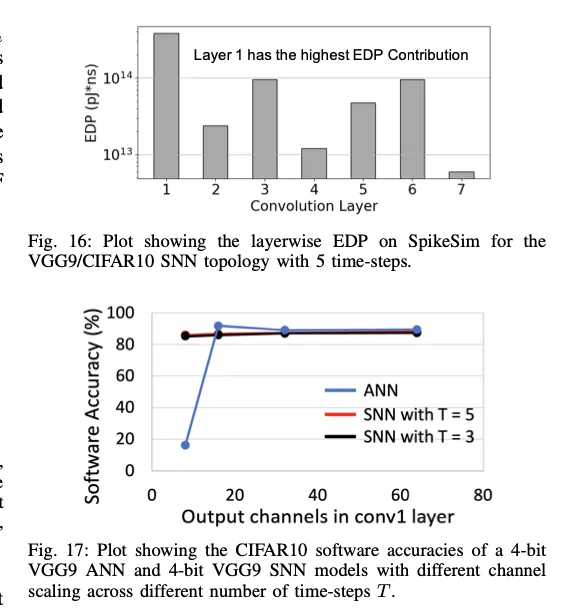
- 在试验中发现,简单的 SNN 修改就能将神经元模块的芯片面积开销减小 1.24 倍,并将能源延迟产品(EDP)提高 10 倍。此外,我们还展示了非理想性感知的权重编码比起传统权重编码,能够提高映射到 SpikeFlow 架构上的 SNN 准确性超过 70%(针对 CIFAR10 数据集)。
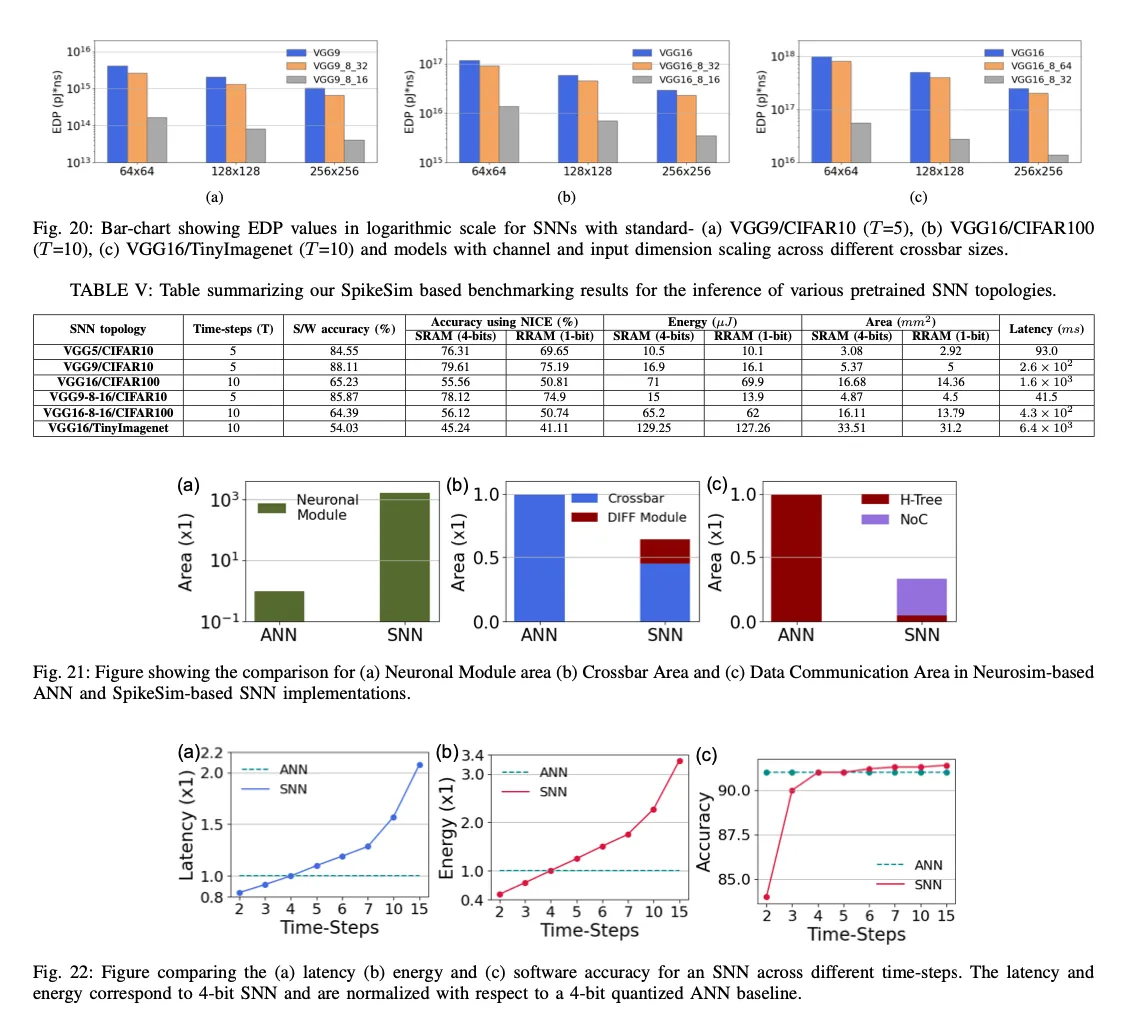
- 我们比较了映射到交叉阵列上的 VGG9 ANN 和在 CIFAR10 数据集上训练的 SNNs 的性能以及面积和能源分布。我们发现,与 ANNs 相比,SNNs 的神经元模块面积高出约 1000 倍,且在小时间步(T =3,4,5)值下,与 4 位 ANNs 相比,SNNs 可以实现相同的性能,并具有更高的能源效率和吞吐量优势。
2. Related Works
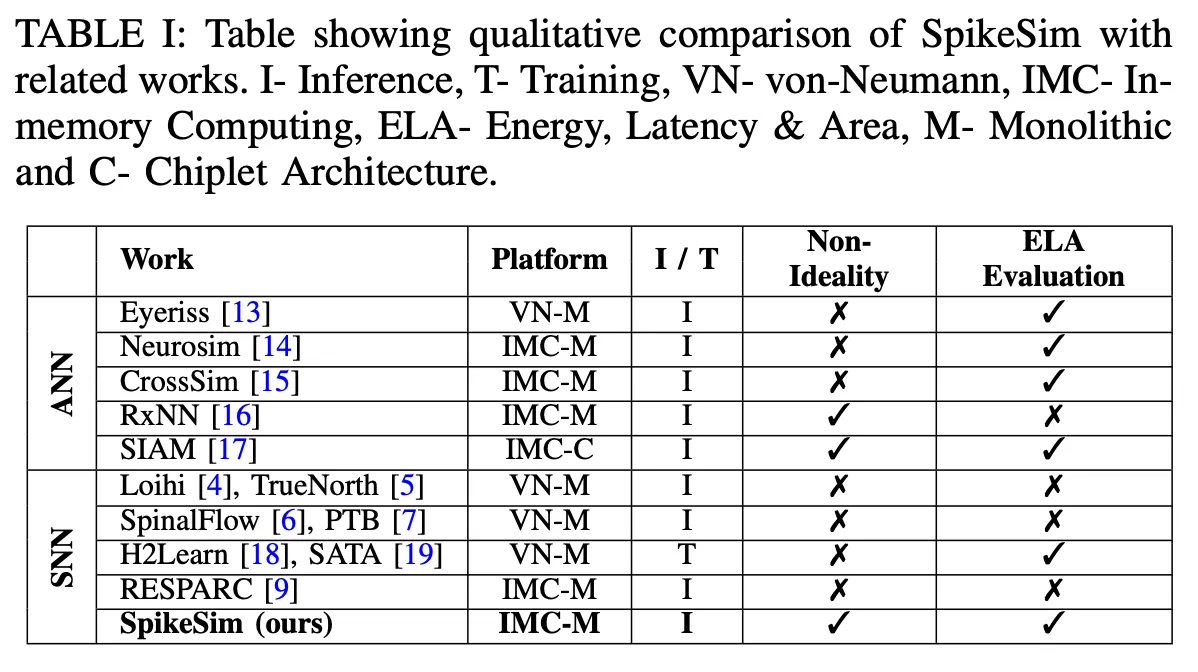
2.1. Hardware for ANN Inference
Eyeriss, ISAAC, PUMA, Neurosim, SIAM.
While the above works provide state-of-the-art evaluation platforms for ANN accelerators, they are insufficient for accurate SNN evaluation as they lack critical architectural modifications required for temporal spike data processing and LIF/IF activation functionalities.
2.2.. Hardware for SNN Inference
SpinalFlow: tick-batched dataflow to achieve higher energy efficiency and lower hardware overheads.
RESPARC: analog crossbar-based, higher energy efficiency due to the event-driven communication and computation of spikes. Overlooked the underlying hardware overheads for event-driven communication and the effect pf analog crossbar non-idealities on SNN performance.
3. Background
3.1. Spiking Neural Networks
Leak-Integrate-and-Fire(LIF) neuron formula:
:神经元 i,j 之间连接的权重;:leak factor。
这种不可微分性意味着需要其他的训练方法,已经提出的方法包括:
- ANN-SNN conversion:先训练 ANN,然后利用 LIF/IF 模拟 RELU,将训练好的 ANN 转化为 SNN。可以利用已有的 ANN 训练相关的技术。
- Surrogate gradient learning:似 LIF/IF 神经元的反向梯度函数来解决非可微分问题。替代梯度学习可以直接从脉冲中学习,在较少的时间步数内完成。
在 Surrogate learning 上,关于如何编码输入数据又可以分成 Direct Encoding 和 Rate Encoding 两种:
- Rate Encoding 利用泊松分布编码,将输入数据转换成随机分布的 spike。
- Direct Encoding 直接利用从数据中多个 time step 提取的特征作为输入。
目前看来是 Direct Encoding 可以用更少的 time step 取得更好的训练效果。
3.2. Analog Crossbar Arrays and their Non-idealities
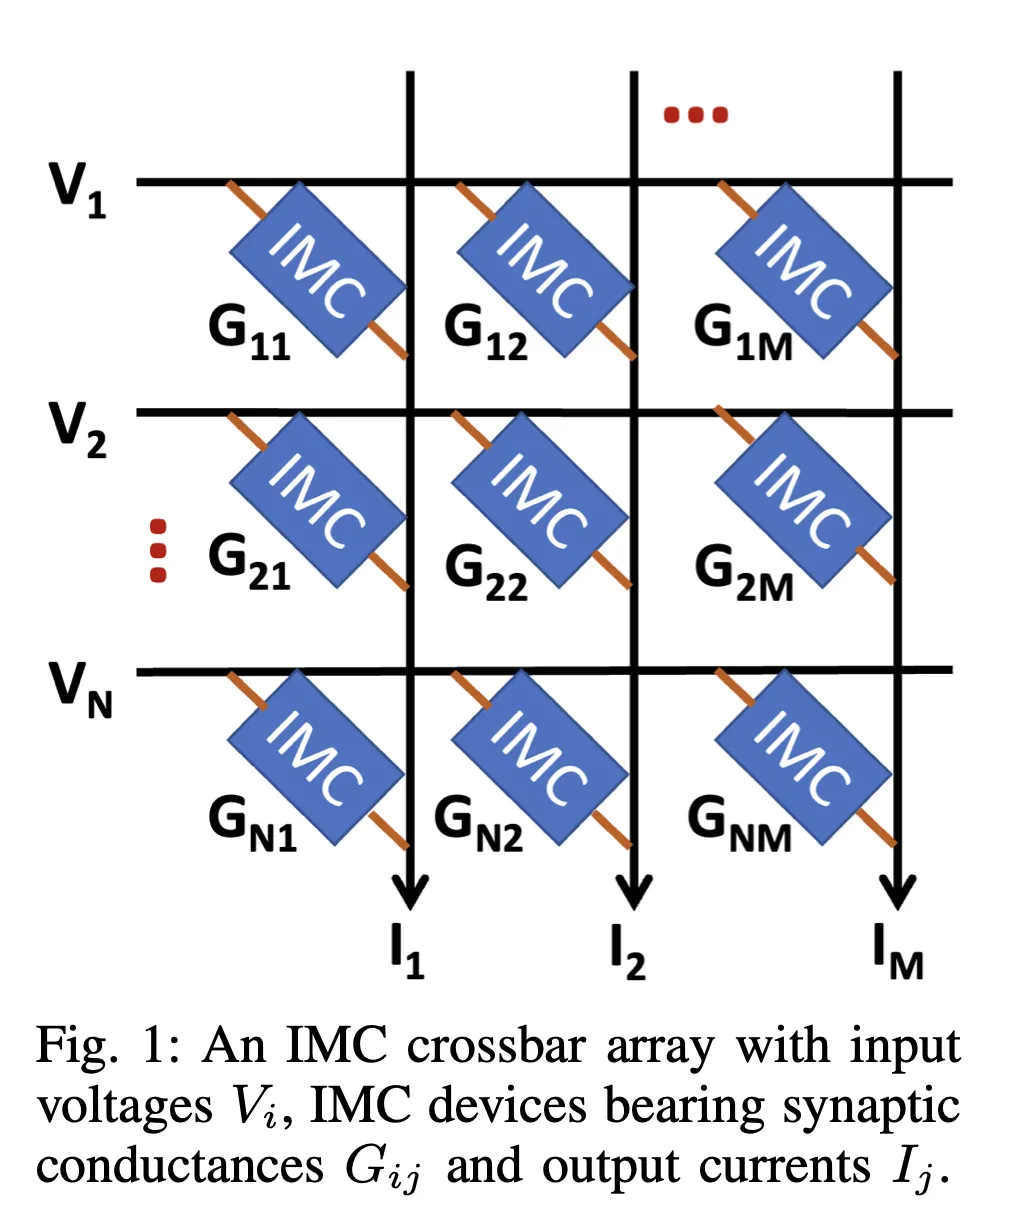
神经网络的激活输入作为模拟电压 Vi 输入到交叉阵列的每一行,权重则作为突触器件的电导(Gij)在交叉点编程,如 Fig1 所示。在理想的 N×M 交叉阵列推断过程中,电压与器件电导相互作用并产生电流(由欧姆定律控制)。
理想情况下,输出是。但实际上,由于寄生电阻或者其他的因素,电导可能和理想中的不同,这会导致实际输出的电流与理想状况下不同,导致某些神经元可能不能正确地产生脉冲,这会导致 SNN 出现巨大的精度损失。更大的 crossbar 电路会有更高的 “non-idealities”,对应的 SNN 就会有更高的精度损失。
4. SpikeSIM
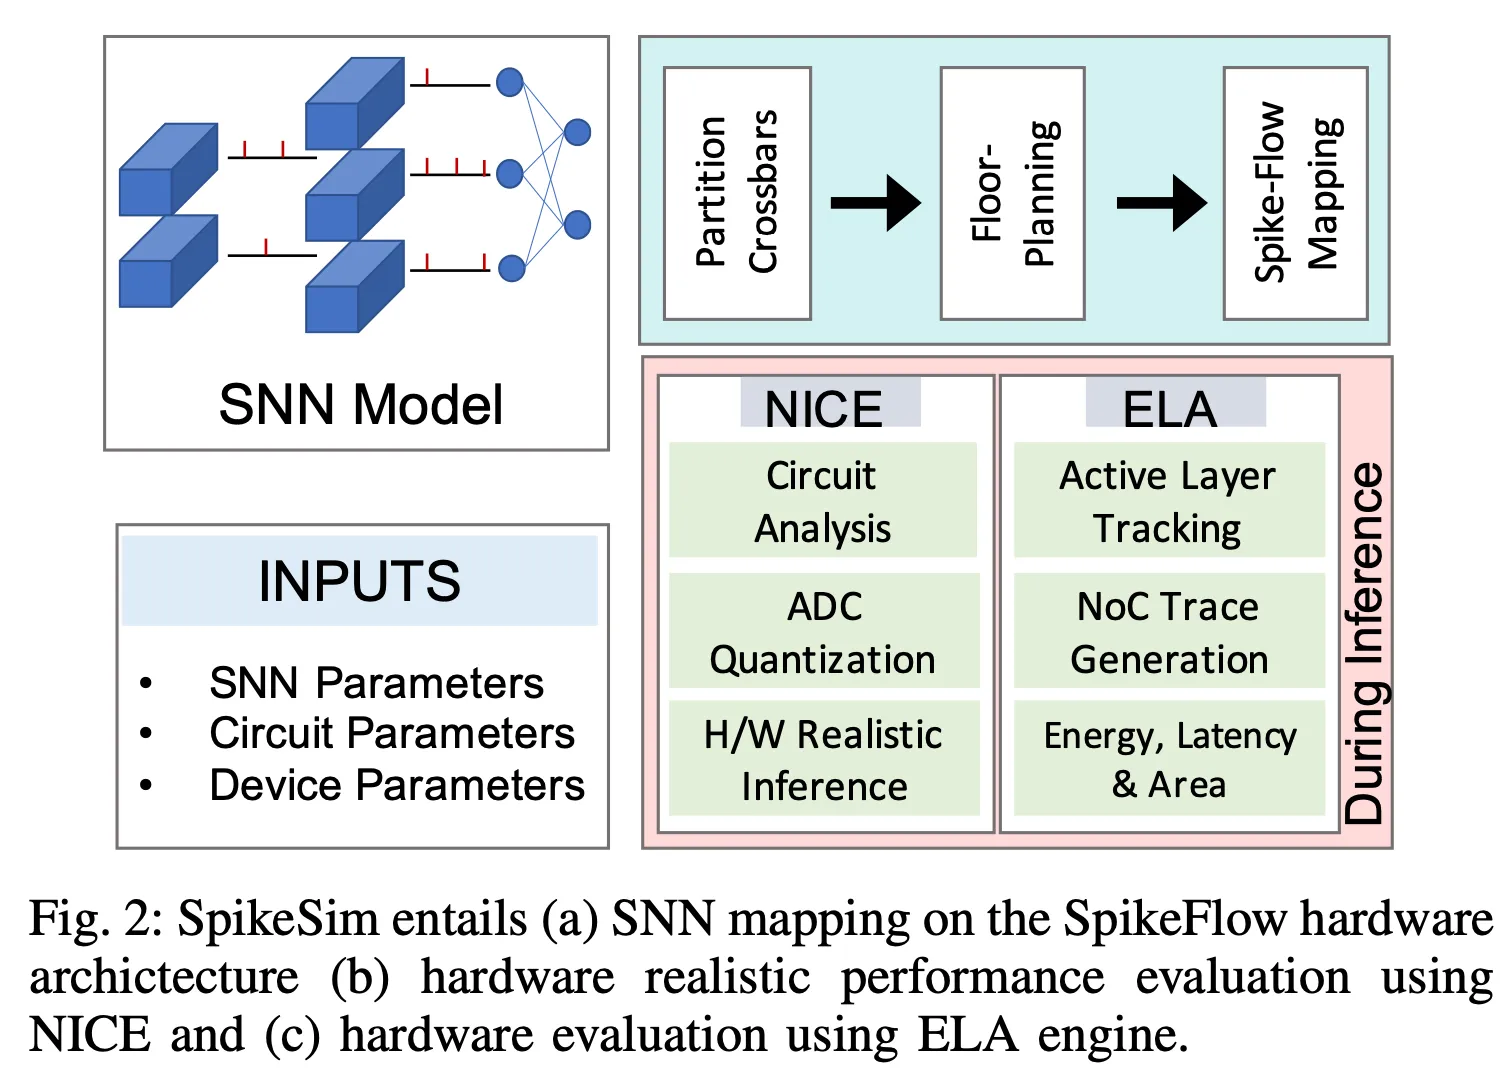
主要分三部分:
- SpikeFlow Mapping:如何把 SNN 映射到硬件上
- NICE,Non-Ideality Computation Engine:利用包括电路分析和 ADC 量化的方法分析一个 SpikeFlow like 的 SNN 的实际 performance
- ELA Engine:计算 energy、latency、area 等信息
4.1. SpikeFlow Architecture
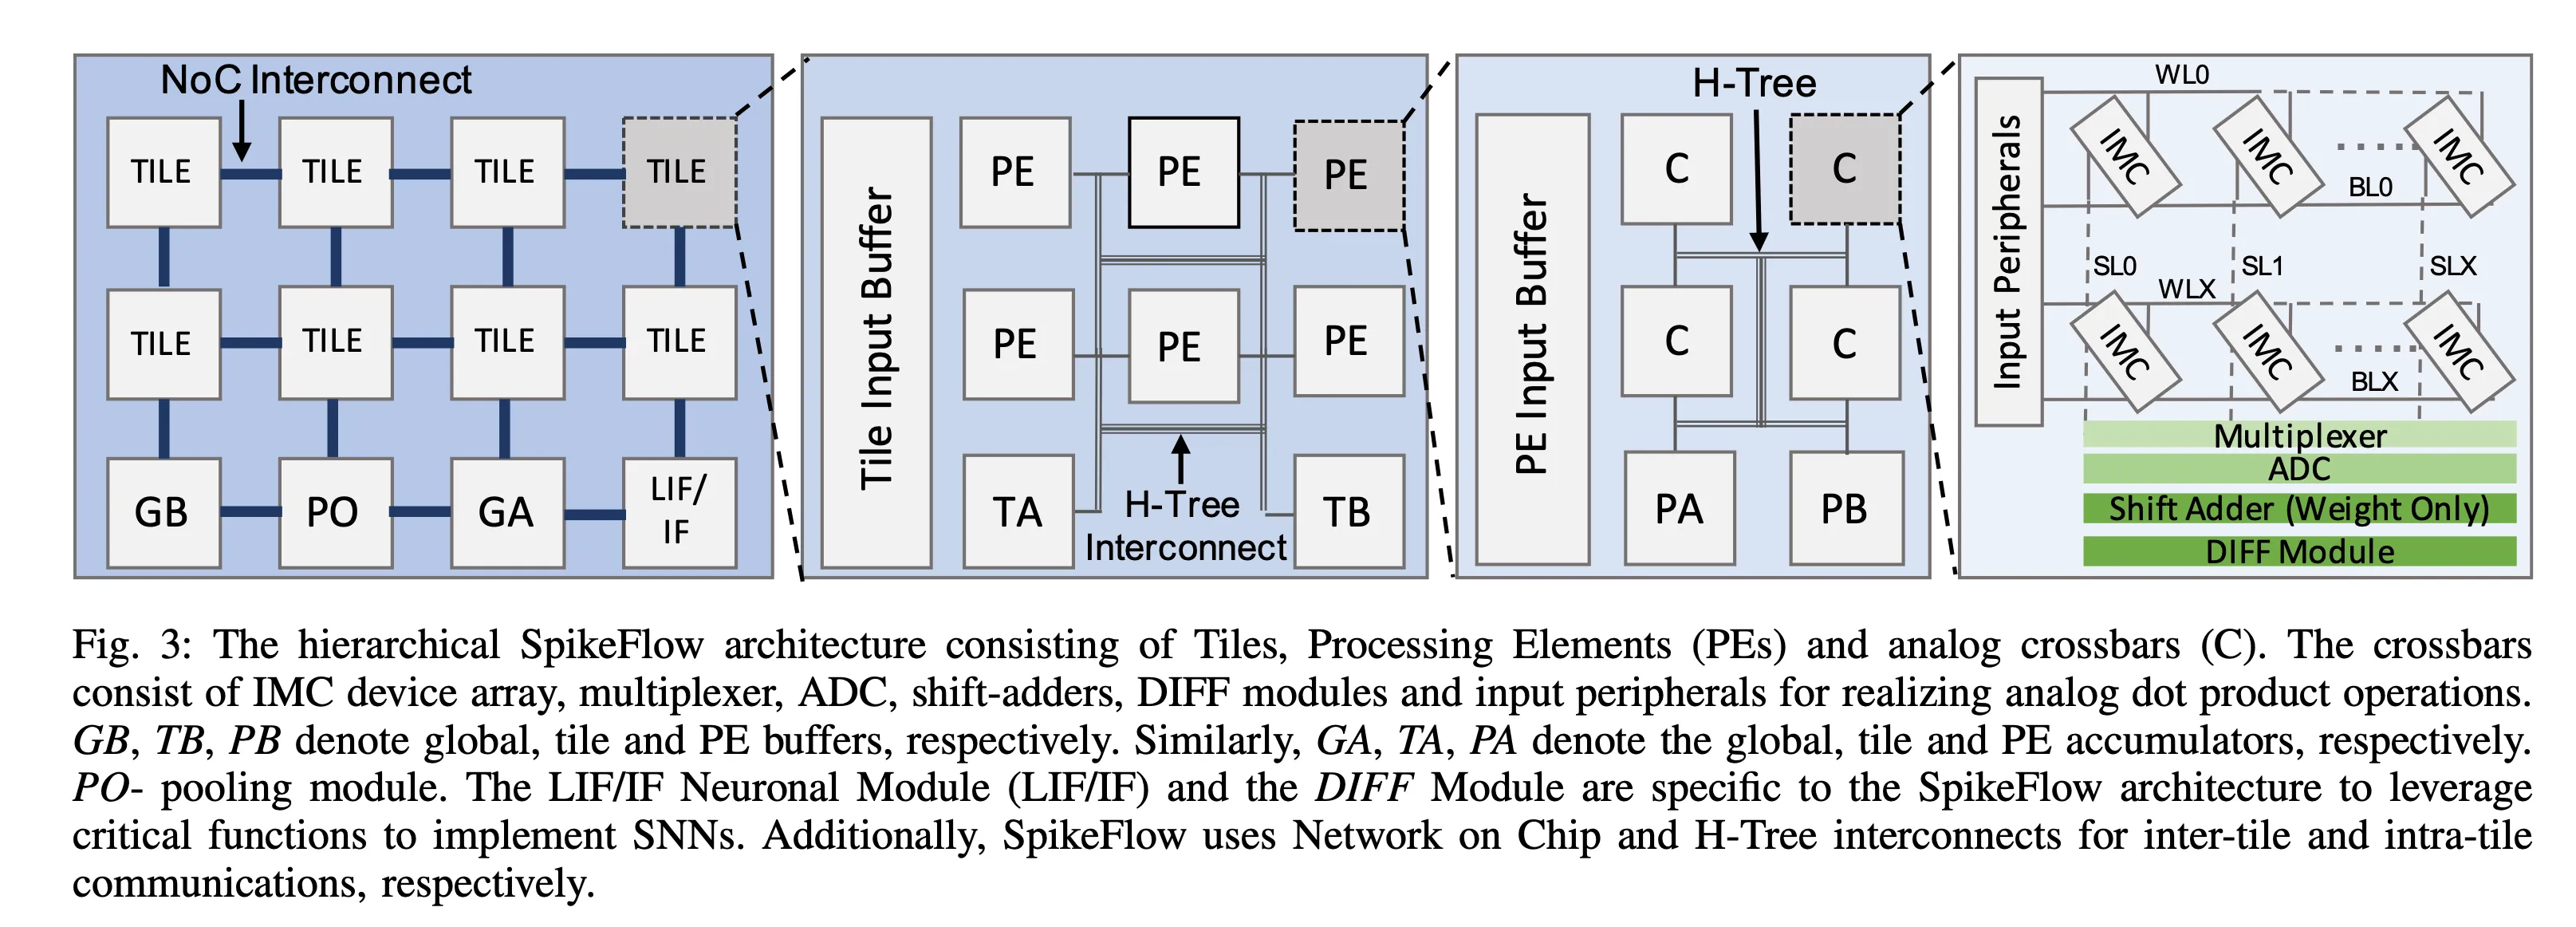
分层设计,顶层是 global Buffer,pooling module,global accumulator,IF 神经元等,通过 NoC 和大量 TILE 互联;一个 tile 中包含若干 H tree 连接的 PE 和 input buffer,tile accumulator,tile buffer;PE 中包含一个 PE input buffer 和 accumulator,以及多个 analog crossbar;crossbar 中就是前面的那种电路结构。
- Shift-and-Add circuit are incorporated to support bit-splitting of weights = bit serial?
Typically, crossbars in ANNs require separate Shift-and-Add circuit to support input bit-serialization and bit- splitting for weights. Due to the binary spike input, SpikeFlow only requires shift-and-add circuit to support weight splitting and not input serialization. Additionally, binary spike data allows replacing the traditional dual crossbar approach for performing signed MAC computation with fully digital DIFF modules which reduce SpikeFlow’s crossbar area significantly compared to ANN crossbars.
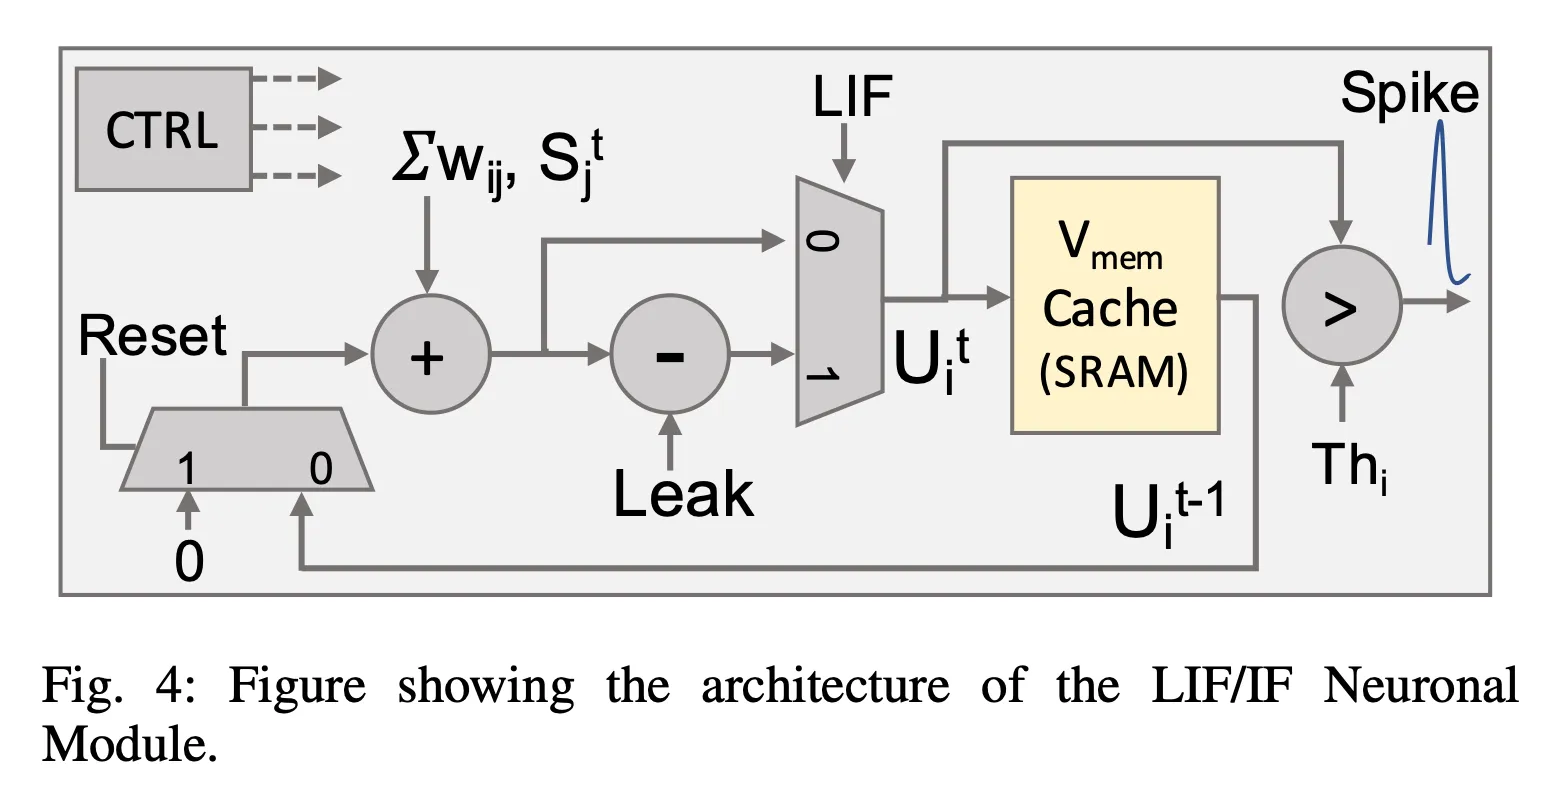
Note, that the Vmem Cache is an SRAM memory required to store the membrane potentials over multiple time-steps. As we will see in Section V-D, has a significant contribution to the overall hardware overhead in SpikeFlow.
Mapping SNNs onto SpikeFLow: mapping strategy like Neurosim for partitioning and mapping the pre-trained software SNN weights.
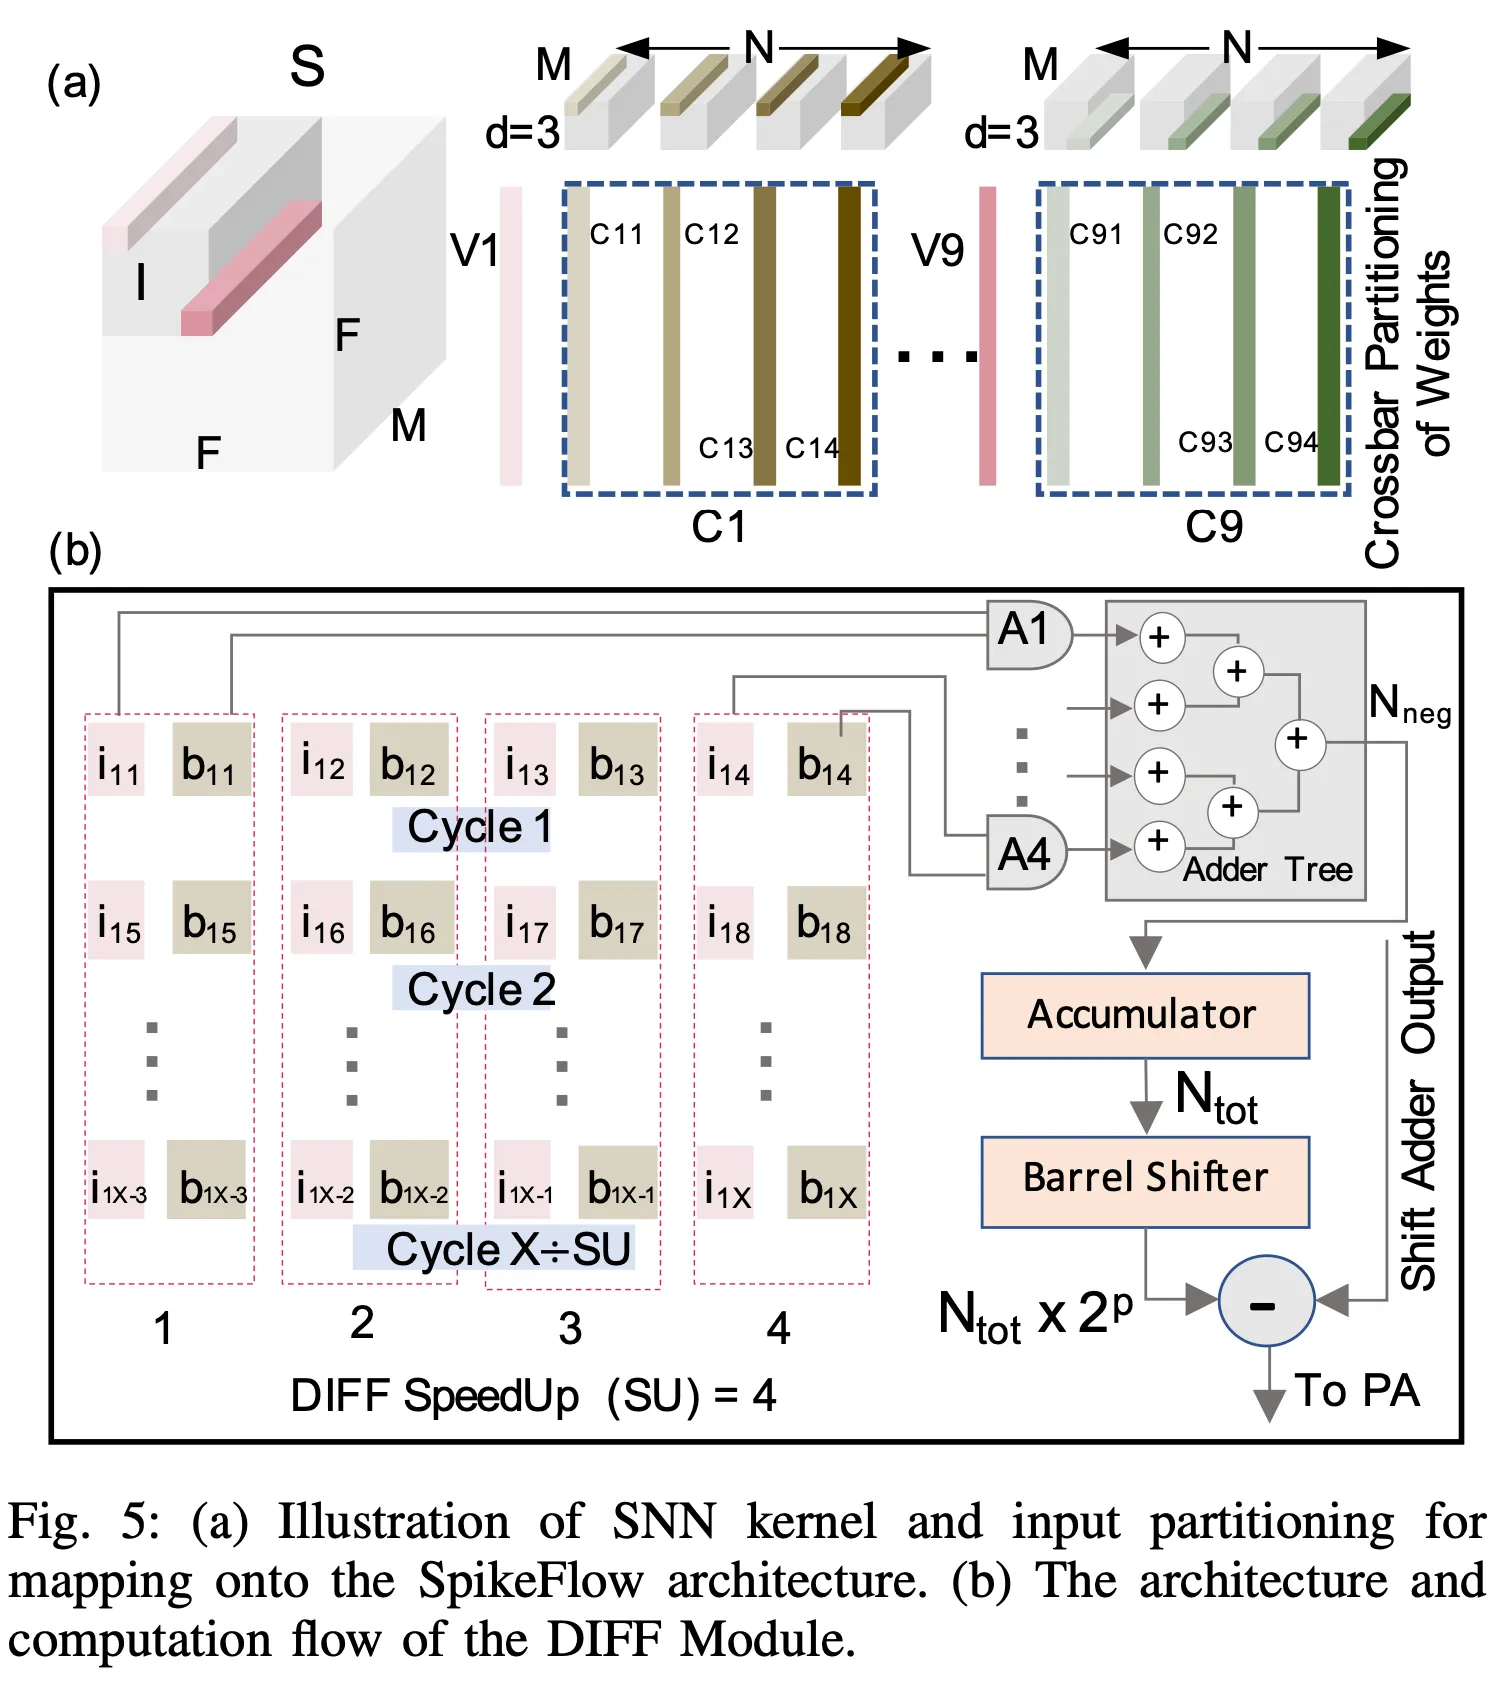
Here, N and M are the output and input channel dimensions, respectively and d is the kernel dimension. The weight kernels are partitioned along the input channel (M) dimension and mapped along a crossbar column. While, the corresponding weights along the output channel dimension (N) are mapped on different columns of the same crossbar. The weights along the d × d dimensions are mapped on different crossbars. Hence, for a d= 3 kernel, 9 crossbars (C1-C9) are required. A similar partitioning is applied to the spike input map S over the M×d×d section. This mapping strategy maximizes input data reuse and minimizes the buffer access.
基本上就是把 input kernel 展平?
4.2. NICE: Non-ideality Computation Engine
直接把传统的 SNN 权重部署到 crossbar 上,会因为 crossbar 本身的非理想性(比如寄生电阻等)导致实际输出和理想值不同,掉点严重。
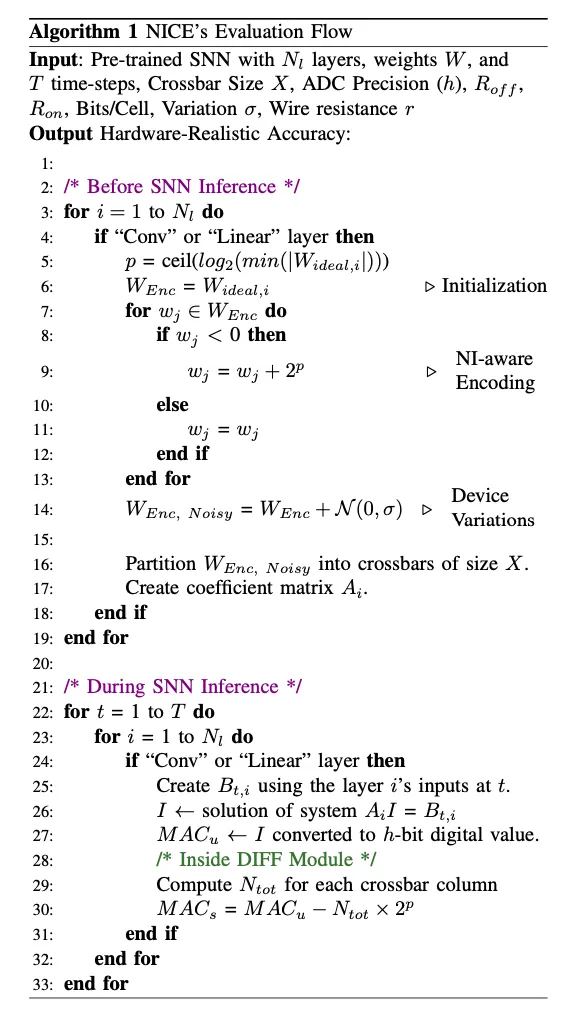
主要思想包括两个:
- 将负的权重通过映射到正的部分上,这样会增大整个电路的电阻,减少寄生电阻的产生
- 在计算的时候附加一个正态分布的随机噪声,然后通过调整 weight 减少噪声对系统输出的影响
4.3. ELA Engine
好像实际上做的事情是一般的 Energy&Area Evaluation 都会做的
5. Experiment and Result
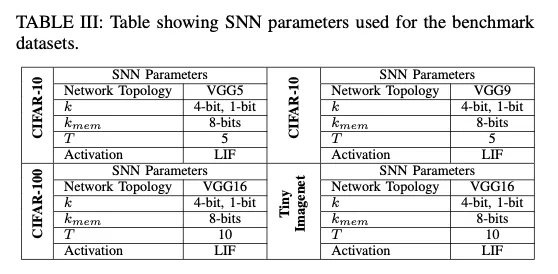
6. Comparison between ANN and SNN
几个重点:
- SNN 中的 IF 模块比 ANN 的 RELU 大将近 100 倍,因为里面的要有 SRAM 存对应的数据
- 低 Time-Step 的时候,SNN 可以取得更好的 latency 和 energy 表现,但是高 time step 的时候 SNN 的精度表现才会好