3.8 update: 面试之后反问环节学习了一下面试官工作中的 workflow,现在大规模 AI Infra 调优要关注的内容真的很多,从最底层的文件系统和存储到分布式的通信,再到 CPU 上的 workload 与 GPU 上的 workflow,整个过程中非常多的环节只要有差错就会导致整个系统的吞吐下降严重。这里写的内容基本只关注了 GPU 最多到 CPU level 的内容。有点坐井观天了。
0. GPU 编程模型
0.0 GPU 与 CPU
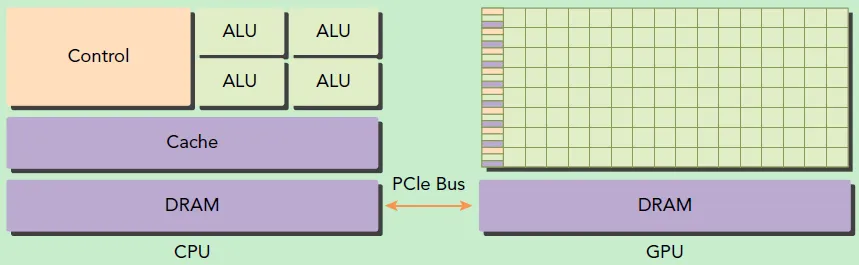
CPU:少量高性能核心,大缓存,复杂的控制逻辑结构,因此可以执行比较复杂的串行任务;
GPU:大量简单核心(ALU/Tensor Core),小缓存,流水线长但是控制逻辑简单。
这种差异使得 GPU 更加擅长做大规模并行计算(如向量/矩阵乘法),也就更适合做 AI 方向的算力(MM 等各种大规模并行计算的内容多,而设计细节逻辑控制如 if 的内容少)。
0.1. GPU 编程模型
GPU 上线程的组织结构分为三级,Grid→Block→Thread:
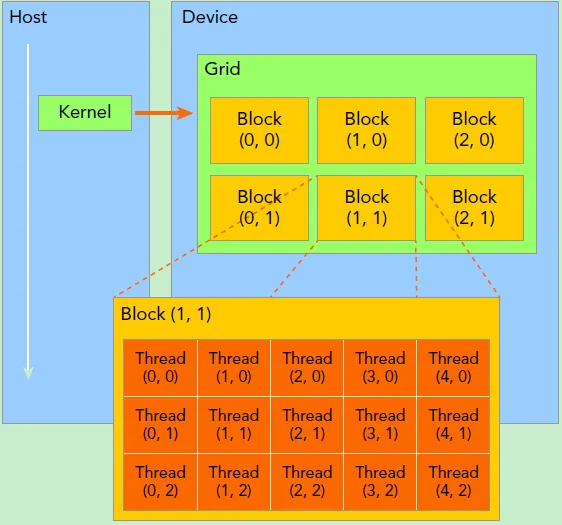
写 CUDA 的时候调用__global__或__device__声明的 Kernel 的时候会有参数<<<gridSize, blockSize>>>声明的就是这个 kernel 占用的资源数量。
这种线程组织结构非常适合做高并行度的计算,如下面给出的简单例子:
// 定义Kernel__global__ void MatAdd(float A[N][N], float B[N][N], float C[N][N]){    int i = blockIdx.x * blockDim.x + threadIdx.x;    int j = blockIdx.y * blockDim.y + threadIdx.y;    if (i < N && j < N) // 防止越界        C[i][j] = A[i][j] + B[i][j];}
int main(){    ...    // Kernel 线程配置    dim3 threadsPerBlock(16, 16);    dim3 numBlocks(N / threadsPerBlock.x, N / threadsPerBlock.y);    // kernel调用    MatAdd<<<numBlocks, threadsPerBlock>>>(A, B, C);    ...}
就可以想象成由 numBlocks * threadsPerBlock 个 thread 并行地计算 C = A + B。
同一个 threadBlock 内的所有 thread 物理上都是由同一个 SM 处理的,现代 GPU 的单个 SM 支持的最大 thread 数量可以达到 1024 个。这些 thread 需要共用寄存器等各种资源。同时,虽然逻辑上代码中很多内容可能是并行地执行的,但是在物理上则未必,因此还需要了解 GPU 的缓存结构与一些其他的具体物理结构。
0.2. GPU 存储结构
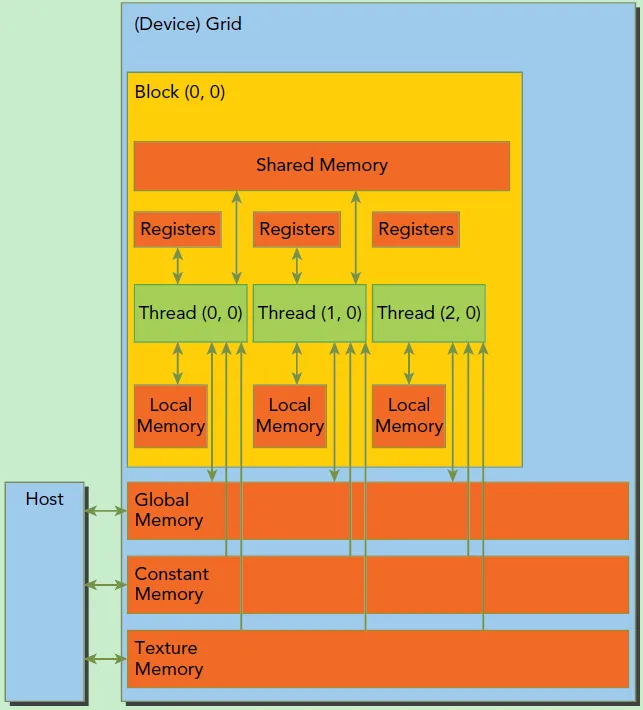
Global Memory 就是 HBM 显存。每个 threead 有自己的 Local Memory 和 Register;每个 Block 私有一份 Shared Memory,它的生命周期和 Block 一致;所有的线程都可以访问 Global Memory,以及 Constant Memory 和 Texture Memory。
- Global Memory, 就是 HBM 显存,所有的 thread 都可以访问它,在 GPU 上初始化一个值而不指定位置的时候,就在 Global Memory 里面;一般写 Host2Device 的过程,就是把数据从 CPU 内存搬运到 Global Memory 中;
- Shared Memory,每个 threadBlock 独有一块 Shared Memory,一般是几十 KB,由于 Global Memory 比较慢,一般是把 Global Memory 中,本 block 需要用到的内容搬运到自己的 Shared Memory 中,计算完之后再传回去;
- Constant Memory & Texture Memory,针对特定内容(常量或者 2D 纹理)做了优化,访问速度接近 Shared Memory 但是只能存储特定内容;一般用这两块地方优化数据访问,减少 Shared Memory 中需要的空间,比如将很多计算中不会修改的常量放在 Constant Memory 中,这样就可以又快又节省空间地完成计算;
- Local Memory,最小,每个 thread 独有,存一些临时变量;
0.3. SM, Warp and Warp Divergence
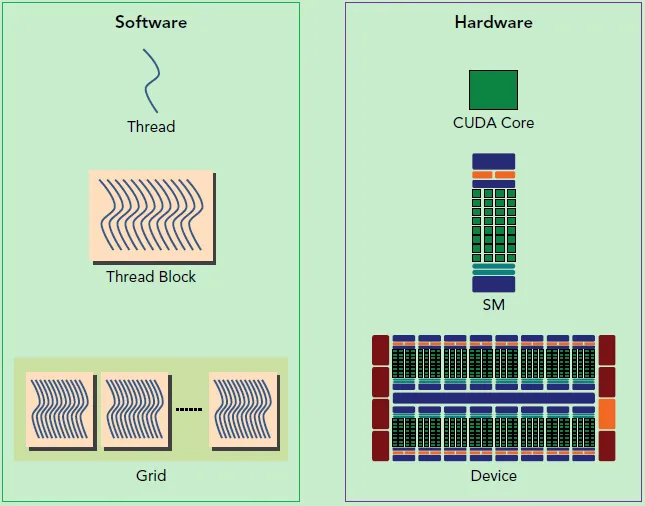
SM 的全称是 Streaming Multiprocessor,流式多处理器。当一个 Kernel 被执行的时候,它的 grid 中的 block 被分配到 SM 上。每个 block 都只能被一个 SM 调度,一个 SM 通常能调度多个 block。这意味着,一个 grid 内部的 block 可能实际上被多个不同的 SM 调度,也就是说 grid 只是一个逻辑上的结构,而 SM 才是物理上真正的结构。
SM 采用的 SIMT(Single-Instruction Multiple-Thread)结构,基本单元是 warp 而不是 thread。一个 warp 中包含 32 个 thread。这些 thread 同时执行相同的指令,但是各自有各自的寄存器和 PC。它们在遇到 if 这样的分支指令的时候实际上会有不同的路径,但是根据 GPU 结构的规定,在同一个 cycle 内一个 warp 内的 thread 只能执行相同的指令,也就是说,假设有
if (...) { /* Situation A */ }else { /* Situation B */ }在一个 warp 内产生分歧,则整个 warp 都会执行 A 和 B 两种情况,这意味着很多 thread 实际上空置了(等待另一部分 thread 完成对应分支的计算),这种情况称为 Warp Divergence,会导致非常严重的性能下降。因此在设计 CUDA 程序的时候,需要非常注意 Warp Divergence 的情况,尽量减少在 GPU 上做包含复杂逻辑的计算。
一个 SM 能够同时并发的 warp 数量是有限的,因为 SM 需要给每个 warp 内的 thread 分配寄存器、给每个 block 分配 shared memory,这意味着假设 grid 非常大,内部的 block 就会争用资源,因此 SM 分配到的 block/warp 并不一定总是并行执行的。这也导致了,分配不同大小的 grid 和 block,可能会导致程序的性能差异。另外,考虑到 warp 内总是由 32 个 thread,threadBlock 的大小一般是 32 的倍数。
0.4. Tensor Core
之前讲的 SM 内部的计算结构是 CUDA Core,比较新的显卡里面还有 Tensor Core 用于专门加速 AI 任务(主要是 GEMM)。
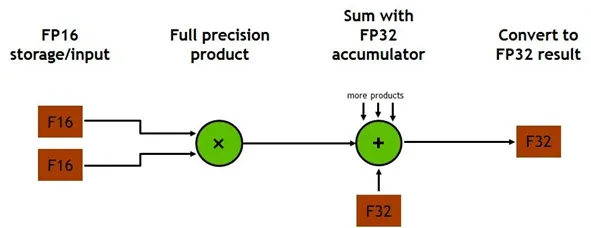
Tensor Core 支持在一个 cycle 内,完成对两个的 FP16 矩阵(张量)的 GEMM 计算,并且最终 reduce 到另一个的矩阵上,即先做乘法,然后做加法 reduce,实现,一个 cycle 完成了 64 次 FP16FMA(Fused Multiply Add),并且计算的过程中采用 FP32,这种 “混合精度” 的模式降低了精度损失。
FP16 & BF16?
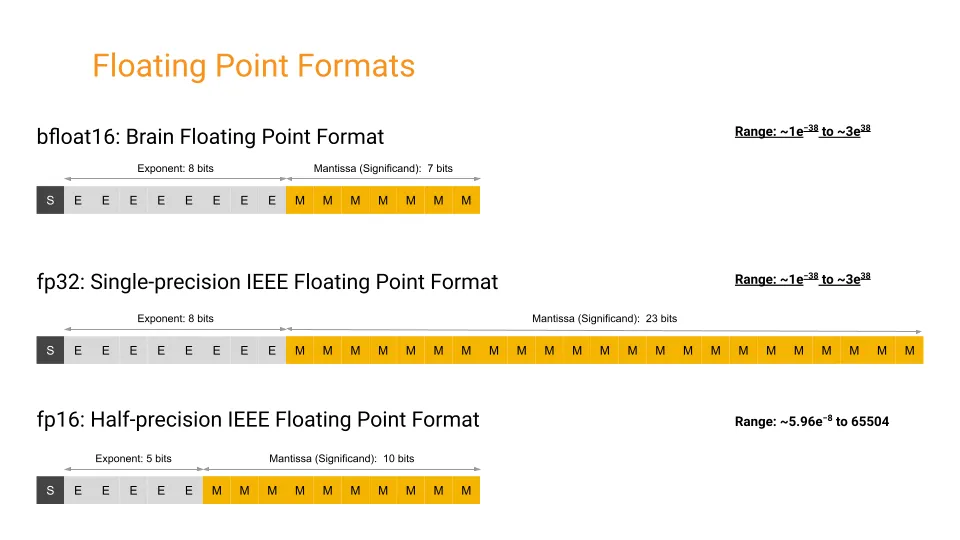
BF16 的阶码和 FP32 一样长,数值上下限接近,不太容易上下溢出,但是精度比 FP16 更低,比较容易出现舍入、转换精度丢失的问题。
0.5. CUDA Streaming
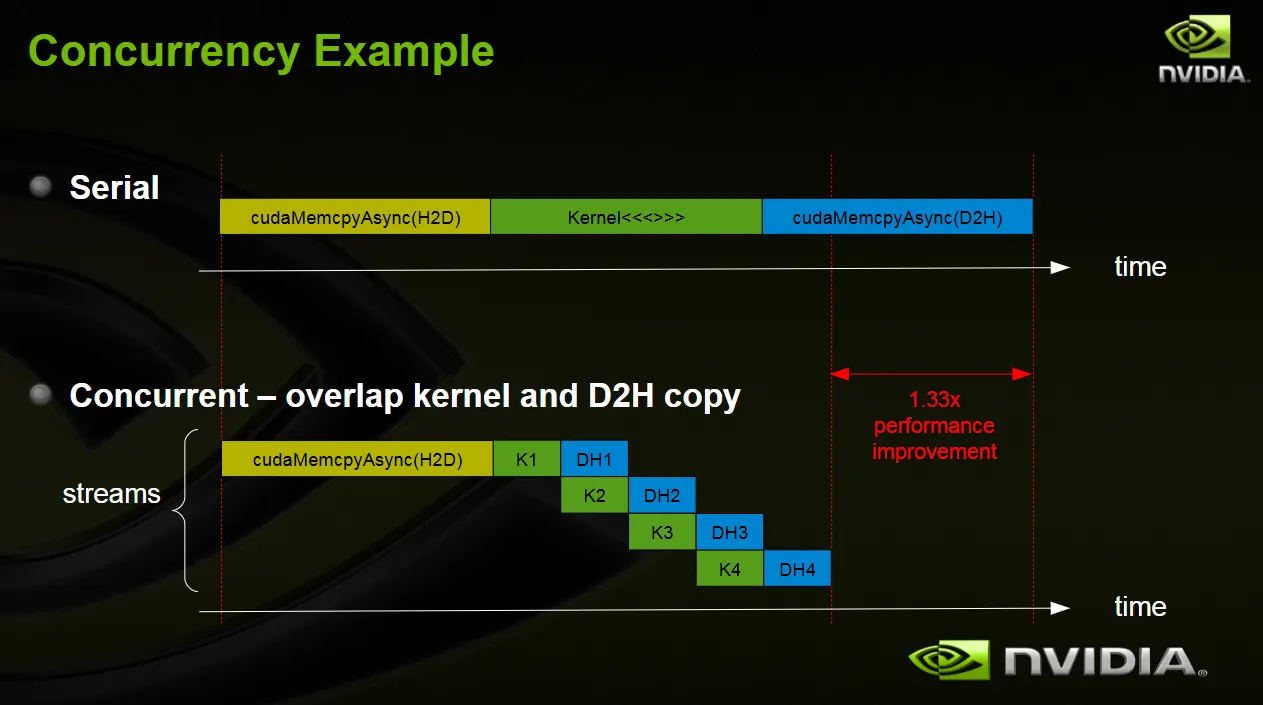
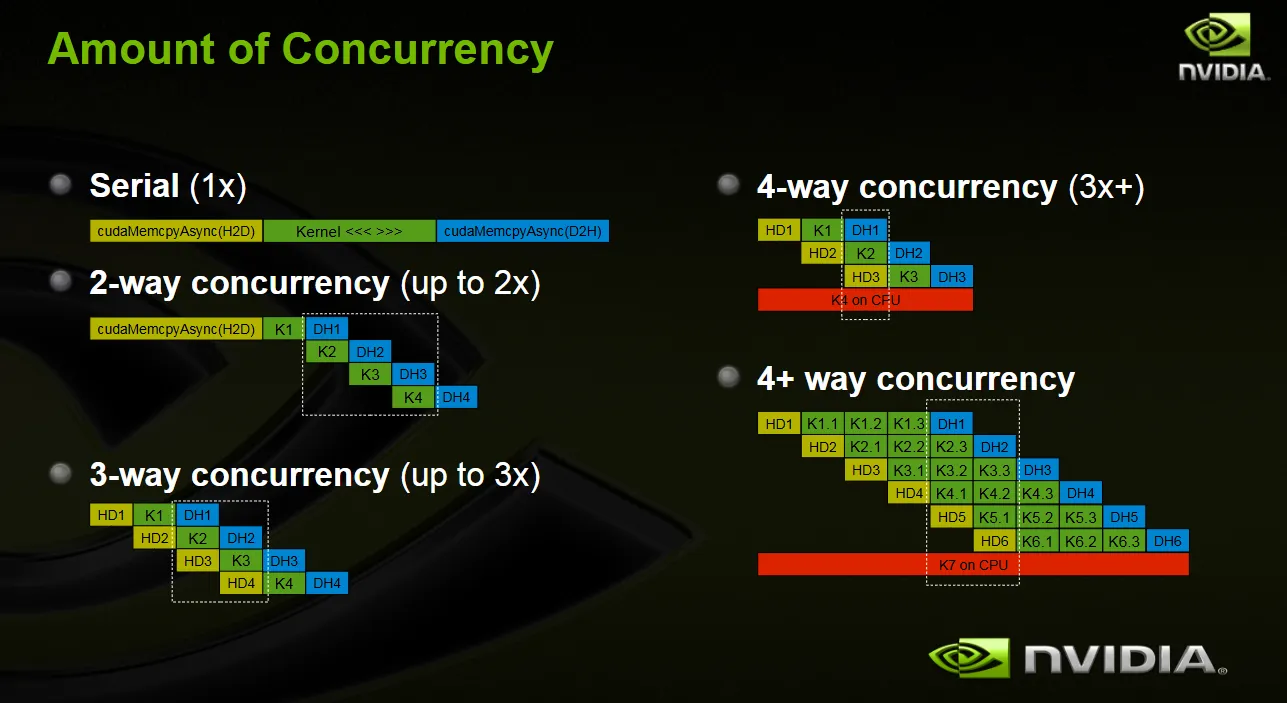
调用 myKernel<<<…>>>(…)的时候,Host 实际上很快就会返回,相当于是把这个 Kernel append 到了 GPU 的一个 “任务队列上”。访存的过程也有如 cudaMemcpyAsync()这样的异步 API 来实现。Stream 允许多个 CUDA 操作在不同的 Stream 中并行执行,提高 GPU 的利用率和性能。
每个 Kernel 都可以关联到一个 Stream 上,Stream 内部会严格保证执行顺序,上一个执行完了才会执行下一个;但是 Stream 之间不能保证执行顺序,如果没有显式地同步两个 Stream,它们就能异步执行。可以利用 Stream 实现 Kernel 之间的并行、数据搬运与计算的并行。
0.6. Unified Memory
后期的 CUDA 为了减少程序员的心智负担,提供了 Unified Memory,旨在自动管理 Host 和 Device 之间的 Memory,提供了一片看起来相同的 “Unified Memory”。使用__managed__关键字声明的全局变量会变成 Unified Memory 中的内容。
Unified Memory 中的内容:
- 可以被 CPU 和 GPU 共同访问,
- 并且是同一个指针,
- 在部分架构中还可以让 CPU 和 GPU 并发地同时访问(要注意同步)。
同时,使用 cuMallocManaged()也可以分配 Unified Memory。CUDA 会自动管理 Unified Memory 中内容的迁移和同步,让开发者不需要再 GPU 和 CPU 之间复制数据。
0.7. Profiling
根据 GPU 的硬件构造,写了 CUDA Kernel/一个 pytho 推理脚本之后可以用 Nsight System(多个 kernel,System level 的信息)和 Nsight Compute(单个 Kernel,Kernel Level 的信息)做 Profile,可以关注:
0.7.1. Occupancy
Occupancy 是一个 SM 上正在并行的 warp 数量与最大支持的并行 warp 数量之比,衡量一个 SM 是否 “满载”。如果一个 warp 因为访存产生 stal 的时候,SM 的调度器会尝试转换到其他的 warp 运行来隐藏 stall,但如果所有的 warp 都在 stall,这个 SM 就会闲置。
如果:
- thread block 太大
- 一个 block 使用的 shared memory 太多
- 一个 thread 使用的寄存器太多
都会导致一个 SM 上能够并行的 block/warp 减少,occupancy 就会降低。
需要注意的是,occupancy 只是用来隐藏 stall,但不一定意味着越高执行效率就越高。如果一个 warp 可以通过很多寄存器存储中间计算结果,会出现 SM 的 Occupancy 很低(因为能分配的寄存器少)但是计算效率很高(因为中间结果不需要去抢 shared memory 甚至 global memory 了)。
0.7.2 异步 API
调用 Kernel 和大部分 CUDA API 都是异步的,可以不阻塞 CPU,让 CPU 继续去做其他的工作,在需要处理 GPU 返回的数据的使用通过 cudaStreamSynchronize 或者 cudaEventSynchronize 显式地同步。
还可以通过 Stream 规划,下面的例子相当于让 stream1 需要搬运数据(大部分 CPU 参与)的时候,GPU 可以处理 stream2 上的 Kernel。
// 假设有h_A, h_B, h_C三个在Host上的数组// d_A, d_B, d_C三个在Device端的数组// size为数组大小cudaStream_t stream1, stream2;cudaStreamCreate(&stream1);cudaStreamCreate(&stream2);
// 异步拷贝数据到GPUcudaMemcpyAsync(d_A, h_A, size, cudaMemcpyHostToDevice, stream1);
// 同时在另一个stream上执行另一个kernelkernel1<<<grid, block, 0, stream2>>>(...);
// 等stream1传输完后,再调用下一个kernelkernel2<<<grid, block, 0, stream1>>>(...);
// 如果需要在CPU端等待其中一个或全部完成cudaStreamSynchronize(stream1);cudaStreamSynchronize(stream2);
0.7.3. Host - Device 之间的数据传输
Pinned Memory:采用 cudaMallocHost 的时候可以让一块 Host 的内存锁定,操作系统无法将它写回磁盘,GPU 用 DMA 可以快速访问这个内存,提升带宽;
可以用前面的 stream 的方法,把数据传输和 kernel 运算拆开,隐藏访存开销;还可以合并小的数据传输,一次传一块大的;
0.7.4. Kernel 中的访存
对于 Global Memory,SM 会把一个 warp 内所有 thread 的访存凑起来访问,所以尽量保证一个 warp 内 thread 的访存 stride 是合适的,不要乱序,保持 32 字节对齐,可以提高带宽利用率;
比如
__global__ void simpleKernel(const float* input, float* output, int N) {    int idx = blockIdx.x * blockDim.x + threadIdx.x;    if (idx < N) {        output[idx] = input[idx];    }}
// 这种场景下:连续访问,线程0->idx=0,线程1->idx=1..// Warp访存能合并成连续大块。
如果写成:
__global__ void badKernel(const float* input, float* output, int stride) { // 假设stride非常大 int idx = blockIdx.x * blockDim.x + threadIdx.x; int realIndex = idx * stride; // 不再是连续地址 output[realIndex] = input[realIndex];}吞吐就会降低。
对于 Shared Memory,Shared Memory 的访问很像 cache,包含 32 个 bank,数据是按照 4 字节顺序排布在 bank0 - bank31 的,一个 bank 一个 cycle 只能被访问一次。如果一个 warp 内同一个 cycle 要访问不同的地址,就需要等待变成多个指令,降低吞吐。一般通过加 padding 解决这个问题。
__global__ void sharedMemKernel(const float* A, float* B) { __shared__ float tile[32][32+1]; // 添加1列padding,避免bank冲突 // ... 拷贝时也需要注意访问方式 ...}0.7.5 指令级优化
计算 - 访存比,主要是要提高 “计算密度”,profile 的时候需要关注 roofline model。
prefetch,可以提前把下一轮要用来计算的取数据指令先发了,然后发这一轮计算的指令,这样这一轮算好了下一轮的数也快取好了。
指令重排,可以先把没有数据依赖的指令插到有数据依赖的指令之间,减少后面的计算等前面的计算的情况。
循环展开,用更多的寄存器并行算。
1. CUDA 基础
1.0. global, device, host
__global__: 在 device 上执行,从 host 中调用(一些特定的 GPU 也可以从 device 上调用),返回类型必须是void,不支持可变参数参数,不能成为类成员函数。注意用__global__定义的 kernel 是异步的,这意味着 host 不会等待 kernel 执行完就执行下一步。__device__:在 device 上执行,单仅可以从 device 中调用,不可以和__global__同时用。__host__:在 host 上执行,仅可以从 host 上调用,一般省略不写,不可以和__global__同时用,但可和__device__,此时函数会在 device 和 host 都编译。
1.1. threadBlock 指定
调用 Kernel:myKernel<<<gridSize, blockSize>>>(...)中指定了这个 Kernel 占用的资源数量。由前面的图可以知道,threadGrid, threadBlock 内部其实可以看做是二维排布的,另一种 kernel 调用的写法可以是:
dim3 blockDim(16, 16); // 2D threadBlock, 大小为16 * 16// dim3 blockDim(16, 16, 2); // 3D thread Block, 大小为16 * 16 * 2myKernel<<gridDim, blockDim>>(...);如果按照之前直接给进去一个数值的写法,其实就等价于写 dim3(blockSize, 1, 1)。在一维的场景下这么些更加方便。
同一个 Block 内部的线程会被分配到同一个 SM 上,因此调整 thread 数量一般考虑:
- 单个 SM 的寄存器资源、共享内存使用等;
- 保持 32 的倍数,因为一个 warp 是 32 个 thread;
1.2. 常见 API
- 并发和事件相关
cudaStreamCreate/cudaStreamDestroy: 创建/销毁多个 stream,实现多重并发队列。cudaEventRecord/cudaEventSynchronize: 利用 event 做某些测量或同步点。cudaStreamWaitEvent: 让一个流在另一个流上的事件完成后再执行,替代显式的 stream 同步,粒度更细。
- 异步操作 & Pinned Memory
cudaMallocHost/cudaFreeHost: 分配固定页的 Host 内存 (Pinned Memory)。异步 memcpy(cudaMemcpyAsync)+ DMA 可以提升 CPU-GPU 传输性能。cudaMemcpyAsync: 常见于让数据传输和 Kernel 执行重叠。cudaLaunchHostFunc: 允许某些回调函数在 GPU 上的工作完成后在 Host 端被调用。
- Unified Memory (Managed Memory)
cudaMallocManaged: 分配统一内存,CUDA 负责在 CPU/GPU 间迁移和一致性维护。- 一些高级特性,如预取(
cudaMemPrefetchAsync)可以在多 GPU 的平台上显式地预取到本地 GPU,以减少缺页开销。
- 原子操作
atomicAdd/atomicCAS等 Device 函数,在需要并发更新时必不可少。- 如果在 Warp 内做归约/同步,也可以用 Shuffle (
__shfl_sync) + 原子操作进行优化。
- Warp Shuffle Intrinsics
- 如
__shfl_sync,__shfl_down_sync,__shfl_xor_sync等,可以在 Warp 内交换数据做归约,而不必借助 Shared Memory。对小规模并行归约或 prefix-sum 有用。
- 如
- 流图 (CUDA Graph)
cudaGraphCreate、cudaGraphAddKernelNode、cudaGraphInstantiate、cudaGraphLaunch等。- 可以把一段反复执行的、带有依赖关系的流/Kernel/Memcpy 记录成图,实例化后重复执行。通常可以减少 driver overhead,提高性能,对推理场景也常见。
- 多 GPU 相关
cudaSetDevice、cudaDeviceCanAccessPeer、cudaDeviceEnablePeerAccess: 在多 GPU 间直接 peer2peer 传输数据,提升多 GPU 并行计算的效率。- 或者使用更高层库 (NCCL) 做多 GPU/allreduce 通信。
一个GPT生成的GEMM Kernel:
#include <cstdio>#include <cstdlib>#include <cuda_runtime.h>
// Block大小,用于Tile的尺寸#ifndef BLOCK_SIZE#define BLOCK_SIZE 16#endif
// 简单的检查CUDA错误的宏#define CUDA_CHECK(call)                                                       \    do {                                                                       \        cudaError_t err = call;                                               \        if (err != cudaSuccess) {                                             \            fprintf(stderr, "CUDA error at %s:%d: %s\n", __FILE__, __LINE__,  \                    cudaGetErrorString(err));                                  \            exit(EXIT_FAILURE);                                               \        }                                                                      \    } while (0)
// Kernel:对 (M x K) * (K x N) -> (M x N) 做分块乘法__global__ void gemmKernelTiled(const float* __restrict__ A,                                const float* __restrict__ B,                                float* __restrict__ C,                                int M, int N, int K){    // block 内 线程对应的行列索引    int row = blockIdx.y * BLOCK_SIZE + threadIdx.y;    int col = blockIdx.x * BLOCK_SIZE + threadIdx.x;
    // 在 shared memory 中缓存 A、B 的分块    __shared__ float As[BLOCK_SIZE][BLOCK_SIZE];    __shared__ float Bs[BLOCK_SIZE][BLOCK_SIZE];
    float sum = 0.f;
    // 以 BLOCK_SIZE 为步长,逐步把 A、B 的不同子块载入 shared memory,并做局部乘法累加    for (int tileIdx = 0; tileIdx < (K + BLOCK_SIZE - 1) / BLOCK_SIZE; tileIdx++) {        int A_col = tileIdx * BLOCK_SIZE + threadIdx.x; // A的列        int B_row = tileIdx * BLOCK_SIZE + threadIdx.y; // B的行
        if (row < M && A_col < K) {            As[threadIdx.y][threadIdx.x] = A[row * K + A_col];        } else {            As[threadIdx.y][threadIdx.x] = 0.f;        }
        if (col < N && B_row < K) {            Bs[threadIdx.y][threadIdx.x] = B[B_row * N + col];        } else {            Bs[threadIdx.y][threadIdx.x] = 0.f;        }
        __syncthreads();  // 同步后再进行本 tile 的累加
        // 累加当前 tile        for (int i = 0; i < BLOCK_SIZE; i++) {            sum += As[threadIdx.y][i] * Bs[i][threadIdx.x];        }        __syncthreads();    }
    // 最终结果写回 C    if (row < M && col < N) {        C[row * N + col] = sum;    }}
int main() {    // 1. 设置矩阵维度,比如 512 x 512    int M = 512, K = 512, N = 512;    size_t sizeA = M * K * sizeof(float);    size_t sizeB = K * N * sizeof(float);    size_t sizeC = M * N * sizeof(float);
    // 2. 分配主机内存(Pinned Memory)    float *h_A, *h_B, *h_C;    CUDA_CHECK(cudaMallocHost((void**)&h_A, sizeA)); // pinned    CUDA_CHECK(cudaMallocHost((void**)&h_B, sizeB));    CUDA_CHECK(cudaMallocHost((void**)&h_C, sizeC));
    // 初始化数据    for (int i = 0; i < M*K; i++) {        h_A[i] = static_cast<float>(rand()) / RAND_MAX;    }    for (int i = 0; i < K*N; i++) {        h_B[i] = static_cast<float>(rand()) / RAND_MAX;    }
    // 3. 分配设备内存    float *d_A, *d_B, *d_C;    CUDA_CHECK(cudaMalloc((void**)&d_A, sizeA));    CUDA_CHECK(cudaMalloc((void**)&d_B, sizeB));    CUDA_CHECK(cudaMalloc((void**)&d_C, sizeC));
    // 4. 创建 stream,准备做并发拷贝和 Kernel    cudaStream_t stream1, stream2;    CUDA_CHECK(cudaStreamCreate(&stream1));    CUDA_CHECK(cudaStreamCreate(&stream2));
    // 5. 异步传输 A, B 到设备 (stream1, stream2都可以)    CUDA_CHECK(cudaMemcpyAsync(d_A, h_A, sizeA, cudaMemcpyHostToDevice, stream1));    CUDA_CHECK(cudaMemcpyAsync(d_B, h_B, sizeB, cudaMemcpyHostToDevice, stream2));
    // 6. Kernel 配置    dim3 block(BLOCK_SIZE, BLOCK_SIZE);    dim3 grid((N + BLOCK_SIZE - 1) / BLOCK_SIZE,              (M + BLOCK_SIZE - 1) / BLOCK_SIZE);
    // 7. 发起 Kernel 到 stream1, 同时可以让 stream2 做别的事    gemmKernelTiled<<<grid, block, 0, stream1>>>(d_A, d_B, d_C, M, N, K);
    // 8. 异步拷回 C 到 host (依然是 stream1, 可以等 Kernel 完成后再执行)    CUDA_CHECK(cudaMemcpyAsync(h_C, d_C, sizeC, cudaMemcpyDeviceToHost, stream1));
    // 9. 同步,确保计算和拷贝都完成    CUDA_CHECK(cudaStreamSynchronize(stream1));    CUDA_CHECK(cudaStreamSynchronize(stream2));
    // 这里可以验证一下结果正确性(和 CPU 端简单矩阵乘法对比),省略...
    // 10. 清理    cudaStreamDestroy(stream1);    cudaStreamDestroy(stream2);    cudaFree(d_A);    cudaFree(d_B);    cudaFree(d_C);    cudaFreeHost(h_A);    cudaFreeHost(h_B);    cudaFreeHost(h_C);
    printf("Done.\n");    return 0;}
要点说明:
- Pinned Memory:通过
cudaMallocHost分配,Host 内存页锁定,可被 GPU DMA 高速读取。 - 异步操作:
cudaMemcpyAsync+ 指定 stream,使数据传输和 Kernel 调用都可以异步排队,不必让 CPU 阻塞等拷贝完成。- 在示例里,我们把拷贝 A、B 到不同流
stream1、stream2,然后在stream1上发起 Kernel 并拷回 C,演示多流并行思路(可根据场景再进一步拆分)。
- Tiled GEMM:
- 通过 shared memory
As、Bs做分块缓存,减少 Global Memory 的访问次数。 - 每个 Block 处理
BLOCK_SIZE x BLOCK_SIZE的输出子块。 - 通过
__syncthreads()先把 A、B 的子块读入 shared memory,再进行乘加累积。
- 通过 shared memory
这个 Kernel 关于 AB load 的时候应该有点问题,现在这个写法不能保证 B 被 load 完 kernel 才开始执行。
2. 推理优化
2.1. 模型量化
模型量化是为了在不太损失精度的情况下,将参数从全精度降低到 8B 甚至更低的精度的整数或别的数据,降低内存通信带宽和显存占用的同时,还能利用 INT8 或其他的推理引擎实现低功耗高吞吐的模型推理。
模型量化的基本公式可以写作:
scale 控制缩放,zero_point 将数值对齐到某个位置,round 的策略比较多种,可能四舍五入也可能是别的,用于把数值转换到整数域来。量化一个模型就是针对每个 Layer/Channel/…,找到一个合适的 scale 和 zero_point(对于混合精度量化,还有比特位宽),让模型的精度不要大幅度下降。
一般来讲,推理的时候会把模型按照上面的公式逆推回 FP32 的原精度,虽然增加了计算量,对模型的量化主要是降低了存储和读取模型的带宽需求,这样提升了运算速度(大部分时候模型还是以访存为瓶颈)。
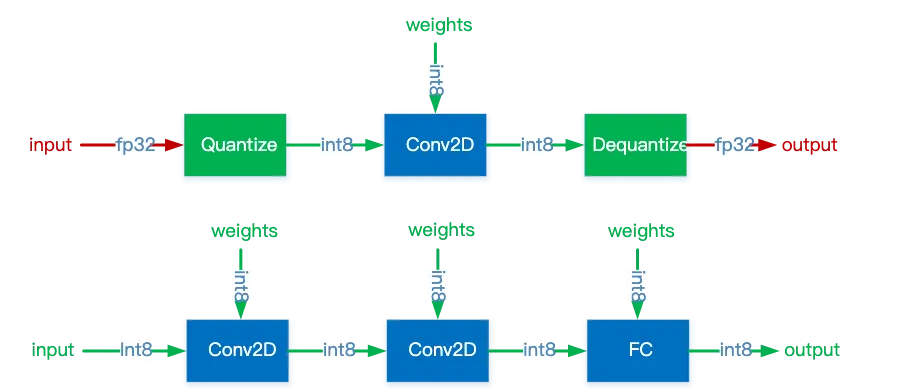
量化模型推理的时候,有的采用混合精度推流,在遇到需要量化的层的时候就把全精度的内容量化到低精度,推理完之后再进行解量化还原成全精度;有的则直接采用纯整数推理,全程都是用量化后的精度进行推理。
2.2.0 量化算数
量化乘法:
在量化后的模型里面,输出的乘法都会被这样计算,会融合到一个 kernel 中。如果各个 channel 之间的 scale 不同,并且需要做加法,那么也需要做相似的操作。
量化 scale 的选取:
- MinMax
很容易被 outlier 影响,比如大部分点都在之间但是有一个 100,量化考虑的数据范围也会落在上,精度容易受影响,尤其是量化 Activation 的时候更严重。
- Moving Average MinMax
带动量地平滑掉一部分 outlier
- KL 散度量化
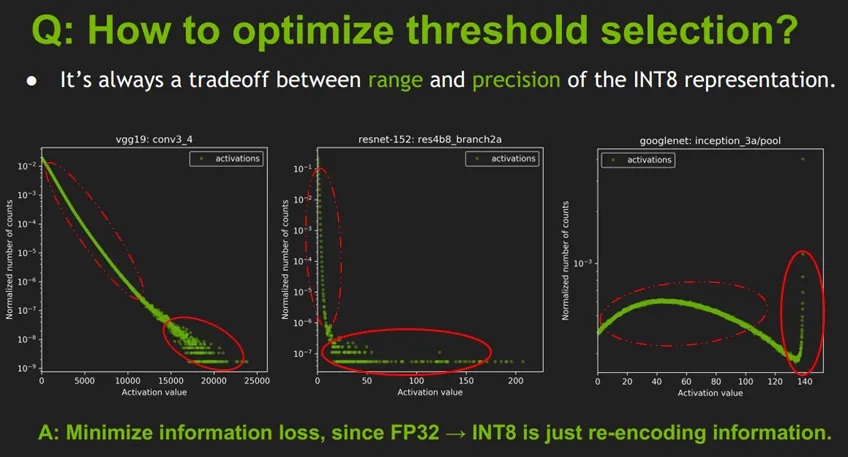
考虑上面这种,不同 layer 之间有不同的数据分布,如果直接考虑最大最小值进行线性地映射,就可能会
先对数据做直方图统计,遍历备选,超出阈值的会被合并到边界中,然后计算 KL 散度:
用 KL 散度估计量化后的数据分布和量化前的数据分布的相似程度,如果越相似证明量化损失的信息越少。
2.1.1. PTQ
Post Training Quantization 在训练阶段就正常训练,一般的流程为:
- 训练一个
FP32模型; - 准备少量的 calibration 数据,一般是几千个或几百个,让原模型进行推理,推理过程中统计每一层的权重和激活值的分布,这样可以得到最大最小值,进而可以得到合适的量化区间(也就得到了 scale 和 zero_point);
- 直接将权重量化成对应的低精度形式,推理的时候也要对激活做对应的量化。
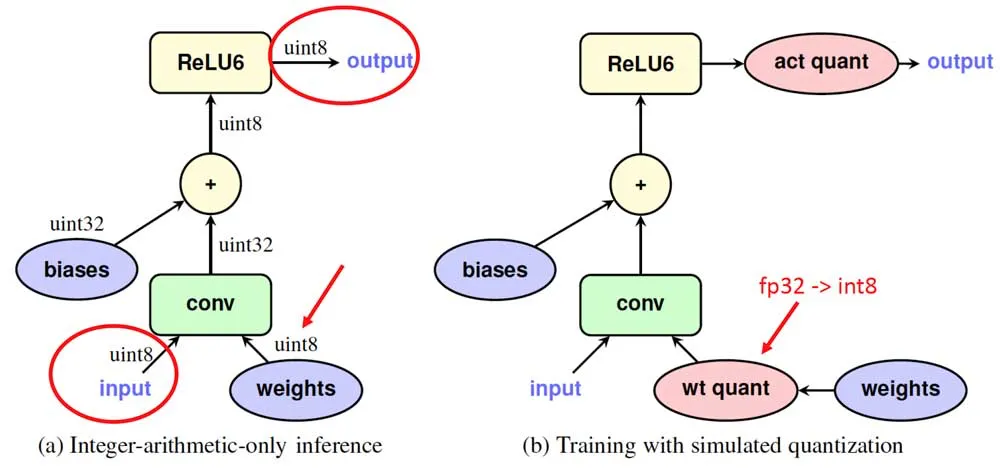
2.1.2. QAT
在训练的时候插入一些 Fake Quantization 算子,在 forward 的过程中模拟量化后的状态,反向传播的时候还是用 FP32,从而在训练的时候更好地调整权重分布,同时利用训练中的统计信息调整 scale 和 zero_point。
QAT 的精度一般会比 PTQ 的更高,但是需要在训练的过程中就引入 Quantization 的过程,开销比较大(训练比推几个 calibration data 难多了)。
2.1.3. Integer Only
一般来说,LayerNorm、Softmax、GELU 这样的层其实很难被量化,很多工作在这些层上都会用 FP32 代替。
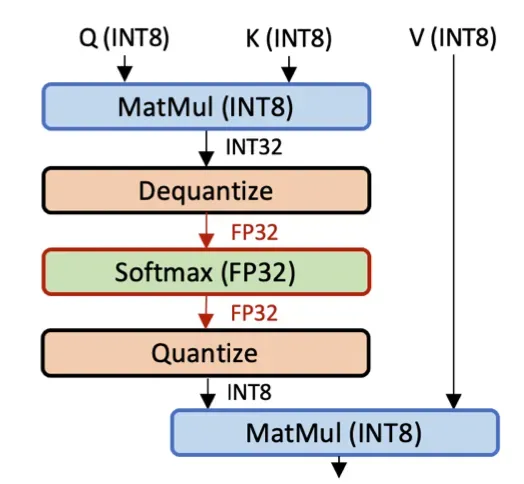
这样做推理效率很差,会在全精度推理的 layer 形成瓶颈。纯整数的方法基本是考虑用二次或者三次近似的方法,将这些函数转换成多项式,然后把量化方程带入这些多项式函数,再按照之前的方法进行化简。有的还会把其中包含的 FP 系数进一步优化为迭代 + 位移操作,完全消除所有的整数操作。里面包含的 scale 一般会分解为两个 int 一个代表乘数一个代表移位。
2.2. 剪枝与蒸馏
2.2.1. 模型剪枝
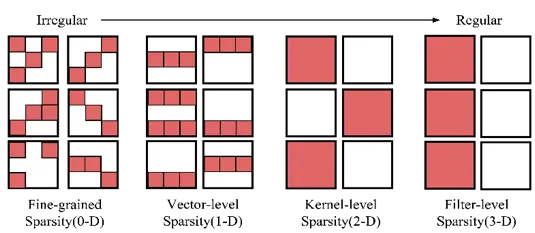
一般是根据 weight 的绝对值大小或者梯度等指标,直接把小的数值设置为 0,然后如果存储模式和硬件都支持稀疏化的优化,就能减少运算和存储。
有各种不同的剪枝粒度,但是太小的 GPU 不好利用,太大的掉点太厉害,要么是在很细粒度然后剪枝做到 90% + 的稀疏度然后利用稀疏编码处理。
2.2.2. 模型蒸馏
通过一个已经训练好的 Teacher 指导一个更小的 Student 模型进行训练,从而使得 Student 模型在精度上接近 Teacher,但参数和计算量更小。有的会用 Teacher 输出的 Logits 或者 Softmax 分布指导 Student 的学习,也有的会在不同的 layer 上插入,让 Student 的特定 layer 模仿 Teacher 的特定 layer。
2.3. 推理框架
2.3.1. TensorRT
NVIDIA 家的高性能推理引擎,针对 CUDA GPU 做优化,主要优化机制包括:
- Kernel Fusion,在网络的计算图层面将多个 operation 融合成单个 Kernel,最典型的是 Convolution + Bias + BatchNorm + ReLU,这样一次操作之后可以在一个 Kernel 内部完成所有的计算,避免了数据多次写回显存再读入的开销,降低了 Kernel Launch 的次数和内存的带宽占用,这种称为 “横向融合”;另一种 “纵向融合” 是,TensorRT 可以将网络中多支路中相同的 Kernel 融合成一个更宽(channel 数更多)的 Kernel,目标也是产生更大的 Kernel,让 GPU 的计算粒度更粗,减少调度开销的同时提供更多优化的可能性(更高的计算强度);
- 自动 FP16/INT8 量化,可选 PTQ 还是 QAT;
- Layer Tactic,主要是针对各种 Kernel 的各种情况实现了不同的高效算子(如来自 cuDNN、cuBLAS 或者自己实现的),针对模型和目标硬件,选取最高效的进行计算,有点类似 TVM 等编译器做的事情。
- 其他的更复杂的包括:常量折叠,编译时确定某些数值在推理之前就能够确定结果,直接在编译期间算好,按照一个常量存到程序中;多流执行,根据模型的计算图自动分配到不同的 stream 以期并行执行;
2.3.2. TVM
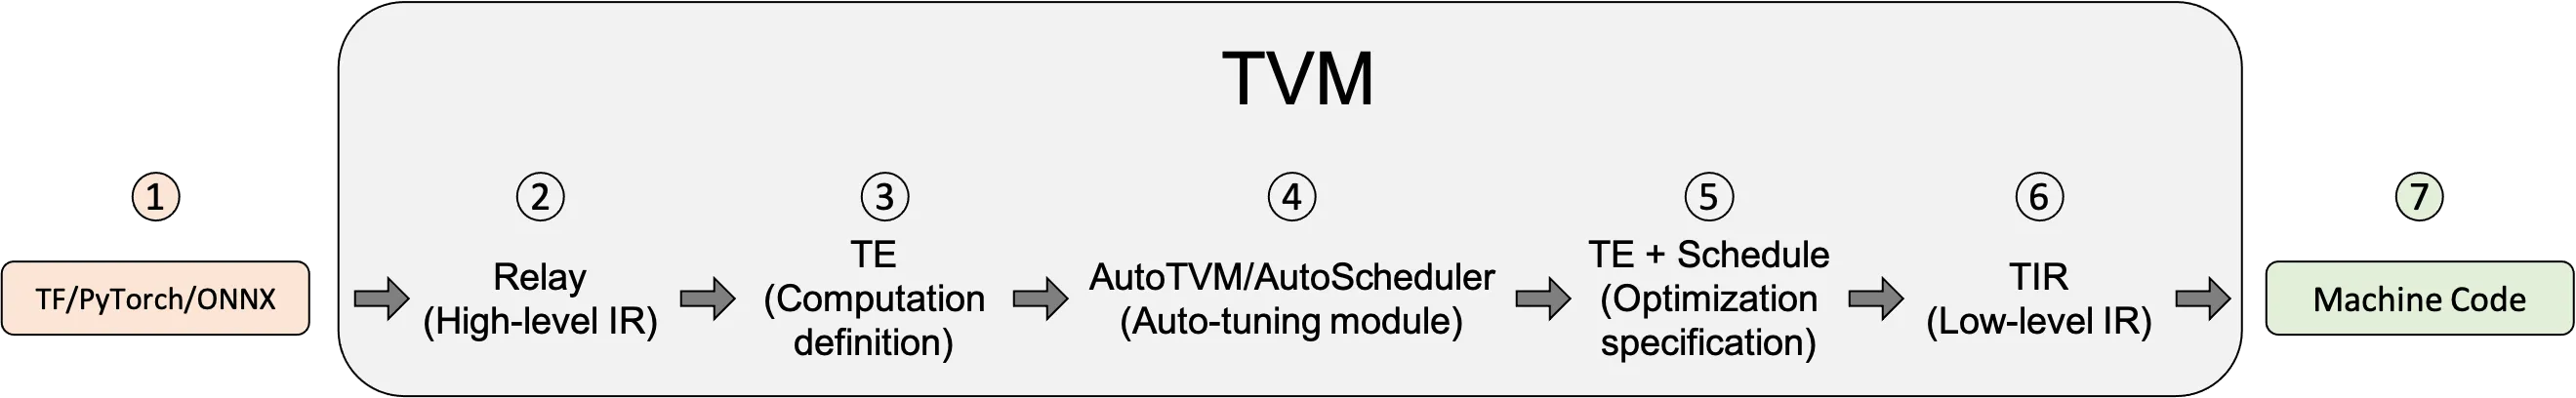
一个深度学习编译器,通过引入中间表示,希望适配不同的模型到不同的后端上,都能够完成高效的优化和计算。
TVM 的整体结构可以分为以下几个关键组成部分:
- 前端:TVM 支持多种深度学习框架的模型作为输入,比如 TensorFlow、PyTorch、MXNet、Keras 等。通过这些前端接口,TVM 可以读取不同框架定义的模型,并将其转换成中间表示(IR)。
- 中间表示(IR):TVM 使用两级 IR,即 Relay 和 TIR(Tensor IR)。Relay 是一种高级 IR,用于表示高级神经网络算法;而 TIR 是一种低级 IR,用于表示更接近于硬件的操作和优化。
- 自动调度(AutoTVM/AutoScheduler):为了在特定硬件上获得最佳性能,TVM 提供了自动调度工具,如 AutoTVM 和更现代的 AutoScheduler,它们可以自动优化模型的计算图和内核实现。
- Runtime:TVM 提供了一个轻量级的运行时,支持模型在目标硬件上的部署和执行。这包括对多种设备的支持,如 CPU、GPU、FPGA 等。
- 编译流程:TVM 的编译流程包括模型的加载、优化(例如算子融合、内存优化)、自动调度、代码生成等步骤,最终生成可以在目标硬件上运行的机器码。
2.4. 杂项优化
2.4.1. 重排
访问内存的时候一般还是希望是连续访存,这样效率最高,但是有的 kernel 存在 stride 过大或者访问顺序和传统的 NCHW 内存排布模式不匹配,在做 GEMM 中常见的优化就包括调换循环顺序以期获得最高的吞吐。在现代 GPU 上一般比较适合用 NHWC 的格式更加友好,而 CPU 上一般喜欢用 NCHW。
Transformer 中的 QKV 向量一般按照[seq_len, num_heads, head_dim]存储,也是为了适应访存模式 + 对齐数据。
3. 训练优化
不完全地说,部分训练优化措施解决的问题都是因为显存不足引发的。因为显存不足导致需要使用多卡乃至多机器进行训练,而扩大了 device 量也导致了更多的通信,这种通信引入的延迟又进一步引入了更多的问题。当然训练实际上也有很多其他的问题需要解决,比如数值稳定性等,训练过程需要解决 FP 的精度上下溢引入的问题,训练本身的梯度消失/梯度爆炸的问题,在特定场景下收敛困难的问题等。但感觉 Infra 领域,主要需要解决的各种问题还是显存不足引发的各种问题。
3.1. 显存相关
3.1.1. Automatic Mix Precision
在 forward 和 backward 的过程中,大部分时候用 FP16/BF16 做计算,只在做梯度累加或其他可能导致数值不稳定的操作的时候,再用 FP32 做计算。并且,在 backward 的过程中,还会乘以一个缩放因子避免 FP16 精度太低产生的下溢,反向结束算完梯度之后再除以相同的数值。
3.1.2. Activation Checkpointing
显存特别小的情况下,可以不保存所有的中间层的 activation,只保存一部分关键 layer 的激活,当反传的需要对应的数值的时候,再重新算一遍,用时间换空间;
3.1.3. Gradient Accumulation
希望用大 batch 但是显存不够的时候,可以把做多次前向把梯度累加几次,然后再做一次反传,可以在相同的精度下模拟更大的 batch,但是计算频率降低了,可能对精度有影响。
3.2. 并行训练与通信
3.2.1. Data Parallel
每张卡上都是完整的模型,会给不同的 input/batch,这样每张卡自己做自己的 forward + backward,然后全局的梯度 All Reduce 同步更新。这种做法最简单,通信量小,torch 的 DP, DDP 都属于这种方法。
DP 的问题是,如果 model 足够大,大到一张卡装不下了,这种时候 DP 就直接没办法训练了,就需要把 model 切分到多张卡上。
3.2.3. Model Parallel
将一个模型在多张卡上分片分块存储,可以进一步分为:
- Pipeline Parallel,将模型不同的 layer 放在不同的 GPU 中,多个 GPU 串行执行,在多种输入下形成 pipeline,通信最少,但是在 LLM 时代一个 layer 要占用的内存可能就比一张卡的显存大了,这种时候就不能用;
- 假设一个大 batch 推进去的话会有很多气泡,pipeline 不起来,所以一般是打很多小的 batch 连续计算,方便提高吞吐
- 适合深度较大的网络
- Tensor Parallel,如果一层都大到放不下,就要考虑将 layer 内部进行的矩阵计算按照行或者列拆分到不同的 GPU 上,每个 GPU 算一个小部分,然后通过 AllReduce 或者 AllGather 合并结果;
- Megatron-LM 的实现是每张卡拥有一些 tensor 列,计算的时候只计算自己负责的这部分,反向传播的时候才汇集到一起;
- DeepSpeed 是计算的时候每张卡都会从其他的卡同步,恢复成完整的参数张量再进行计算;
- 其他的组合方式,比如 Tensor + Pipeline + Data Parallel 三级都有,或者类似 ZeRO 这种更加灵活的可以把 Optimizer State 等各种都分片。
4. LLM 相关
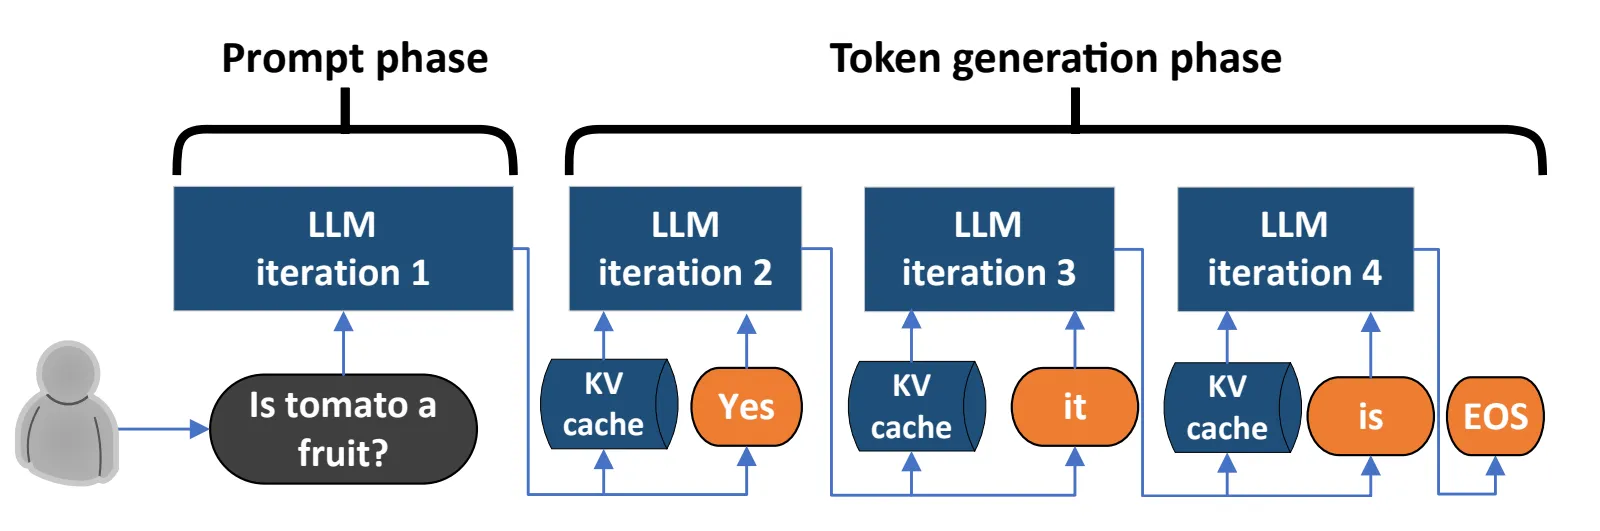
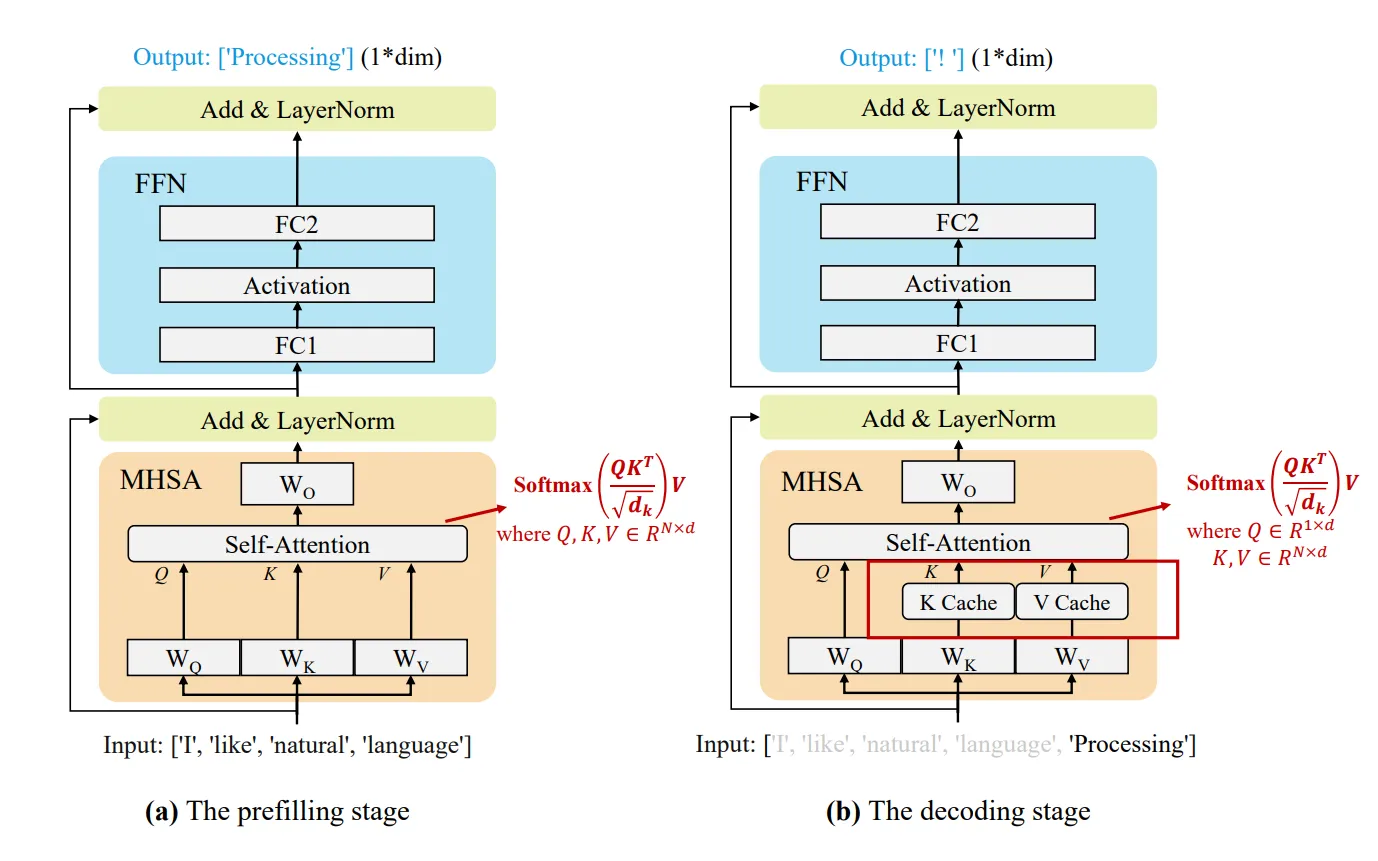
LLM 的推理可以分成 Prefill 和 Decode 两个阶段,Prefill 阶段是处理用户输入,而 Decode 阶段是自回归地生成输出。
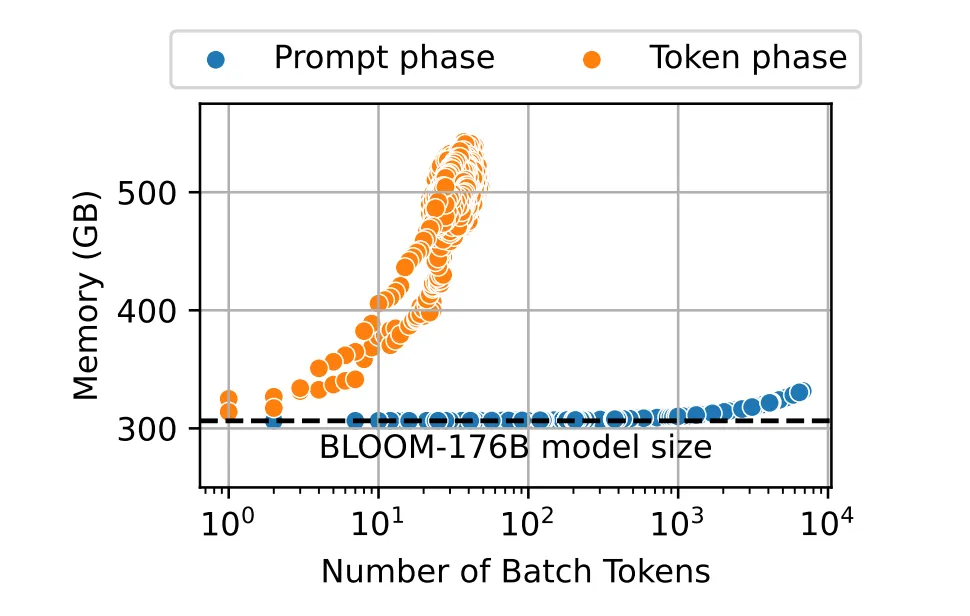
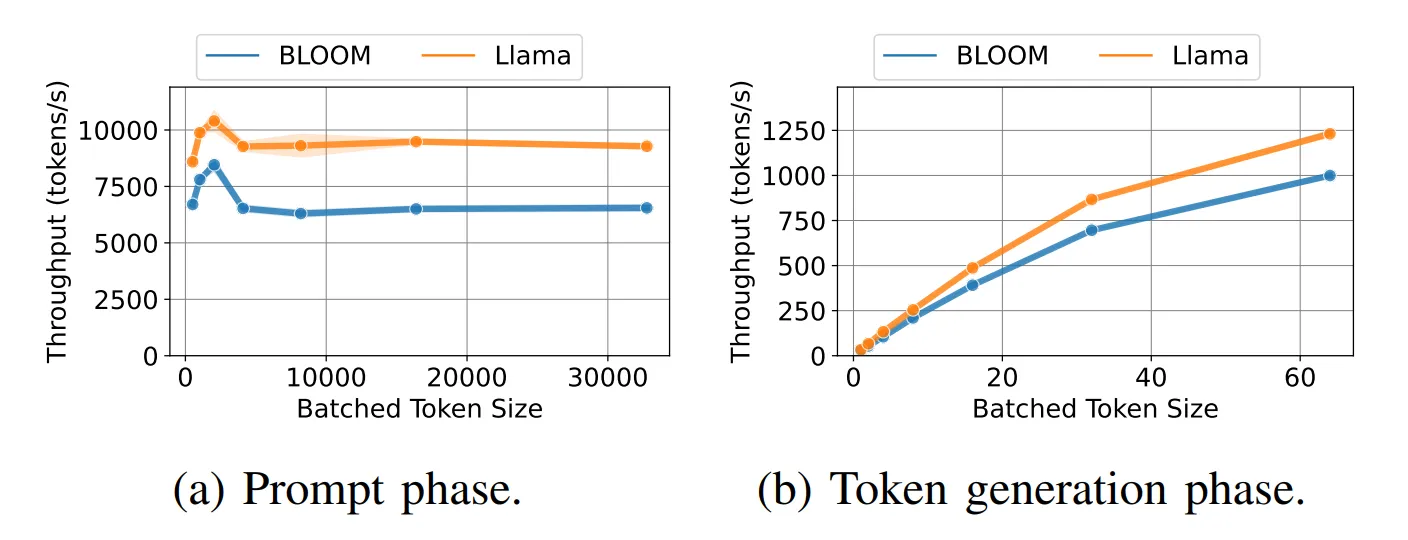
可以看到 Prefill 阶段的访存次数远少于 Decode 阶段,而计算量则刚好相反。所以针对两个阶段有不同的优化策略,对于 Prefill 阶段是典型的 Computer bound,而对于 Decode 阶段则是 Memory Bound 阶段。
4.1. Flash Attention
传统 Self-Attention 计算的时候会形成一个 seq_len * seq_len 的中间矩阵,要做现代 LLM 64K 甚至 128K 上下文长的话,这个中间结果已经大到不可接受了。
Flash Attention (v1) 将 Attention 的计算过程做了 reorder 和 tiling,让几乎所有的中间结果都只在 Block Level 存在,这意味着只需要保存到寄存器或者 Shared Memory 中,而不需要大量向 HBM 中读写内容。

Softmax 可以写作:
算 Attention 的时候做分块,分块后的向量 softmax 的流程变为:
- 输入 , 计算
- 保存
- ,这个数值是有问题的,因为和目前都不是全局的数值
- 输入,计算
- 更新
- 计算
- 更新
- ,这个值就是正确的了
- 利用新保存的信息更新之前的有问题的值,即

这样分块计算能更好利用 Memory Locality,减少 HBM 访问,增大吞吐。虽然引入了的额外计算,但是吞吐更高了。
4.2. KV Cache
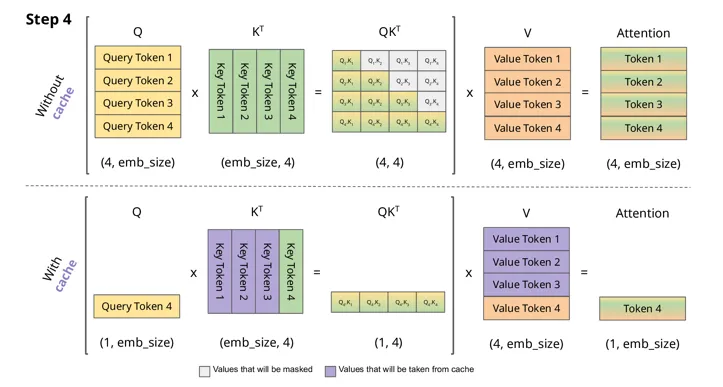
紫色部分就是 KV Cache,因为自回归模式生成的前面这些内容都是被重复利用的,这样可以大幅度减少计算。
4.3. MQA, GQA, and MLA
一般而言,KV Cache 能够占到系统总体显存占用的 30% 左右,也非常大。因此,降低 KV Cache 的大小同样也是一个很重要的优化手段。
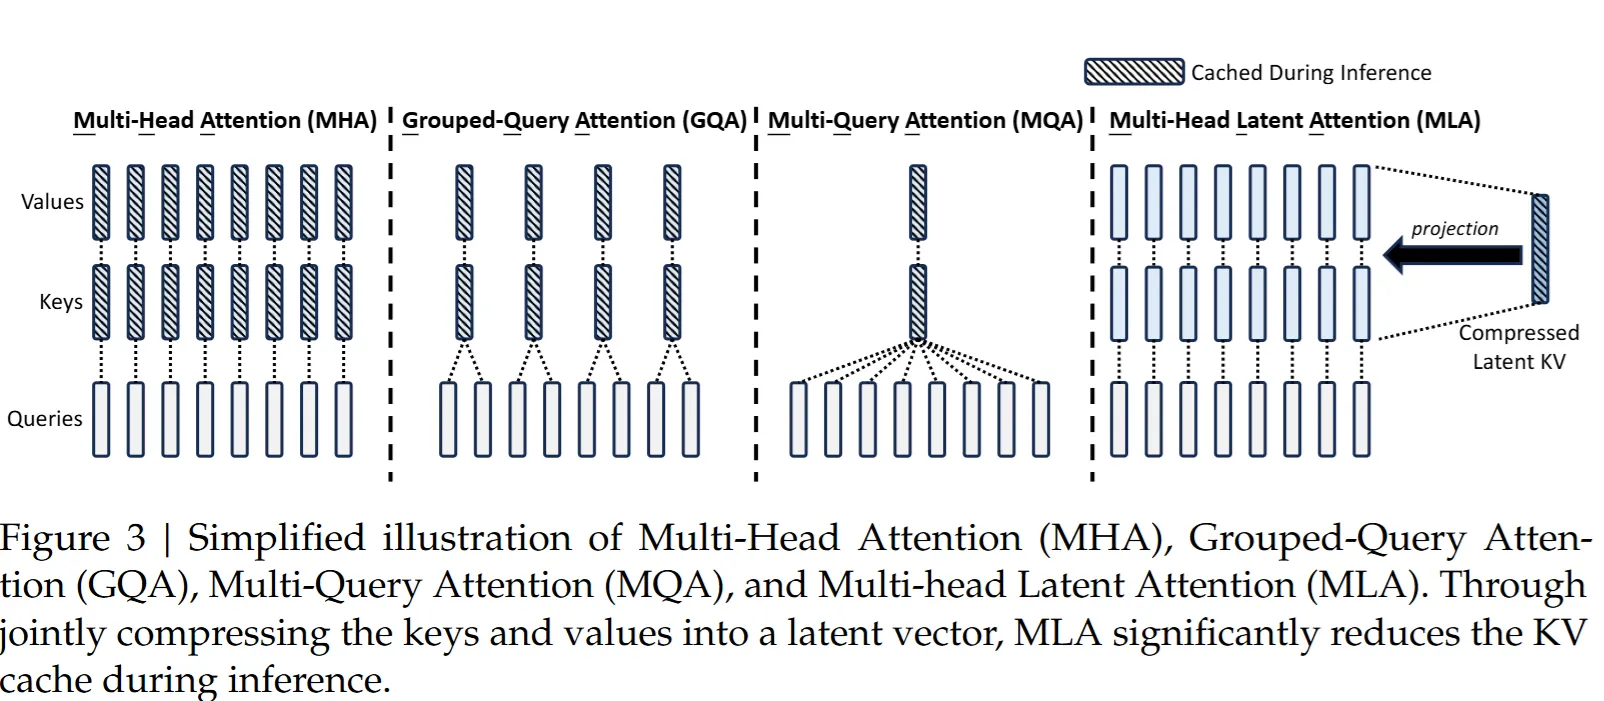
Multi-Query Attention, MQA 认为可以让所有的 Query 共享同一个 KV,原文的作者认为这样做精度损失并不大,并且共享相同的 KV 还意味着整个模型的参数量也减少了,这部分可以在后面的 FFN 补回来,把精度补回来一部分。
然而,也有人会担心 MQA 对 KV Cache 压缩太多了,会影响到整个模型的学习效率和结果,因此提出了 Grouped-Query Attention,将 head 分为若干组,每组共享一对 KV。也就是当只分一组的时候,GQA 就退化成 MQA,而分组数量等于 head 数量的时候就会变回 MHA。
MLA 则是通过一个压缩的 Latent KV Cache,在计算的时候通过线性变换还原到更大的大小。具体细节这里暂时不写,离简单的推理/训练优化的主题太远了,中间还涉及到 LoRA 相关的内容,就之后再单独写一篇 MHA 的文章学习一下论文吧。
参考内容:
国内大厂 GPU CUDA 高频面试问题汇总(含部分答案) - 知乎
developer.download.nvidia.com/CUDA/training/StreamsAndConcurrencyWebinar.pdf
https://www.cnblogs.com/sasasatori/p/18337693
https://zhuanlan.zhihu.com/p/570795544
https://zhuanlan.zhihu.com/p/505570612
https://zhenhuaw.me/blog/2019/neural-network-quantization-introduction-chn.html
https://medium.com/@joaolages/kv-caching-explained-276520203249