Looped Model 在套用传统量化方法时遇到了新的问题。普通前馈模型里每一层有各自独立的参数矩阵,而在循环模型里,模型在 的每一步读取的都是同一份核心权重,如果直接用静态量化(比如舍入 Roud To Near, RTN),相当于在连续 次迭代里每一步都往循环里反复注入完全相同的权重误差矩阵。
从 SNN 的 IF Neuron 等收到启发,下文尝试了 IFneuron,或者说一阶 在 PTQ、QAT、W4A4 部署和硬件微基准上的实验结果。总体上来讲,在循环步上做权重 在冻结权重的 W4A16 前向推理里确实能把输出失真压下去不少;但在 QAT 里,它在主权重上并没有稳定比过相同设置下的随机舍入(SR);在 W4A4 评测里,表现最好的组合并不包含权重 ;同时在核心线性层的微基准测速中,在线生成量化码也没有拿到端到端的速度收益。
0. 循环模型里的误差传播与 NVFP4 精度分工
0.1. 误差传播
先看循环模型前向传播的形式。记输入经过 prelude 之后的初始隐状态为 ,在接下来的 次循环访问中,每一步迭代调用同一个映射 ,最后经过 coda 层 得到输出分布:
在全精度模型里,每一步访问的都是同一份精确权重 。考虑把核心层量化,设第 次访问实际使用的量化权重为 ,其中 是第 步的权重量化误差(这里把每一步的权重写成可以随步数 变化的 ,方便后面同时分析静态量化和每步换码的动态方案)。
把第 步隐状态偏离全精度轨迹的一阶扰动记作 ,在高精度轨迹 附近做一阶展开,可以得到单步的误差递推:
其中 是第 步循环块对隐状态 的雅可比矩阵, 是对权重的局部雅可比。由于初始状态 不受 core 权重量化的影响(),把这个递推从第 1 步展开到第 步,中间每一步的误差累积过程就是:
再把最后一步隐状态的扰动 投影到最终的损失 上,总的一阶 loss 偏差可以写成各步权重误差与敏感度的内积和:
是把共享权重在时间上解绑之后,第 次访问对最终 loss 的敏感度,里面已经包含了从第 步到第 步的下游传播 。为了分析这 次访问里到底有几步在起主要作用,可以用参与率的形式定义一个有效访问深度 :
需要注意的是,循环里的误差传播并不一定会随步数按指数级放大,具体表现为收缩还是振荡,取决于各步雅可比 的谱特征。在 Huginn-0125()上实测局部敏感度分布,算出来的有效访问次数 大约只有 ,其中最后 3 次访问就占了全部敏感度平方和 的 。这说明起码在 Huginn 上,前面几十步注入的扰动在往后传的过程中很大一部分已经衰减掉了,最终输出对最后几步的权重误差最为敏感。
0.2. NVFP4 的精度分工
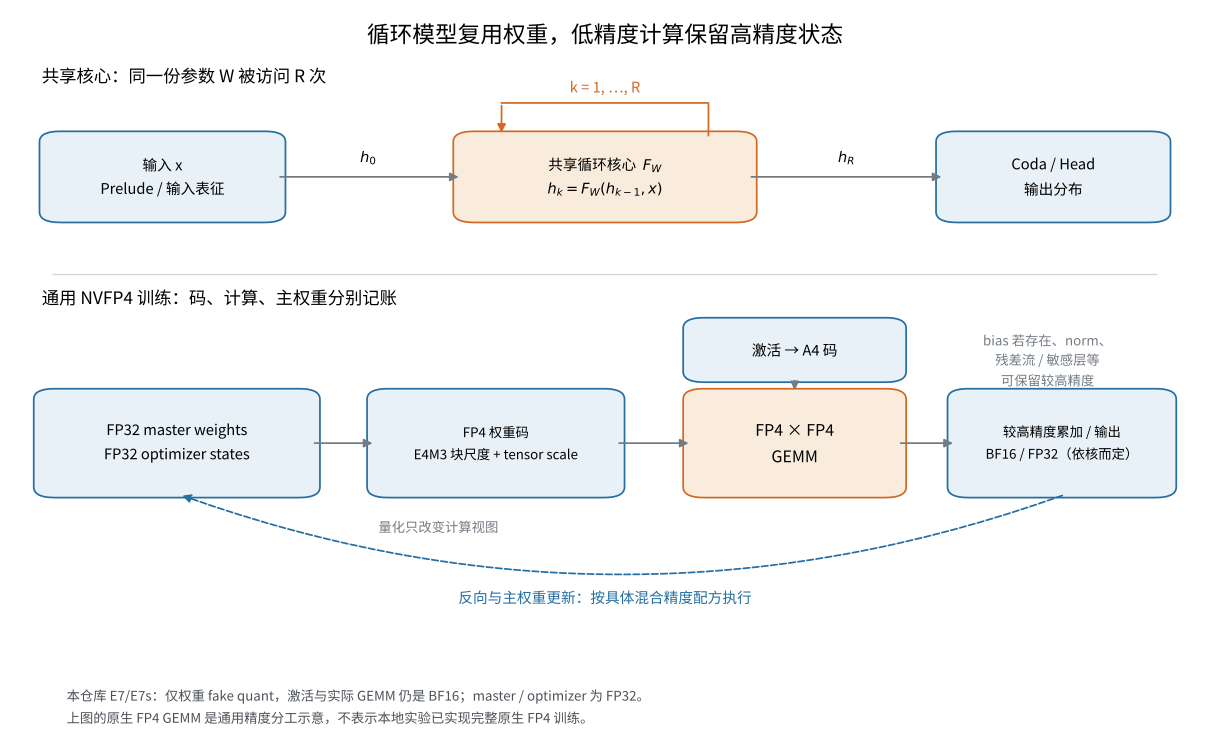
在具体讨论怎么压低这个误差之前,先明确一下我们关注的低比特格式 NVFP4 以及它在训练中的精度分工(见图 1)。
NVFP4 采用 4-bit 的 E2M1 浮点表示(1 位符号、2 位指数、1 位尾数),它在正半轴上的 8 个离散格点为:
加上正负号一共 16 个编码,由于 重合,实际对应 15 个不同的数值。因为 E2M1 本身的数值范围很小,NVFP4 使用两级缩放:每 16 个连续元素组成一个块(block),配一个 FP8(E4M3)格式的块尺度 ,整个张量再乘一个 FP32 的全局尺度 :
后文我们在 Parcae-140M 上做的本地继续训练实验,同样保留了 FP32 的主权重与优化器状态、用 BF16 作为计算视图,但为了隔离观察共享权重量化本身的影响,只对 core 里面的 13 个 Linear 层权重做了伪量化,非 core 权重和 bias 不量化,激活、反向传播以及实际的 GEMM 算子仍然保持高精度(norm、rotary、loss 和尾段阻尼累加可用 FP32)。
1. 相关工作
针对循环语言模型的低比特量化,最近已经有几篇工作从不同角度给出了方案。
一类做法是把常规 LLM 的 PTQ 方法(旋转变换、缩放与 GPTQ)适配到循环结构上。Loopy77 在共享核心上使用跨步共享的旋转与缩放变换,在挑量化参数时直接对齐目标深度下的 NLL,并配合渐进式的全深度评估。LoopQ88 做了 loop-aware 的通道缩放、可折叠进权重的特定变换以及沿循环轨迹的激活校准(trajectory calibration),并在每个循环步上施加独立的低秩跨步修正项(CTA)和偏置。更早一些,Hyperloop Transformers99和 Nux Li1010 讨论过如何汇总所有访问步的统计量来构造跨步 GPTQ Hessian,并分析了循环模型里的反馈暴露(feedback exposure)与校准盲区(calibration blindness)——只按单步局部误差做校准,放到多步闭环里误差会逐步偏离校准分布。
把 调制 用到神经网络权重上同样有先例。Frame Quantization1212 在冗余框架表示下分析过神经网络的 量化;SDQ-LLM1313 则把 用在大模型的 1-bit / 三值权重量化上。因为普通前馈模型每层权重只算一次,SDQ-LLM 必须靠显式的空间过采样(spatial oversampling)来造出序列维度;而在循环模型里,同一份权重本来就要沿着迭代深度 被连续访问 次,直接顺着循环步做时间维度的 是一个很自然的想法。在低比特训练方向上,除了 NVFP4 预训练方案66与 4/6 块尺度55之外,Quartet II1414 探索了用局部无偏梯度估计来改进 NVFP4 训练,然而局部算子的无偏估计放进多步非线性循环复合之后,并不保证全局的训练梯度也是无偏的。
2. 循环步上的 Σ-Δ 调制与尾段阻尼
2.1. 一阶 Σ-Δ
既然静态 RTN 在循环模型里的主要问题是每一步都重复注入同一个误差 ,一个直接的改进思路是在每次访问时换用不同的量化码,让多步之间的误差互相抵消。随机舍入(SR)靠随机采样让单步条件期望等于原权重;一阶 调制 则是通过确定性的误差反馈来实现抵消——把第 步量化剩下的余差(residue) 存下来,加到第 步的输入上再做最近舍入。
固定量化尺度 ,从零初始余差 开始,在每次访问 上执行递推:
把单步量化误差 用 和 代换,可以直接写成相邻两步余差的差分:
对前 次访问的误差求和,中间项全部裂项相消:
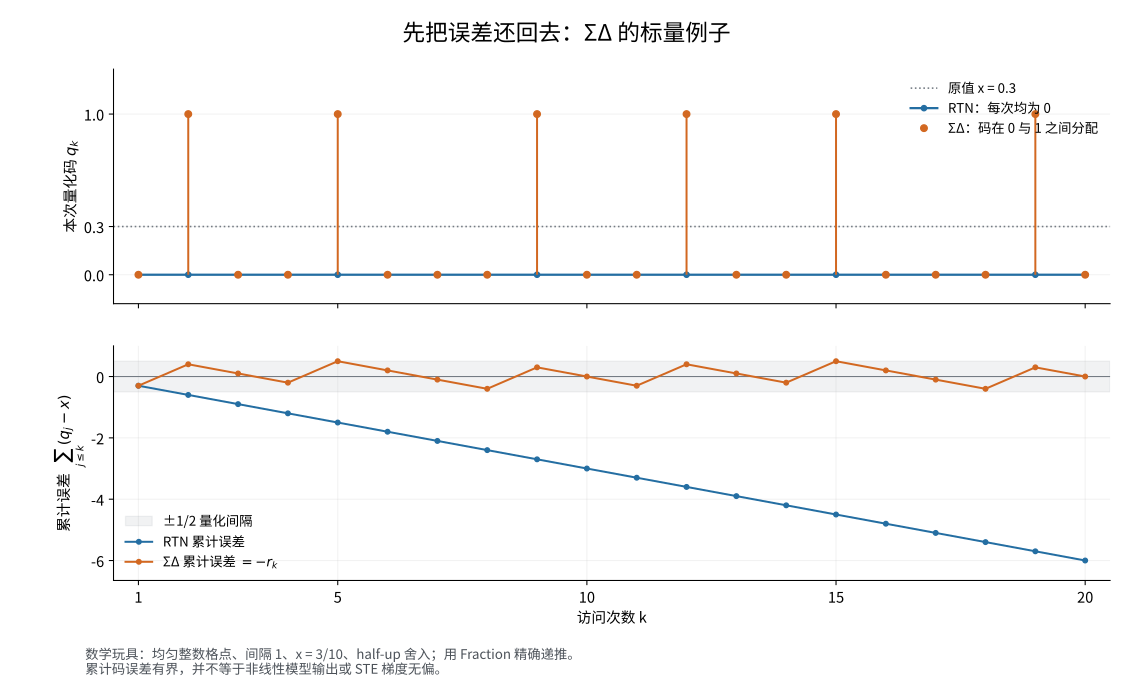
只要余差 有界,前 步量化权重的平均偏差就会按 衰减。拿均匀整数格点(间隔为 , 舍入)上的标量 举例:静态 RTN 每一步都取 ,单步误差固定为 ,累积误差随步数线性发散;而一阶 前 8 步的递推数值如下表所示:
| 访问 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 0.3 | 0.6 | −0.1 | 0.2 | 0.5 | −0.2 | 0.1 | 0.4 | |
| 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | |
| 0.3 | −0.4 | −0.1 | 0.2 | −0.5 | −0.2 | 0.1 | 0.4 | |
| −0.3 | +0.7 | −0.3 | −0.3 | +0.7 | −0.3 | −0.3 | −0.3 |
通过每隔几步跳出一个 ,前缀累积误差始终等于 ,被限制在 之间(图 2)。
2.2. 非均匀 NVFP4 码本上的保守余差界
因为 NVFP4 的格点是不等距的,不能直接把均匀量化的 套上去。不过对于当前从零余差出发的递推实现(无 phase、无 pin,同一条链内尺度固定),在理想算术下仍然可以证明一个保守的权重表示误差界。
一般地,令有限一维码本为 ,记端点 、,最大相邻格距为 。固定输入 (输入必须落在真实码本的凸包 内,不能扩到任意外部区间,否则如 、取 时余差会发散),取区间外饱和到端点的最近舍入量化器 ,按 递推,则对每个 都有 :
- 初值 满足界;假设 。
- 因 ,有 。
- 若 ,由最大相邻格距定义和最近舍入直接给出 。
- 若 ,量化器饱和到 ,故 ; 时对称得到 。
- 归纳即得 ;结合裂项式 ,前 步的平均误差不超过 。
应用到有符号 E2M1 码本上:它的实际数值端点是 ,最大相邻格距为 。4/6 块缩放在默认全局尺度 下,候选 E4M3 块尺度向上取整后不管是映射到 还是映射到 ,都保证归一化权重 。因此即便反馈输入 临时达到 ,端点饱和仍然保证归一化余差 。设 为该块的实际解码总尺度,在权重单位上就有:
这是逐元素、逐块尺度下的保守界(不同块的 不能当成同一个常数),它只约束权重的平均表示误差,并不能由此推出非线性网络的最终 loss 也按 下降;同时该证明针对的是递推 F4,不覆盖后文微基准测试中使用的两点闭式差分实现 F4b。
2.3. 分部求和与逆序尾段
把 代入前面的一阶 loss 扰动式 ,利用 做分部求和(阿贝尔变换),可以得到:
从这个式子可以看出,如果相邻步之间的敏感度变化很平缓( 很小)且末端边界项 也小,一阶 loss 误差就能在步间大部分抵消掉(这两条属于有利条件,不是严格必要条件)。但直接把正序 放到预训练好的循环模型上跑,马上会遇到两个具体问题。
第一个问题是末端边界项的位置。前面测 Huginn 的敏感度分布时已经看到,最后几步的 是最大的。如果正序跑完 步,没消掉的余差 刚好乘在最大的敏感度 上。在冻结权重推理(PTQ)里,为了避开这个边界项,可以在前 次访问先用普通的 RTN 码,到最后 次尾段访问(总步数 固定)时从 重新起一条长 的 链,但把这 个码倒过来用(第 次尾段访问取 ):
逆序之后,最后一步访问拿的是链上的第一个码(也就是普通 RTN 码,这里 把 消掉了,但要注意最后一步本身是 RTN 误差 而不是零误差),而整条链剩下的边界项 被挪到了尾段入口处的 ,那里的敏感度比最末端小得多。
2.4. 负模态与尾段阻尼
第二个问题是 产生的高频交替误差在负模态下会被放大。 的本质是把零频(常值)误差推向高频(正负交替)。用一个常系数实标量递推来近似局部单模态的误差响应(设 ):
当 且注入常值误差 时,稳态响应为:
当注入纯交替误差 时,稳态幅值为:
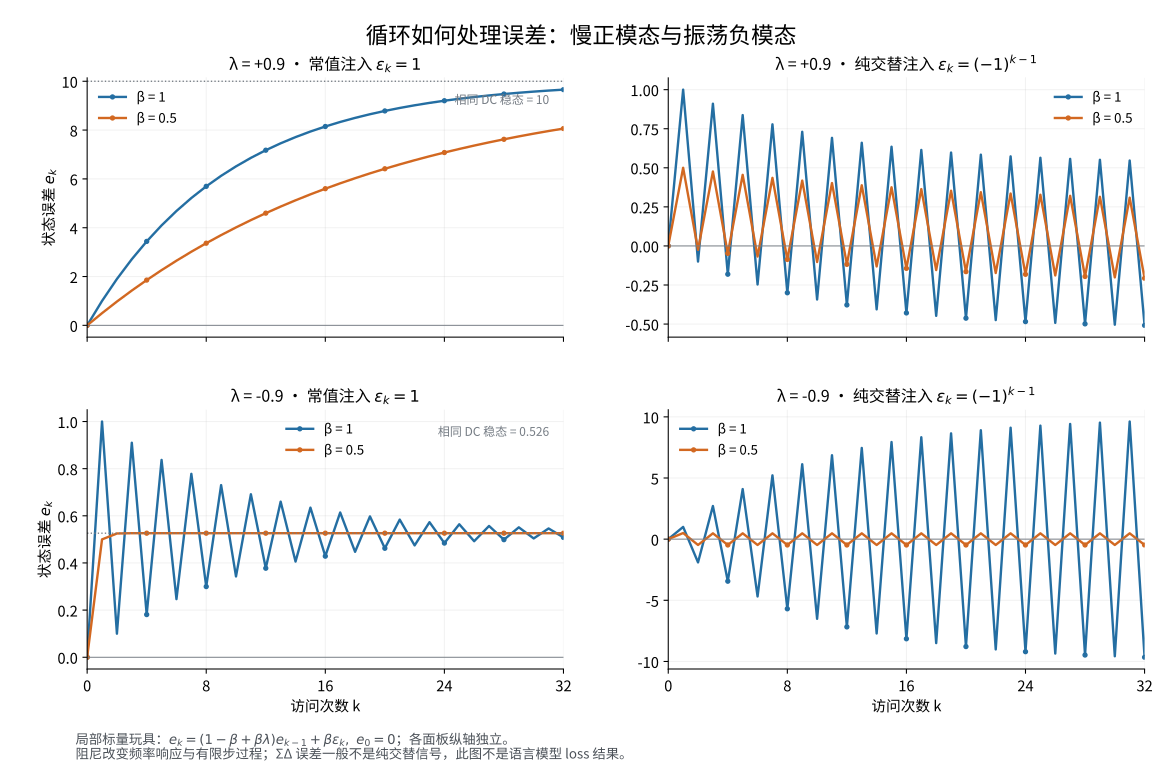
如果该模态为正(比如 ,满足 ),常值注入会被放大 倍,而交替注入只有 ,做高频整形自然有利。但如果局部存在靠近 的负模态(比如 ,对应相邻步敏感度反号,差分 反而变成相加),常值注入的稳态只有 ,正负交替的高频注入却会跟 同相叠加,稳态幅值被放大到 。
这也和局部的数值探测对应:拿 Parcae-140M 的预训练 checkpoint(,不做 QAT)直接测前向 NLL 缺口,静态 RTN 的缺口是 ;在这个设置下如果不加阻尼直接上 ,缺口反而扩大到 ,直接上随机舍入 SR 更是扩大到 (当然这不代表在所有设置下不加阻尼都一定更差,比如部分 INT4 设置下不加阻尼的 相对于 RTN 依然能有正收益)。
为了压住这种高频振荡,可以在尾段对隐状态做显式的阻尼更新(damping):
此时标量误差递推变成:
在满足 的条件下,再看两种注入下的稳态响应:
可以看到,阻尼对常数注入的稳态放大倍数 没有任何影响(分子分母的 约掉了),所以它并不能帮静态 RTN 消除正模态下的常值偏差;但对交替注入来说,它把有效极点从 拉到了 。当 、取 时,有效极点变成 (满足 ),原本靠近 的高频放大直接被压了下去(图 3)。在刚才那个 Parcae-140M 预训练 checkpoint()上,给 加上尾段阻尼后,NLL 缺口就从 降到了 。
从数学性质上讲,对于一个固定的自治映射 ,当 时,阻尼更新不会改变它的不动点集合(即 与 等价);但在有限的 步循环里,加阻尼是会改变输出轨迹的,而且当每一步用的是动态变化的量化权重 时,也不能直接套用固定自治映射的结论。不过在 Huginn 上实测 BF16 下改用 16+16, β=0.5 阻尼调度,相对原标准调度的 在 FineWeb 上只有 ,在 FineMath 上也只有 ,相比量化误差本身要小得多。
2.5. 实现细节
把这套做法用到 PTQ 和 QAT 时,两边的具体配置有一些差别:
| PTQ | QAT | |
|---|---|---|
| 链从哪开始 | 前 次用 RTN 码;尾段从 重新起一条长 的链 | 每次 forward 从第 1 次访问起跑一条长 的链 |
| 码的使用顺序 | 逆序,最后一次访问拿链上第一个码 | 正序 |
| 阻尼区间 | 尾段 次(Huginn 16+16,Parcae-1.3B 8+8) | 最后 次, 为该微批采样的深度 |
| 块尺度 | 由冻结权重算出,所有对照方案共用 | 每次 forward 由当前 master 重算,forward 内固定 |
QAT 阶段因为每次微批采样的深度 在变,且权重和敏感度分布在随训练更新,直接从第 1 次访问起正序跑一条长 的链、对后半段 步加阻尼更直接。核心前向逻辑用 PyTorch 写出来如下:
# W: FP32 master;D: 本微批采样的深度;beta: 尾段阻尼系数s = block_scale_46(W) # 4/6 块尺度,本次 forward 内固定x = W / s # 归一化权重r = torch.zeros_like(x) # 余差,每次 forward 清零for k in range(1, D + 1): v = x + r q = e2m1_round(v) # 就近取 E2M1 码 r = v - q # 没表达出去的部分留给下一次访问 W_k = W + (s * q - W).detach() # STE:前向用码,梯度直接回到 W f = F(h, e, W_k) h = f if k <= D - D // 2 else (1 - beta) * h + beta * f3. 实验结果与分析
3.1. PTQ
其中 以同阻尼调度的 BF16 为参考, 以原版无阻尼标准调度的 BF16 为参考。实验在 Huginn-0125(16+16, β=0.5)和 Parcae-1.3B(8+8, β=0.5)上各测 128 篇文档 tokens,所有方法共用同一套 4/6 块尺度与阻尼调度(SR 使用 seed 42 生成的一条固定权重轨迹在各文档上共享;95% 置信区间由 2000 次配对文档 bootstrap 算出,不含独立 SR 轨迹的重采样方差)。按 统计的比值如下表与图 4 所示:
| 模型 | / RTN | SR / RTN | / SR(95% CI) |
|---|---|---|---|
| Huginn | 0.175 | 0.455 | 0.385 [0.374, 0.399] |
| Parcae-1.3B | 0.335 | 0.811 | 0.413 [0.382, 0.450] |
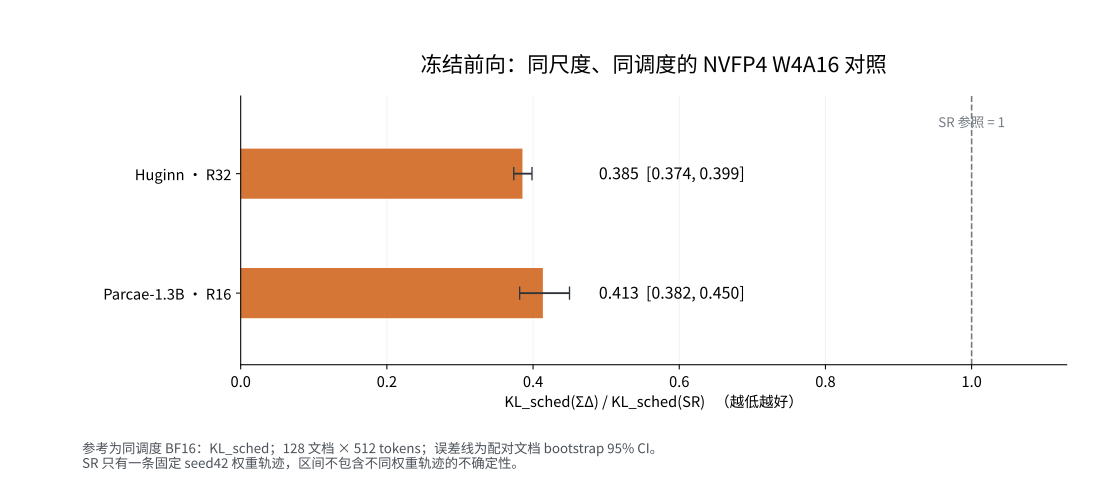
在 Huginn 上,RTN、SR 和逆序 的平均 分别为 、 和 , 把散度压到了 RTN 的 、SR 的 ;在 Parcae-1.3B 上三者平均 分别为 、 和 , 是 RTN 的 、SR 的 。如果换成相对原始调度的 ,比值同样接近:Huginn 上 / RTN 为 [0.188, 0.211], / SR 为 [0.406, 0.440];Parcae-1.3B 上分别为 [0.310, 0.368] 和 [0.384, 0.452]。另外在同家族 IFM(819M)的 6 个 checkpoints 上测试, / SR 的比值也都落在 之间。
为了确认逆序 的收益到底是不是来自码字的排列顺序,在 Huginn(INT4 g32 W4A16,16+16, β=0.5,64 篇文档)上做了一组打乱消融:保留逆序 生成出来的同一组码字集合(multiset),仅把它们在尾段各步之间的使用顺序随机打乱,测得的 如下:
| 逆序 | 同一组码打乱顺序 | 独立 SR | RTN |
|---|---|---|---|
| 0.0072 | 0.0132 | 0.0160 | 0.0342 |
同一组码一旦打乱顺序, 就从 退化到 ,接近独立 SR()。这说明在 PTQ 里,步与步之间的顺序配合确实是关键。
3.2. QAT 与二阶机制猜想
接下来看 QAT 的表现。从 Parcae-140M 预训练 checkpoint 出发继续训练 300M tokens(573 步,microbatch 8,global batch 256,序列长度 2048,验证集 10M tokens),跑了 seed 42 和 43 两个随机种子(共享初始权重和深度采样序列)。训练深度按均值 8 的截断泊松分布采样,TBPTT 回传最后 步,阻尼组对最后 步取 ,仅对 13 个 core Linear 权重做假 NVFP4 量化。
评估分两种方式(均以相同 seed、相同深度 或 下的 BF16 继续训练结果为参考算 缺口):master 是撤掉量化器,把训练出来的 FP32 主权重直接放在原始无阻尼标准调度下用高精度评估;own 是保留该组自己的量化与调度评估。两 seed 平均结果如下表与图 5 所示:
| 训练组 | master 缺口 | master 缺口 | own 缺口 | own 缺口 |
|---|---|---|---|---|
| RTN | 0.0354 | 0.0357 | 0.0089 | 0.0088 |
| RTN + 最后 10% BF16 healing | 0.0255 | 0.0257 | 0.0177 | 0.0177 |
| SR | 0.0086 | 0.0086 | 0.0334 | 0.0307 |
| SR + damp | 0.0074 | 0.0086 | 0.0254 | 0.0191 |
| + damp | 0.0069 | 0.0090 | 0.0128 | 0.0112 |
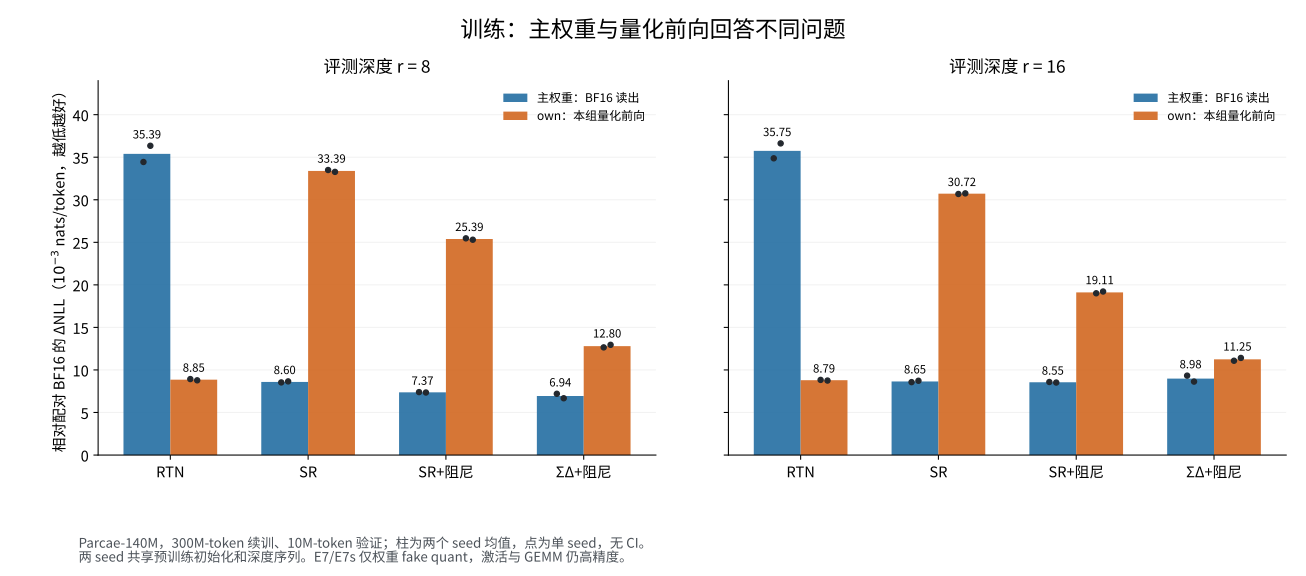
对比表里的两组指标,可以看到几个很清楚的趋势:
- 在
own评估上,静态 RTN 反而拿到了最低的缺口();但一旦把量化器摘掉看master,RTN 训出来的主权重缺口高达 ,就算最后 10% 步数换成 BF16 healing 也只能修到 。 - 相反,所有在步间动态换码的方案(SR、SR + damp、 + damp)训出来的
master缺口都很低()。 - 单看 + damp 与 SR + damp 的对比:在
master缺口上, 时两者均值差为 ( vs ), 时均值差为 ( vs )。也就是说,只要都加上尾段阻尼, 在训练主权重上相比简单的 SR 并没有表现出稳定、独特的优势(两个 seed 当然还不足以做严格的统计等价证明); + damp 在own上比 SR + damp 好( vs ),可能是因为主权重质量相近时, 自身的前向量化误差更小。
对于为什么会出现这种 master 和 own 分化的现象,可以借用解绑视角下的二阶展开做一些猜想性的分析(以下关于固定误差补偿、STE 偏置、优化器平均与曲率的解释均属于理论猜想,实验中没有直接测量梯度偏置或参数位移)。把 次访问的权重写成拼接向量 ,扰动 的均值记为 ,协方差为 ,则期望损失的二阶展开为:
这里 是完整的跨访问步 Hessian(注意共享权重的局部极小点只保证各步梯度之和为零,不保证解绑后的完整 Hessian 半正定;同时 SR 的单步条件零均值经过非线性复合后不代表训练梯度无偏,而 本身是确定性有偏序列)。
在这个框架下,静态 RTN 每次都注入完全固定的常值误差 ,主权重 在 STE 梯度驱动下很可能会往反方向发生静态偏移,专门去补偿和抵消这个固定的格点误差——所以带着 RTN 量化器跑 own 时刚好正负抵消表现很好,可一旦撤掉量化器测 master,这个为了迁就固定误差而长歪了的偏移量就暴露了出来。而 SR 和 在不同访问步之间不断变换码字,跨步平均偏差小,主权重无法靠简单的静态位移去迎合某一个固定码点,反而留在了靠近高精度解的位置(如果非循环模型加动态抖动也能看到类似效果,那说明这种保护主权重的作用并非循环结构所独有)。至于训练主权重时 为什么没能拉开和 SR 的差距,一个很自然的猜想是:TBPTT 只回传最后 4 步截断了长链梯度,而且优化器本身在几百步迭代和不同采样深度之间做着长程动量平均,这种跨 step 的时间平均已经把单次 forward 内部 相比 SR 的局部消误差优势抹平了。
3.3. W4A4 部署组合与 GSM8K 生成评测
再看权重和激活同时压到 4-bit 的 W4A4 部署场景。在 Huginn-0125()上测试 INT4 W4A4(权重 g32,激活 per-token),范围分 “仅 17 个 core Linear” 和 “17 个 core + 16 个 prelude/coda Linear” 两档(排除 embedding、norm 和 LM head),评测 WikiText word PPL 以及六个 0-shot 任务(LAMBADA acc、ARC-E acc_norm、ARC-C acc_norm、PIQA acc_norm、HellaSwag 前 2000 题 acc_norm、WinoGrande acc)的等权平均分。
如果直接用标准调度的 INT4 W4A4 RTN(core + prelude/coda),WikiText PPL 会直接崩到 ,六任务均分掉到 。真正能把 W4A4 精度拉回来的组合是旋转变换 + 沿轨迹校准的 GPTQ + 激活 DPCM + 尾段阻尼调度,然而这套表现最好的 INT4 组合里完全没有使用权重 (表与图 6 中略去了崩溃的裸 RTN 行):
| 配置 | 量化范围 | WikiText word PPL | 相对 BF16 | 六任务均分 |
|---|---|---|---|---|
| BF16 | — | 13.127 | 1 | 58.15% |
| 旋转 + GPTQ,标准循环 | 仅 core | 14.834 | 1.130 | 53.79% |
| 旋转 + 轨迹 GPTQ + DPCM + 阻尼调度 | 仅 core | 13.343 | 1.016 | 57.55% |
| 旋转 + GPTQ,标准循环 | core + prelude/coda | 15.382 | 1.172 | 53.06% |
| 旋转 + 轨迹 GPTQ + DPCM + 阻尼调度 | core + prelude/coda | 13.767 | 1.049 | 56.70% |
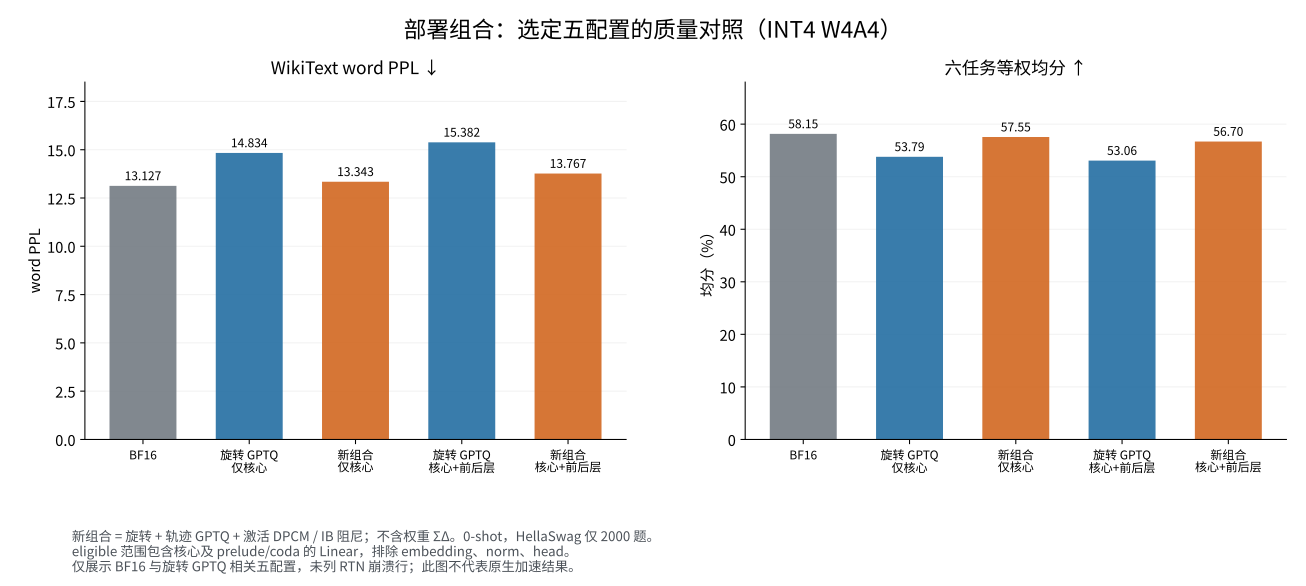
在仅量化 core 时,这套不含权重 的组合把 PPL 从常规旋转 GPTQ 的 压到了 (相对 BF16 仅高 ),六任务均分达到 ,离 BF16()只差 个百分点;扩到 core + prelude/coda 后 PPL 也只有 ,六任务均分 (如果不加旋转、只用轨迹 GPTQ + DPCM + 阻尼,仅 core 时六任务为 ,但扩到 prelude/coda 时会掉到 )。需要说明的是,这套组合是结合相关工作思路改造拼装的方案,没有做全部组件的逐项消融,也没有复现官方 Loopy/LoopQ 的全部模块(例如未实现 CTA)。
| 配置 | strict | flexible | flexible 相对 BF16(配对 95% CI) |
|---|---|---|---|
| BF16 | 35.33% | 42.84% | — |
| RTN,标准调度 | 29.57% | 32.15% | −10.69 [−13.2, −8.0] pp |
| 无副本:轨迹 GPTQ (4/6) + DPCM + 阻尼调度 | 31.92% | 39.12% | −3.71 [−5.84, −1.59] pp |
| 全编码:权重 + 激活 -DPCM(需参考权重) | 33.21% | 40.03% | −2.81 [−4.85, −0.83] pp |
无参考权重副本的静态组合(轨迹 GPTQ (4/6) + 激活 DPCM + 阻尼)把 flexible 准确率从 RTN 的 拉回到 (对 516 题);如果把权重和激活都换上 编码(需保留高精度参考权重),flexible 准确率进一步到 (对 528 题,多对 12 题)。不过因为全编码方案同时改了激活编码并保留了参考权重副本,这 12 道题的增益并不能单独归因给权重 。
4. 系统开销与实际部署的考量
只看前面的质量指标,权重 在特定设置下确实能降低前向误差;但把存储和当前算子微基准的耗时摆在一起看,就能理解为什么在目前的推理实现下做动态权重 很难直接拿到端到端的系统收益。
首先是存储与访存。静态 PTQ 量化完之后只需要存一份 4-bit 权重;而权重 在推理时每一步的码字都不同。如果在线实时生成码,显存里就必须额外留一份参考权重(比如 FP8 或约 的 INT6 经验表示,注意这些只是经验工程点而非信息论下界)和残差状态 buffer,每步都要额外读写这些状态;如果改为离线预生成 步的 4-bit 码流( 份 codebank)存下来,虽然每次访问只读取其中一份 bank(单步读取的数据量并不会直接乘以 ),但权重码字的存储容量最多会膨胀到原来的 倍,而且不同步读取不同 bank 也会削弱同一份权重常驻缓存的复用效果。
更直接的开销体现在当前 GPU 实现的动态码生成耗时上。我们在 RTX PRO 6000 Blackwell Server Edition(SM120)上对 Huginn core Linear 做了一组热 L2(hot-L2)形状加权微基准测试1818(单位为每次核心访问的微秒数 ,只测核心 Linear 流水线,不是端到端模型吞吐,不含 attention、norm、DPCM、反向传播和优化器;这里动态路径测的是从 FP8 参考权重出发、包含每步自适应 4/6 块尺度搜索的两点闭式 F4b 实现,与前面用 BF16 参考权重的递推 F4 质量路径在数值上不完全相同,不能把两边直接拼成一个质量/速度点):
| BF16 | FP8 | 预量化 NVFP4 RTN | NVFP4 + 每次访问生成码 | |
|---|---|---|---|---|
| 1 | 2238 | 1674 | 1198 | 9910 |
| 4096 | 34208 | 20333 | 10420 | 19122 |
可以看到,在这组核心 Linear 微基准中:当 时,静态预量化 NVFP4 每次访问耗时 ,比 BF16()快将近一倍;而每次访问在线生成 NVFP4 码需要 (其中光码生成就占了约 ),反而比 BF16 慢了 4 倍多。当 时,在线生成码的耗时()相对于 BF16()仍然快了约 倍,但相比静态预量化 NVFP4()慢了 倍,相对 FP8()则只快了约 倍。至于训练阶段,虽然训练本来就要保留 FP32 主权重,但维护残差 buffer 和额外读写同样有成本,加上前面 QAT 实验里 在主权重上并没有稳定跑赢同调度的 SR + 阻尼(而且像 这类数字只是核心线性层的 FLOP 占比代理,并不是实测的原生 FP4 端到端训练加速),目前也没有在端到端训练上拿到实际加速。
5. Conclusion
总体上来讲,把这些实测结果和猜想区分开来看:在 Huginn 和 Parcae-1.3B 的局部探针中能观测到负模态读数,在 Huginn 上也能测到后倾的尾段敏感度分布,这解释了为什么在相关设置里给 或 SR 配上尾段阻尼能够明显抑制高频失真。一阶权重 在 W4A16 PTQ 里确实能显著压低输出散度,但在 Parcae-140M 的 QAT 里,它的主权重表现并没有稳定超过同调度的 SR + 阻尼。至于前面提到的固定误差补偿、梯度跨步时间平均与曲率效应,目前都属于机制层面的猜想,后面还需要做更多的实验和理论分析。
脚注
-
Jonas Geiping 等. Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach. https://arxiv.org/abs/2502.05171 ↩
-
Hayden Prairie, Zachary Novack, Taylor Berg-Kirkpatrick, Daniel Y. Fu. Parcae: Scaling Laws For Stable Looped Language Models. https://arxiv.org/abs/2604.12946v1 ↩
-
Towards Looped Models Done Right, Part II: Rethinking at Fixed Points. https://arxiv.org/abs/2610.06833v1 ↩
-
按每次访问每个权重元素 2 FLOPs 计算,不含 attention score 等非权重计算。 ↩
-
Jack Cook 等. Four Over Six: More Accurate NVFP4 Quantization with Adaptive Block Scaling. https://arxiv.org/abs/2512.02010 ↩ ↩2
-
NVIDIA. Pretraining Large Language Models with NVFP4. https://arxiv.org/abs/2509.25149。精度分工见 §4.1;文中 1.2B 模型的 Linear 不带 bias。 ↩ ↩2
-
Loopy: Low-Bit Quantization Framework for Looped Language Models. https://arxiv.org/html/2610.05265v2 ↩
-
LoopQ: Quantization for Looped Language Models. https://arxiv.org/html/2605.16343v2 ↩
-
Hyperloop Transformers. https://arxiv.org/html/2604.21254v1(§4.2) ↩
-
Nux Li. Quantizing Looped Transformers: Feedback Exposure and Calibration Blindness. https://arxiv.org/html/2609.30820v1 ↩
-
ResidualQuant: KV Cache Quantization for Looped Transformers with 2-Bit Residuals. https://arxiv.org/html/2610.10381v1。激活残差量化见 §5.4 与附录 H。 ↩
-
Wojciech Czaja, Sanghoon Na. Frame Quantization of Neural Networks. https://arxiv.org/abs/2404.08131v1 ↩
-
SDQ-LLM: Sigma-Delta Quantization for 1-bit LLMs of any size. https://arxiv.org/html/2510.03275v1 ↩
-
Quartet II: Accurate LLM Pre-Training in NVFP4 by Improved Unbiased Gradient Estimation. https://arxiv.org/abs/2601.22813 ↩
-
Where KV-Cache Error Lives in Looped Language Models: A Diagnostic Study of Ouro and Huginn. https://arxiv.org/html/2610.41825v1 ↩
-
主表采用 ; 的比值按相同的 2000 次配对 bootstrap 另行计算。SR 使用 seed 42 的一条固定权重轨迹。 ↩
-
置信区间按题目配对进行 bootstrap 计算。 ↩
-
每个形状取 50 次计时的中位数,并选择最快的后端。 ↩