最近一段时间在看优化器相关的工作。一开始的目的是想跟一下 Modded NanoGPT,研究一下训练加速 oriented 的模型架构设计,发现还有个专门做加速器的 Track3。看的过程中感觉自己对优化器的理解太零散,Adam 大概知道在做什么,Muon 大概知道是把奇异值拉平,Shampoo 和 SOAP 就只记得是在梯度两边各乘一个矩阵,至于这些方法之间是什么关系、为什么有的在 Transformer 上好用有的不好用,基本说不太清楚。所以干脆把这段时间读的论文和做的实验整理成一个系列,算是给自己补课。
这一篇先把已有的优化器过一遍,从最基础的 SGD 一直讲到 Track 3 现在纪录里在用的 SOAP-Muon,整理一下逻辑的思路。
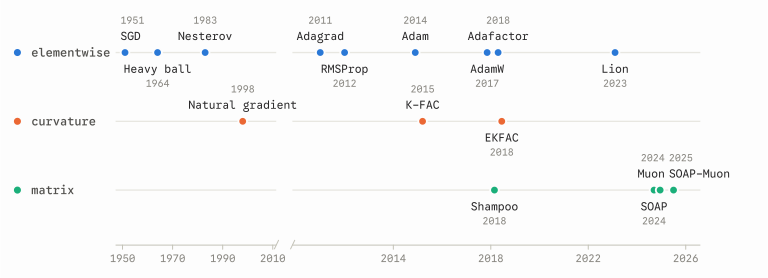
按时间排下来大概是这样(2010 年之前的部分压缩了),我把它们分成了三条线:逐元素(elementwise)的方法,从 SGD、动量一直到 Adam 和 AdamW;利用曲率(curvature)的方法,从 Newton 法到 Natural Gradient 和 K-FAC;以及把权重矩阵当成矩阵来处理的方法,Shampoo、Muon、SOAP 和 SOAP-Muon。最后这条线 2024 年之后变得非常快,Track 3 上现在排在前面的基本都是这一类。
0. Preliminary
0.1. 优化器在做什么
考虑一组参数 和一个训练要最小化的 loss ,每一步从训练集里取一个 batch ,算出这个 batch 上的梯度
然后更新参数
是学习率, 是这一步的更新方向。这篇里讲到的所有优化器,说到底都在回答同一个问题:手上有到目前为止的所有梯度 ,再加上自己存的一些状态(比如动量),这一步的 应该怎么取。最简单的取法是 ,也就是 SGD。
另一个会一直出现的对象是线性层。,权重 把 维的输入映射成 维的输出,Transformer 里绝大部分参数都在这种矩阵里(Attention 的 ,MLP 的两个矩阵)。一个 batch 里有 个 token,第 个 token 的输入记为 ,loss 对它输出的梯度记为 ,那么 的梯度是
也就是 个秩为 1 的外积加在一起。讲逐元素方法的时候用不太到这个式子,把所有参数拉平成一个长向量就行;但到了 K-FAC、Muon、Shampoo 这些方法,基本都是在 ”梯度是一堆外积之和” 这件事上做文章。
0.2. 两个麻烦:噪声和形状
如果每一步都能拿到整个训练集上的精确梯度,最朴素的梯度下降其实已经能用了,麻烦在于实际训练里有两件事会捣乱。
一个是噪声。batch 只是训练集里很小的一部分, 等于真实梯度 加上一个随机误差,这个误差期望是 0,方差大致和 batch size 成反比,batch 越小,每一步的方向就越不靠谱。
另一个是形状。loss 曲面在不同方向上的弯曲程度可以差很多,一个简单的例子是:
一个沿 方向很平、沿 方向很陡的山谷。梯度下降的学习率受最陡的方向限制,超过 就会在 方向发散,于是在平坦的 方向上每一步只能挪一点点。曲率最大值和最小值之比 叫条件数,梯度下降需要的步数大致和它成正比。
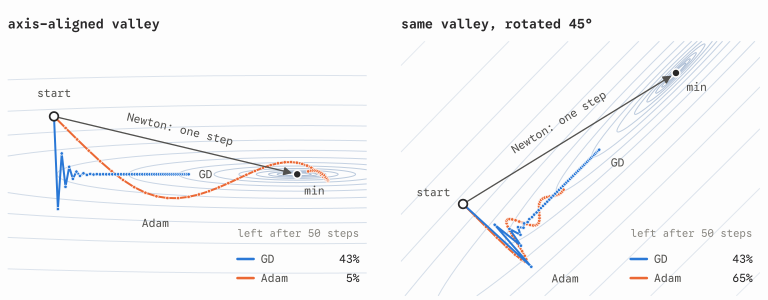
上图是让几种方法在这个山谷上各走 50 步。左边是沿坐标轴放的山谷:GD 先在陡的方向上来回震荡,之后沿着谷底一点点往前挪,50 步之后离终点还剩起点距离的四成多;Adam 给每个坐标单独定步长,刚好能抵消沿坐标轴的形状,很快就到了终点附近(因为带了动量,在终点附近还冲过头绕了一下);Newton 法一步到位。右边是把同一个山谷整体转 45°,起点也跟着转。GD 和 Newton 的轨迹和左边完全一样,只是整体转了一下,它们本来就不关心坐标轴朝哪;Adam 就不行了,逐坐标的缩放这时候和山谷的方向对不上,在起点附近来回折腾,50 步之后还剩六成多的距离,比 GD 还差。
换个坐标系,Adam 就从最好的变成了最差的。神经网络里的权重矩阵其实天然就有这个问题:对输入或者输出空间做一个旋转,网络表示的函数可以完全不变,逐坐标的优化器看到的东西却全变了。
0.3. NanoGPT speedrun Track 3
Track 3 是我最近主要在看的 benchmark,后面会经常引用上面的结果。modded-nanogpt 原本是 Keller Jordan 发起的 NanoGPT speedrun,比的是在 8 张 H100 上用最短的时间把模型训到目标 loss。年初加了一个 optimization track,也就是 Track 3:模型结构(GPT-2 small 规模,12 层,宽度 768)、数据(FineWeb)和 batch size(每步 512 条长度 1024 的序列,大约 52 万 token)都固定,每一步最多一次前向一次反向,优化器自己花多少计算都不管,比的是把 val loss 训到 3.28 需要多少步11。我比较喜欢这个设置的一点在于,所有方法都在同一个调好的 baseline 上比,很多优化器论文里 ”新方法对比一个没调好的 Adam” 的问题在这里基本不存在(当然它也有自己的问题)。到目前为止,调好的 Muon 加 AdamW baseline 要 3250 步,纪录是 2690 步。
1. SGD 与动量
1.1. SGD
是真实梯度的无偏估计,所以只要学习率按合适的方式衰减,SGD 在凸问题上能收敛到最优解。不过深度学习里基本没人按那些理论条件去衰减学习率。Track 3 的 baseline 是前 30% 恒定、后 70% 线性衰减到 0。schedule 对最终结果的影响很大,Track 3 上不少纪录都有一部分收益来自改 schedule,但它和优化器算是两件独立的事,这篇就不展开了。
1.2. 动量
一般取 0.9 或 0.95。展开之后 ,是过去所有梯度的指数加权和。改动很小,但同时干了三件事:
- 平均掉噪声。如果各步的噪声相互独立,把 归一化成加权平均之后,它的噪声方差大约是单步的 , 时差不多相当于把 39 步的梯度平均在一起;
- 在一致的方向上加速。梯度一直指向同一个方向的话,速度会累积到单步的 倍;
- 在来回震荡的方向上减速。上面山谷里 方向的梯度每步变号,在 里会互相抵消。
对二次函数,Polyak 证明了选好 和 之后,收敛需要的步数可以从和 成正比降到和 成正比。实现上还有一种 EMA(指数滑动平均)的写法 ,两者只差一个常数倍,可以吸收进学习率里,Adam 用的是 EMA 形式,PyTorch 的 SGD 和 Muon 用的是前一种,同样叫 lr,两种写法在 时能差出 20 倍,读代码的时候还是要注意一下这个问题。
1.3. Nesterov
和普通动量相比,它在更新里多给了当前梯度一点权重,反应更快一些,Muon 默认用的就是这种。
1.4. Gradient noise scale
batch size 为 时,梯度里噪声和信号的能量之比大约是 。 远小于 时,每一步的方向主要由噪声决定,batch 加倍差不多能让需要的步数减半; 远大于 时,梯度已经很准了,再加大 batch 几乎省不了步数, 附近就是所谓的临界 batch size。训练中 会慢慢变大,因为 loss 越低,真实梯度越小,而单个样本梯度的波动并不会同比例下降。
这个量对读 Track 3 的结果很重要。Track 3 的 batch 是固定的,所有优化器面对的噪声水平都一样;但自己做实验的时候不可能每个想法都跑一遍完整的 Track 3,经常要先在更小的模型、更小的 batch 上试,这时候噪声在梯度里占的比例会大很多,一些对付噪声的技巧在小 batch 上效果明显,换到大 batch 上就不一定了。
2. 逐坐标自适应:从 Adagrad 到 AdamW
2.1. Adagrad 与 RMSProp
这里的平方、开方和除法都是逐元素的。累积梯度一直很大的坐标步长变小,很少有梯度的坐标步长相对变大。
Adagrad 来自在线凸优化(online convex optimization),在那个框架下它的有一个很漂亮的 regret 界。论文里其实还给了一个 full-matrix 版本,用整个梯度外积的累积 而不只是它的对角线,更新为 。这个版本对大模型完全没法算,但 Shampoo 就是从这里出发的。
这就是 RMSProp。它一直没有正式发表,但用得非常广,引用的时候只能引一页课程 slides,也挺有意思的。
2.2. Adam 与 AdamW
和 分别是梯度一阶矩和(未中心化的)二阶矩的滑动估计。第三行是偏差修正:,训练刚开始时两个估计都偏小,除以 把它们校正回来。常用超参是 、,大模型训练里 一般取 0.95。每个参数要额外存 和 两个状态,fp32 下优化器状态是参数量的两倍。
Adam 为什么好用,我看到的解释大概有三种,它们之间并不完全一致:
- 符号下降。 时更新就是 ,只保留每个坐标的符号,所以 Adam 可以看成带平滑的符号下降(signSGD1010)。Balles 和 Hennig 把 Adam 的更新拆成符号乘上一个逐坐标的缩放因子 1111:梯度方向稳定的坐标,这个因子接近 1;符号来回变的坐标, 被平均掉而 不会,因子就变小,大概可以理解成每个坐标上的信噪比,也被称作 variance adaptation。Google 搜出来的 Lion1212 更直接,更新就是 ,只存一个动量,在不少任务上和 AdamW 差不多,算是给这个看法提供了一个旁证;
- 对角曲率。 估计的是 ,也就是经验 Fisher 矩阵的对角线,所以 Adam 也常被说成是一种对角的二阶方法。这个说法我感觉有点牵强,Adam 用的是平方根,Natural Gradient 用的是逆,而且经验 Fisher 本身拿来近似曲率就有不少问题1313;
- 噪声不是主要原因。Kunstner 等人 2023 年发现,在 Transformer 上即使用 full batch(没有采样噪声),SGD 和 Adam 之间的差距依然在,而带动量的符号下降能追上大部分差距1414,说明 Adam 的优势至少有一部分来自它对形状的处理。
范数取 ,解是 ,就是归一化的 SGD;取 (每个坐标的绝对值都不超过 1),解是 ,就是符号下降。换句话说,选什么范数,就是在选怎么衡量 ”一步走了多远”,更新的方向也就跟着定了。
大模型里用 Adam 还有两个实践上的细节。一个是 :0.999 意味着 大概记得最近一千步的梯度大小,梯度的尺度变化很快的时候(比如训练刚开始,或者 loss spike 之后), 跟不上, 会突然变得很大,一般认为这是大模型训练里把 调到 0.95 的主要原因。另一个是 :对梯度本来就很小的坐标,分母里的 可能比 还大,这时 Adam 在这些坐标上就退化成了 SGD,所以 的取值是会改变优化器行为的。Track 3 baseline 里 aux AdamW 的 是 ,比 PyTorch 默认的 小两个数量级,One-sided Shampoo 那个提交里 grafting 用的 Adam 更是设到了 ,基本就是不想让 起任何作用的意思。至于 和 在 Track 3 上到底能差多少,我还没有专门测过。
改动看起来很小,效果却明显更好,之后 AdamW 就成了大模型训练的默认选择,常见配置是 、weight decay 0.1,再加上 warmup 和 cosine 衰减。后面的 Muon 和 SOAP 基本都沿用了这种解耦的权重衰减。
2.3. Adafactor
状态从 降到 。论文里还有几个配套的改动:去掉一阶动量进一步省显存、对更新做裁剪(update clipping)、按参数自身的大小决定相对步长、让 随训练步数增加。T5 和 PaLM 都用过它(PaLM 用的是不做分解的版本)。
我觉得 Adafactor 在这条线上的位置有一些特别之处:它是第一个用上了” 参数是一个矩阵,有行有列” 这个结构的主流优化器,虽然出发点只是压缩二阶矩,和矩阵的几何没什么关系。有意思的是,几年之后 SOAP 的作者回过头发现,Shampoo 的一个变体其实就是在某个旋转过的坐标系里跑 Adafactor。
3. 曲率:Newton、Natural Gradient 与 K-FAC
3.1. Newton 法
回到 0.2 节的山谷,GD 慢是因为它对所有方向一视同仁,最自然的想法就是把曲率也考虑进来。在当前点附近把 loss 展开到二阶,记位移为 ,
是 Hessian 矩阵。这个二次函数的最小值点在 ,按 0.1 节 的写法,就是取 、,这就是 Newton 法。对山谷来说 ,Newton 法一步就到最优点,而且不管山谷怎么转都一样,因为它对参数的线性变换是不变的(affine invariant)。
问题在于规模。一个 参数的模型,Hessian 有 个元素,存都存不下,更别说求逆。神经网络的 loss 也不是凸的, 可能有负特征值,直接用 会往上坡走;从一个 batch 估出来的 噪声也很大。所以实际能用的二阶方法,基本都在做两件事:找一个半正定的曲率矩阵代替 ,再找一种结构化的近似让它算得起。
3.2. Gauss-Newton、Fisher 与 Natural Gradient
loss 是负对数似然的时候(比如语言模型的交叉熵),有一个天然的半正定替代品,Fisher 信息矩阵:
把 换成真实标签,得到的是经验 Fisher ,算起来方便很多,Adam 的 就是它的对角线。但经验 Fisher 和真正的 Fisher 在很多情况下差别很大,拿它做曲率近似要小心1313。
3.3. K-FAC
约等号来自假设输入 和输出梯度 相互独立。 是输入的二阶矩, 是输出梯度的二阶矩。Kronecker 积的逆等于逆的 Kronecker 积,于是 Natural Gradient 的更新可以写回矩阵形式:
原本要对一个 的矩阵求逆,现在只需要对一个 和一个 的矩阵求逆,对 的层,就是从一个约 维的问题变成两个 4096 维的问题。实现里 和 用滑动平均估计,每隔若干步重新求一次逆,再加上 damping 保证数值稳定。
K-FAC 在研究里影响很大,但据我所知在 LLM 预训练里用得不多,求逆的开销、对 damping 的敏感,以及实现的复杂度大概都是原因。
4. 把矩阵当作矩阵:Muon
4.1. 动机
前面的逐元素方法有一个共同点:它们把一个 的权重矩阵当成 个互不相关的数,可网络用 的方式,是把它当成一个线性映射作用在输入上。0.2 节的右图其实已经把这个问题摆出来了,坐标系一转,逐坐标缩放的效果就全变了。
另一个观察来自梯度本身的形状。 是一堆外积之和,实际训练里这种矩阵的奇异值往往衰减得很快,少数几个方向占了绝大部分能量。直接拿 (或者它的动量)去更新,步长几乎全花在那几个主导方向上,其他方向基本学不动。
4.2. 算法
第一行是 Nesterov 动量, 是 的瘦 SVD。 在线性代数里叫极分解(polar decomposition)的正交因子,后面记作 ,它保留了原矩阵的奇异向量,也就是 ”往哪些方向走”,但把每个方向上的步长都拉平成 1。 是一个和矩阵形状有关的缩放系数,Jordan 的实现里取 , 是输出维度, 是输入维度。
Muon 只管网络中间的二维权重矩阵,embedding、最后的 LM head、RMSNorm 的 gain 和各种 bias 还是交给 AdamW,Track 3 里管这部分叫 aux AdamW。embedding 的输入是 one-hot 向量,每一步只有被用到的那几行有梯度,“整个矩阵对任意输入的作用” 这种看法对它不太适用;LM head 在 Jordan 的实验里用 Muon 也不如用 AdamW;一维的 gain 和 bias 则根本没有奇异值可言。所以实际跑起来的 ”Muon” 一直是 Muon 和 AdamW 的混合体,aux AdamW 这部分的超参调起来也挺费劲的,Track 3 #36 那个调好的 baseline,改的超参里一大半都是 aux AdamW 的。
4.3. Newton-Schulz 迭代
每个矩阵每一步都做一次 SVD,在 GPU 上太慢,也不适合 bf16。Muon 用 Newton-Schulz 迭代来近似 :先把矩阵除以它的 Frobenius 范数,保证所有奇异值都不超过 1,然后反复做
这个迭代只用矩阵乘法,而且不改变奇异向量,每个奇异值 各自经历同一个标量映射 。所以选系数的问题就变成了:选一个奇多项式,让它迭代几次之后,把 里的数都推到 1 附近。
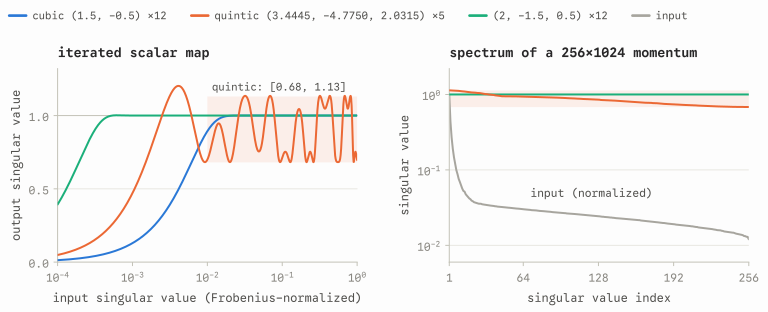
左图是三组系数下的标量映射。经典的三次迭代 在 1 附近收敛很快,但对很小的奇异值每次只能放大 1.5 倍,迭代 12 步之后, 以下的奇异值还明显没到 1。Jordan 调出来的五次多项式 在 0 附近斜率很大,5 步就能把 量级的奇异值推到 0.5 左右, 以上的基本都到了 1 附近;代价是它并不收敛到 1,在 的输入上,5 步之后的输出在 0.68 到 1.13 之间来回摆。Jordan 的判断是这点误差对训练基本没有影响,换来的是更少的迭代次数,speedrun 比的是墙钟时间,这个取舍很合理。Track 3 比的是步数,算得慢一点无所谓,所以 baseline 换成了另一组系数 ,迭代 12 步,它在 0 附近斜率为 2,在 1 处精确收敛, 以上的奇异值最后都是 1。
右图是一个合成的动量矩阵(,奇异值按幂律衰减再加上噪声)经过两种迭代之后的奇异值,原始的奇异值跨了将近两个数量级,迭代之后基本都被拉到了 1 附近。按 Jordan 的估算,Newton-Schulz 带来的额外计算在典型的语言模型训练里不到 1%2121。
系数和缩放这些东西看起来只是实现细节,我在小模型上就被它坑过一次。一开始用的是一个常见的 Muon 库实现(Jordan 的五次系数、不加 weight decay、库自带的步长缩放),在这个设置下看到某个改动比 SOAP 还好 0.01 左右;后来把这些全部换成 Track 3 的约定重跑,收益只剩下五分之一,置信区间也跨过了 0。也就是说之前看到的 ”收益”,有一大半是在弥补库实现本身的问题。从那之后我的小模型实验都尽量和 Track 3 的约定对齐。
4.4. 为什么有效
Muon 为什么有效,我目前看到的主要有三种说法,彼此相容,只是角度不同。
第一种是谱范数下的最速下降1515。把 2.2 节的范数换成矩阵的谱范数(spectral norm,也就是最大奇异值 ),
输入 的每个分量大小在 1 左右,也就是 RMS 为 1、,那么一个所有奇异值都是 的更新 最多能让输出变化 ,换算成输出的 RMS 是 。想让输出的 RMS 变化和输入在同一个量级,就要取 。Jordan 的 只在输出维度大于输入维度时放大,算是这个式子的一个变体。
第二种是把 Muon 看成没有记忆的 Shampoo,下一节讲 Shampoo 的时候再说。
第三种是 Jordan 原始博客里的直觉:SGD 和 Adam 产生的更新矩阵往往接近低秩,被少数方向主导,正交化之后,那些原本很小、但可能很重要的方向拿到了和主导方向一样的步长。这个说法很直观,但 ”可能很重要” 基本算纯猜。奇异值很小的那些方向,到底是被压制住的有用信号,还是就是噪声?正交化对两者是一视同仁地放大的。后面的不少工作,都是在追问这个问题。
4.5. 规模化与变体
Muon 在 speedrun 上火了之后,Moonshot 的 Moonlight 把它推到了大模型上2424。他们发现规模大了之后要改两点:加上和 AdamW 一样的解耦权重衰减;把形状缩放改成 ,让 Muon 每个元素的更新大小和 AdamW 差不多,这样可以直接沿用 AdamW 的学习率和 weight decay(这个改法很工程但很实用,从 AdamW 迁移过来不用重新调一遍超参)。在他们的 scaling law 实验里,Muon 达到同样 loss 需要的计算量大约是 AdamW 的一半。之后的 Kimi K2 用 Muon 训了一个万亿参数的 MoE 模型,又加了一个 QK-Clip 机制防止 attention logit 爆炸,合起来叫 MuonClip2525。
5. 带记忆的两侧统计量:Shampoo
5.1. 算法
这两个矩阵的含义挺直观的。 的第 个元素是 第 行和第 行的内积,也就是第 个和第 个输出神经元收到的梯度有多相似,累积起来, 记录的就是梯度在输出空间里各个方向上的能量和相关性; 对输入空间做同样的事。左右各乘一个负幂次,可以理解成在输出和输入两个空间里分别做白化(whitening):历史上梯度能量一直很大的方向被压下去,一直很小的方向被放大。至于为什么是 :full-matrix Adagrad 要的是那个大矩阵的 次幂,论文证明了它可以被 (乘上一个和梯度秩有关的常数)从上方控制住,代进去再取 次幂,每一侧就分到了 。
5.2. 和 Muon 的关系
如果去掉累积,只用当前这一步的梯度,那么 ,。把 代进去:
这里要稍微小心一点: 不是方阵的时候, 和 至少有一个是奇异的,上面的 次幂要在伪逆、或者加上 再让 的意义下理解。所以没有记忆的 Shampoo 就是 Muon 的正交化,Muon 只是额外在动量上做这件事。Track 3 的 #22 干脆把 SpectralDescent、不带动量的 Muon 和 betas 取 (0, 0) 的 Shampoo 写成了同一行,8225 步。
5.3. 工程上的麻烦
Shampoo 一直没有像 Adam 那样普及,主要是工程上的原因:
- 求 次幂需要特征分解,要在 fp32 甚至 fp64 下做,数值上很敏感,代价是 ,所以一般每隔几十到上百步才更新一次预条件矩阵;
- 需要 一类的 damping,结果对它比较敏感;
- 实际实现里常用 grafting,用 Adam 或 Adagrad 的更新大小配上 Shampoo 的更新方向,来稳定每一层的步长;
- 很大的矩阵需要分块,分布式训练需要专门的实现。
grafting 这一条我第一次看到的时候觉得有点奇怪,等于是承认 Shampoo 自己定不好每一层的步长,方向用 Shampoo 的,大小还得借 Adam 的。Track 3 上那个 Shampoo 的提交,打开配置一看也是开着 Adam grafting 的。我自己在小模型上跑 SOAP 一类的方法,fp32 的 torch.linalg.eigh 有时(可能 5%?)会报不收敛直接退出,最后只好在失败的时候退回 fp64 重算。
把这几类方法的开销放在一起(对一个 的矩阵):
| 方法 | 额外状态 | 每步额外计算 |
|---|---|---|
| SGD + 动量 | 无 | |
| AdamW | 逐元素 | |
| Adafactor(不用动量) | 逐元素 | |
| Muon | 5 到 12 次 Newton-Schulz,每次几个矩阵乘法 | |
| Shampoo | ,含缓存的逆根 | 每隔若干步一次 的特征分解 |
| SOAP | 每步几次旋转(矩阵乘法),每隔若干步一次特征分解 |
6. SOAP:在 Shampoo 的特征基里跑 Adam
6.1. 出发点
推导很短。设 ,,旋转后的梯度为 ,那么
也就是在旋转后的坐标系里,第 个元素被除以 。而 的第 个特征值 正好等于(累积意义下的), 等于 ,分别是旋转后梯度平方的行和与列和,也就是 Adafactor 用来重建二阶矩的 和 。两者只差一个标量:Adafactor 的 分母里还有一个 ,所以 Adafactor 的更新是这个 Shampoo 的 倍。这个因子对同一个矩阵里的所有元素都一样,但会随层和训练步数变化,相当于每一层每一步换了一个学习率,方向上两者是一致的。
那既然 Shampoo 相当于在特征基里跑 Adafactor,为什么不在这个坐标系里跑效果更好的 Adam?这就是 SOAP。
6.2. 算法
记 和 的特征向量矩阵为 和 ,SOAP 每一步做:
- 用滑动平均更新 ,;
- 每隔 步重新算一次 和 ,原论文用特征分解,也可以用一步幂迭代加 QR 分解来近似;
- 把梯度和动量旋转到特征基里:,;
- 在旋转后的坐标系里跑 Adam:,;
- 旋转回去并更新:。
一阶动量 在原坐标里累积,用的时候再转进特征基;二阶矩 直接在特征基里累积。这样分开放是有原因的: 对梯度是线性的,放在原坐标里,每次用当前的特征基去转,就等于把历史上所有梯度都放进当前这组基里重新表示,特征基怎么换都对得上(如果存在旧的特征基里,eigh 返回的特征向量本来就只确定到一个正负号,重新分解时某个方向翻了号,历史动量就会和新梯度互相抵消); 是逐元素的平方,没法只靠 本身换到新的基下,只能留在特征基里接着用,好在平方对特征向量变号不敏感, 每次的变化也不大。原论文还拿这一点和 GaLore3737 做了对比,GaLore 为了省显存,把梯度投影到一个低秩子空间里跑 Adam,动量也存在投影后的空间里,子空间一换,旧的动量就对不上了。
直观上,旋转到特征基之后,梯度的各个坐标之间近似不相关,Adam 那种逐坐标处理的假设就更接近成立了,相当于先把 0.2 节右边那个转过的山谷转回来,再交给 Adam。另一个好处是稳定性:Shampoo 的预条件矩阵在两次更新之间是冻结的,而 SOAP 在两次更新特征基之间,Adam 的二阶矩还在一直适应,所以特征分解可以做得更稀疏,代价更低。当然在 Track 3 这种只看步数的设置下,这个好处就无所谓了,现在的纪录都是每一步更新特征基。
原论文在 3.6 亿和 6.6 亿参数的语言模型上报告,SOAP 比 AdamW 少用 40% 以上的迭代步数、35% 以上的 WallTime,比 Shampoo 在两项上各好 20% 左右3535。
6.3. 后续的分析
7. SOAP-Muon:先预处理,再正交化
7.1. 想法
SOAP 和 Muon 都好用,那把它们串起来呢?先用 SOAP 对动量做预处理,再把结果送进 Muon 的正交化:
7.2. 在 Track 3 上的演化
SOAP-Muon 是 Track 3 上推动纪录最多的一类方法,大致经历了这几步11:
- #14(2026 年 5 月):在 MLP 的两个矩阵上,Muon 正交化之前先做 SOAP 预处理,3150 步;
- #16:attention 的矩阵也加上 SOAP,并用一个 trust gate 控制,3125 步(README 里自己也标了,它相对 #14 的 p 值是 0.34);
- #44(6 月):所有隐藏层矩阵都用 SOAP-Muon,并且每一步都更新特征基(precondition_frequency = 1),同时调了 aux AdamW 的 和初始化,2750 步。这一步比之前的纪录一下少了 100 步,而且是一边加东西一边删东西,前面好几个纪录里叠上去的 Contra-Muon、Circuit-Muon、Aurora 这些模块,在 #44 里被当作中性的模块删掉了;
- #45:在最后一步把权重往 150 步的 weight EMA 方向混一下,2720 步;
- #46:加上逐行的更新下限(RowFloor)和 Cautious Weight Decay(只在这一步本来就在让权重变小的坐标上做衰减),2690 步,是现在的纪录。
#44 和 #46 里 SOAP-Muon 的实现有几点值得注意:特征基每步只用一次幂迭代加 QR 来更新;Gram 矩阵用的是原始梯度,滑动平均系数 0.9;被预处理的是动量,并且用的是上一步建好的特征基;预处理的输出还会按某种矩阵范数重新缩放,再送进 Newton-Schulz。
#44 算是比较扎实的 SOTA,但 #44 之后这两步我是有点怀疑的。#45 和 #46 各自比上一个纪录少 30 步,按 Track 3 自己给的换算大约是 0.0014 的 loss,而按提交的 log 算,seed 之间的标准差在 0.001 左右。拿 README 里两两对比的显著性公式算一下(两个提交的平均 loss 之差,加上步数之差按每 100 步 0.0045 折算出的 loss,再除以 ,同样以 0.004 为线),#45 相对 #44 是 0.0043,刚刚过线;#46 相对 #45 是 0.0035,其实没过(它作为纪录是有效的,因为它自己在 2690 步上显著低于 3.28,只是这些 log 还不足以说明它比 #45 更好)。README 对 #46 的说明也很坦白,好几个细节还没有被单独证明有用,其中最好笑的一个是 Muon 动量的 cooldown 被安排在 2700 到 2900 步,而纪录在 2690 步就验收了,也就是说这段 cooldown 根本没跑到。
自己做实验的时候也有比较多这种奇怪的 setting 导致的问题,反正体感上 #44 之后的几十步,基本都是靠这样一个个开关叠出来的 buff,单看每一个都很难说清楚有没有用。
7.3. 一些有代表性的 Track 3 结果
| 编号 | 方法 | 步数 |
|---|---|---|
| #22 | 不带动量的 Muon(spectral descent) | 8225 |
| #2 | Adam(单个 seed,提交者注明大概率没调好) | 5625 |
| #4 | AdamH(Adam + hyperball 约束) | 4875 |
| #21 | Shampoo( 次幂,每 5 步更新) | 4100 |
| #33 | PSGD(Kronecker 预条件) | 3375 |
| #35 | One-sided Shampoo | 3375 |
| #12 | Muon + AdamW | 3325 |
| #15 | Newton-Muon(输入侧激活协方差预条件 + Muon) | 3275 |
| #36 | 调好超参的 Muon + AdamW(当前基线) | 3250 |
| #10 | NorMuon | 3250 |
| #14 | SOAP-Muon(只用在 MLP 上) | 3150 |
| #19 | KL-SOAP + hyperball | 3125 |
| #27 | SOAP + hyperball | 3125 |
| #44 | SOAP-Muon(所有隐藏层,每步更新特征基) | 2750 |
| #46 | #44 + Tail-EMA + RowFloor + CWD(当前纪录) | 2690 |
需要注意的是,不同提交的调参力度差别很大,很多结果还叠加了学习率 schedule、初始化、hyperball 这类和更新方向无关的改动,所以它算不上一个纯算法的排名。另外在 3300 步附近,少 100 步大约相当于 val loss 低 0.004511,表里几十步的差距对应的 loss 差其实很小。即便如此,大的趋势还是很清楚,加粗的三行就是三个 stage:逐元素的 Adam 明显落后;Muon 这类把矩阵当矩阵的方法是一个大台阶;在 Muon 之上再加 SOAP 的统计量,是第二个 stage。
8. 留给下一篇的问题
把这些方法按时间顺序读下来,一个感受是它们之间的关系比我原来想的紧得多。full-matrix Adagrad 做 Kronecker 近似得到 Shampoo,Shampoo 去掉记忆就是 Muon 的正交化;Adam 的二阶矩按行列分解得到 Adafactor,把 Adafactor 搬到 Shampoo 的特征基里再换回 Adam 就是 SOAP;最后 SOAP 和 Muon 又在 SOAP-Muon 里接到了一起。逐元素和矩阵这两条线,一直在互相借用对方的东西。
读的过程中形成了一些问题:
- Adam 的 到底在估计什么,是噪声的大小,还是某种曲率?full batch 下 Adam 依然更好,似乎说明不只是噪声。
- Muon 把所有奇异值拉平成 1,奇异值很小的那些方向,是值得放大的信号,还是噪声?
- K-FAC 用的是单个样本层面的输入和输出二阶矩,Shampoo 和 SOAP 用的是整个 batch 梯度的 Gram 矩阵,这两种统计量包含的信息一样吗?
- MLP 的权重是 这样很扁的矩阵,左右两侧统计量的维度差了四倍,哪一侧更重要?
- Muon 最后一步的 会把所有奇异值强行拉回 1,那 SOAP-Muon 里 SOAP 费了半天劲算出来的逐元素缩放,岂不是全被抹掉了?可实际上先做 SOAP 再正交化,比单独用 Muon 少了好几百步(虽然中间也混了别的改动)。polar 抹掉的只是奇异值,奇异向量还在,而 SOAP 的逐元素缩放恰恰会改变奇异向量,也就是说 。那 SOAP 到底把奇异向量往哪边掰了,为什么掰过之后会更好?
第二篇会尝试把这一篇里的方法放进一个统一的描述里,回答其中一部分,剩下的变成可以用实验检验的假说。另外,这一篇引用了不少 Track 3 社区的结果,有的有严格的多 seed 统计,有的只是单次运行,可信程度参差不齐,怎么在小模型上做可靠的对比,也许之后还可以再写一篇单独的文章。
脚注
-
Keller Jordan 等,Modded-NanoGPT Optimization Benchmark(Track 3),https://github.com/KellerJordan/modded-nanogpt/tree/master/records/track_3_optimization。文中的步数、规则和对各个纪录的描述均来自该页面 2026 年 9 月的版本。 ↩ ↩2 ↩3
-
Herbert Robbins, Sutton Monro. A Stochastic Approximation Method. Annals of Mathematical Statistics, 1951. ↩
-
Boris Polyak. Some methods of speeding up the convergence of iteration methods. USSR Computational Mathematics and Mathematical Physics, 1964. ↩
-
Yurii Nesterov. A method for solving the convex programming problem with convergence rate O(1/k²). Soviet Mathematics Doklady, 1983. ↩
-
Ilya Sutskever, James Martens, George Dahl, Geoffrey Hinton. On the importance of initialization and momentum in deep learning. ICML 2013. ↩
-
Sam McCandlish, Jared Kaplan, Dario Amodei, OpenAI Dota Team. An Empirical Model of Large-Batch Training. https://arxiv.org/abs/1812.06162 ↩
-
John Duchi, Elad Hazan, Yoram Singer. Adaptive Subgradient Methods for Online Learning and Stochastic Optimization. JMLR 2011. ↩
-
Geoffrey Hinton, Nitish Srivastava, Kevin Swersky. Neural Networks for Machine Learning, Lecture 6e, Coursera, 2012. ↩
-
Diederik Kingma, Jimmy Ba. Adam: A Method for Stochastic Optimization. https://arxiv.org/abs/1412.6980 ↩
-
Jeremy Bernstein, Yu-Xiang Wang, Kamyar Azizzadenesheli, Anima Anandkumar. signSGD: Compressed Optimisation for Non-Convex Problems. https://arxiv.org/abs/1802.04434 ↩
-
Lukas Balles, Philipp Hennig. Dissecting Adam: The Sign, Magnitude and Variance of Stochastic Gradients. https://arxiv.org/abs/1705.07774 ↩
-
Xiangning Chen 等. Symbolic Discovery of Optimization Algorithms. https://arxiv.org/abs/2302.06675 ↩
-
Frederik Kunstner, Lukas Balles, Philipp Hennig. Limitations of the Empirical Fisher Approximation for Natural Gradient Descent. https://arxiv.org/abs/1905.12558 ↩ ↩2
-
Frederik Kunstner, Jacques Chen, Jonathan Lavington, Mark Schmidt. Noise Is Not the Main Factor Behind the Gap Between SGD and Adam on Transformers, but Sign Descent Might Be. https://arxiv.org/abs/2304.13960 ↩
-
Jeremy Bernstein, Laker Newhouse. Old Optimizer, New Norm: An Anthology. https://arxiv.org/abs/2409.20325 ↩ ↩2
-
Ilya Loshchilov, Frank Hutter. Decoupled Weight Decay Regularization. https://arxiv.org/abs/1711.05101 ↩
-
Noam Shazeer, Mitchell Stern. Adafactor: Adaptive Learning Rates with Sublinear Memory Cost. https://arxiv.org/abs/1804.04235 ↩
-
Shun-ichi Amari. Natural Gradient Works Efficiently in Learning. Neural Computation, 1998. ↩
-
James Martens, Roger Grosse. Optimizing Neural Networks with Kronecker-factored Approximate Curvature. https://arxiv.org/abs/1503.05671 ↩
-
Frederik Benzing. Gradient Descent on Neurons and its Link to Approximate Second-Order Optimization. https://arxiv.org/abs/2201.12250 ↩
-
Keller Jordan 等. Muon: An optimizer for hidden layers in neural networks. https://kellerjordan.github.io/posts/muon/ ↩ ↩2
-
Tim Large, Yang Liu, Minyoung Huh, Hyojin Bahng, Phillip Isola, Jeremy Bernstein. Scalable Optimization in the Modular Norm. https://arxiv.org/abs/2405.14813 ↩
-
Greg Yang, James Simon, Jeremy Bernstein. A Spectral Condition for Feature Learning. https://arxiv.org/abs/2310.17813 ↩
-
Jingyuan Liu 等. Muon is Scalable for LLM Training. https://arxiv.org/abs/2502.16982 ↩
-
Kimi Team. Kimi K2: Open Agentic Intelligence. https://arxiv.org/abs/2507.20534 ↩
-
Kwangjun Ahn 等. Dion: Distributed Orthonormalized Updates. https://arxiv.org/abs/2504.05295 ↩
-
Zichong Li, Liming Liu, Chen Liang, Weizhu Chen, Tuo Zhao. NorMuon: Making Muon more efficient and scalable. https://arxiv.org/abs/2510.05491 ↩
-
Kevin Frans, Pieter Abbeel, Sergey Levine. What Really Matters in Matrix-Whitening Optimizers? https://arxiv.org/abs/2510.25000 ↩ ↩2
-
Vineet Gupta, Tomer Koren, Yoram Singer. Shampoo: Preconditioned Stochastic Tensor Optimization. https://arxiv.org/abs/1802.09568 ↩
-
Depen Morwani 等. A New Perspective on Shampoo’s Preconditioner. https://arxiv.org/abs/2406.17748 ↩
-
Runa Eschenhagen, Anna Cai, Tsung-Hsien Lee, Hao-Jun Michael Shi. Clarifying Shampoo: Adapting Spectral Descent to Stochasticity and the Parameter Trajectory. https://arxiv.org/abs/2602.09314 ↩
-
Rohan Anil 等. Scalable Second Order Optimization for Deep Learning. https://arxiv.org/abs/2002.09018 ↩
-
Hao-Jun Michael Shi 等. A Distributed Data-Parallel PyTorch Implementation of the Distributed Shampoo Optimizer for Training Neural Networks At-Scale. https://arxiv.org/abs/2309.06497 ↩
-
Priya Kasimbeg 等. Accelerating Neural Network Training: An Analysis of the AlgoPerf Competition. https://arxiv.org/abs/2502.15015 ↩
-
Nikhil Vyas 等. SOAP: Improving and Stabilizing Shampoo using Adam. https://arxiv.org/abs/2409.11321 ↩ ↩2
-
Thomas George, César Laurent, Xavier Bouthillier, Nicolas Ballas, Pascal Vincent. Fast Approximate Natural Gradient Descent in a Kronecker-factored Eigenbasis. https://arxiv.org/abs/1806.03884 ↩
-
Jiawei Zhao 等. GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection. https://arxiv.org/abs/2403.03507 ↩
-
Wu Lin 等. Understanding and Improving Shampoo and SOAP via Kullback-Leibler Minimization. https://arxiv.org/abs/2509.03378 ↩
-
Nikhil Vyas 等. Improving SOAP Using Iterative Whitening and Muon. https://nikhilvyas.github.io/SOAP_Muon.pdf ↩