原文:arXiv:1807.04188 · Moreau et al., IEEE Micro 2019
摘要:专门的深度学习(DL)加速堆栈是为特定的框架、模型架构、运算符和数据类型设计的,它们提供了高性能的吸引力,但牺牲了灵活性。算法、模型、运算符或数值系统的变化威胁着专用硬件加速器的可行性。 我们提出 VTA,这是一个可扩展面对不断演进工作负载的可编程深度学习体系结构模板。通过参数化体系结构、两级 ISA 和 JIT 编译器,VTA 实现了这种灵活性。两级 ISA 基于 (1) 任务 ISA,明确协调并发计算和内存任务;(2) 微码 ISA,在单周期张量操作中实现多种运算符。接下来,我们提出了一个配备 JIT 编译器的运行时系统,用于灵活代码生成和异构执行,以有效利用 VTA 体系结构。 VTA 已经集成并开源到 Apache TVM 中,后者是一款先进的深度学习编译堆栈,在不同模型和不同硬件后端上提供了灵活性。我们提出了一个流程来进行设计空间探索,并生成定制化硬件架构和软件运算符库,可以被主流学习框架所利用。我们通过在边缘级 FPGA 上部署优化的用于对象分类和风格转换的深度学习模型来演示我们的方法。
1.Intro
VTA 是为了将快速更新的加速器和快速变化的机器学习两个领域相联系的工作。 Contribution:
- 一种可编程加速器设计,提供两级编程接口:高级任务 ISA 允许编译器栈进行显式任务调度,低级微码 ISA 提供软件定义操作灵活性。VTA 架构完全可参数化:硬件内部函数、存储器和数据类型可以定制以适应硬件后端要求。
- 可扩展的异构执行运行时系统,通过对微码内核进行即时编译来提供操作灵活性。例如,VTA 运行时使我们能够将原始面向计算机视觉设计的 VTA 功能扩展到支持风格转换应用中找到的运算符,并且无需对硬件进行任何修改。
- 调度自动调优平台,可以优化数据访问和数据重用以快速适应底层硬件变化和工作负载多样性。
2.VTA Hardware-Software Stack Overview
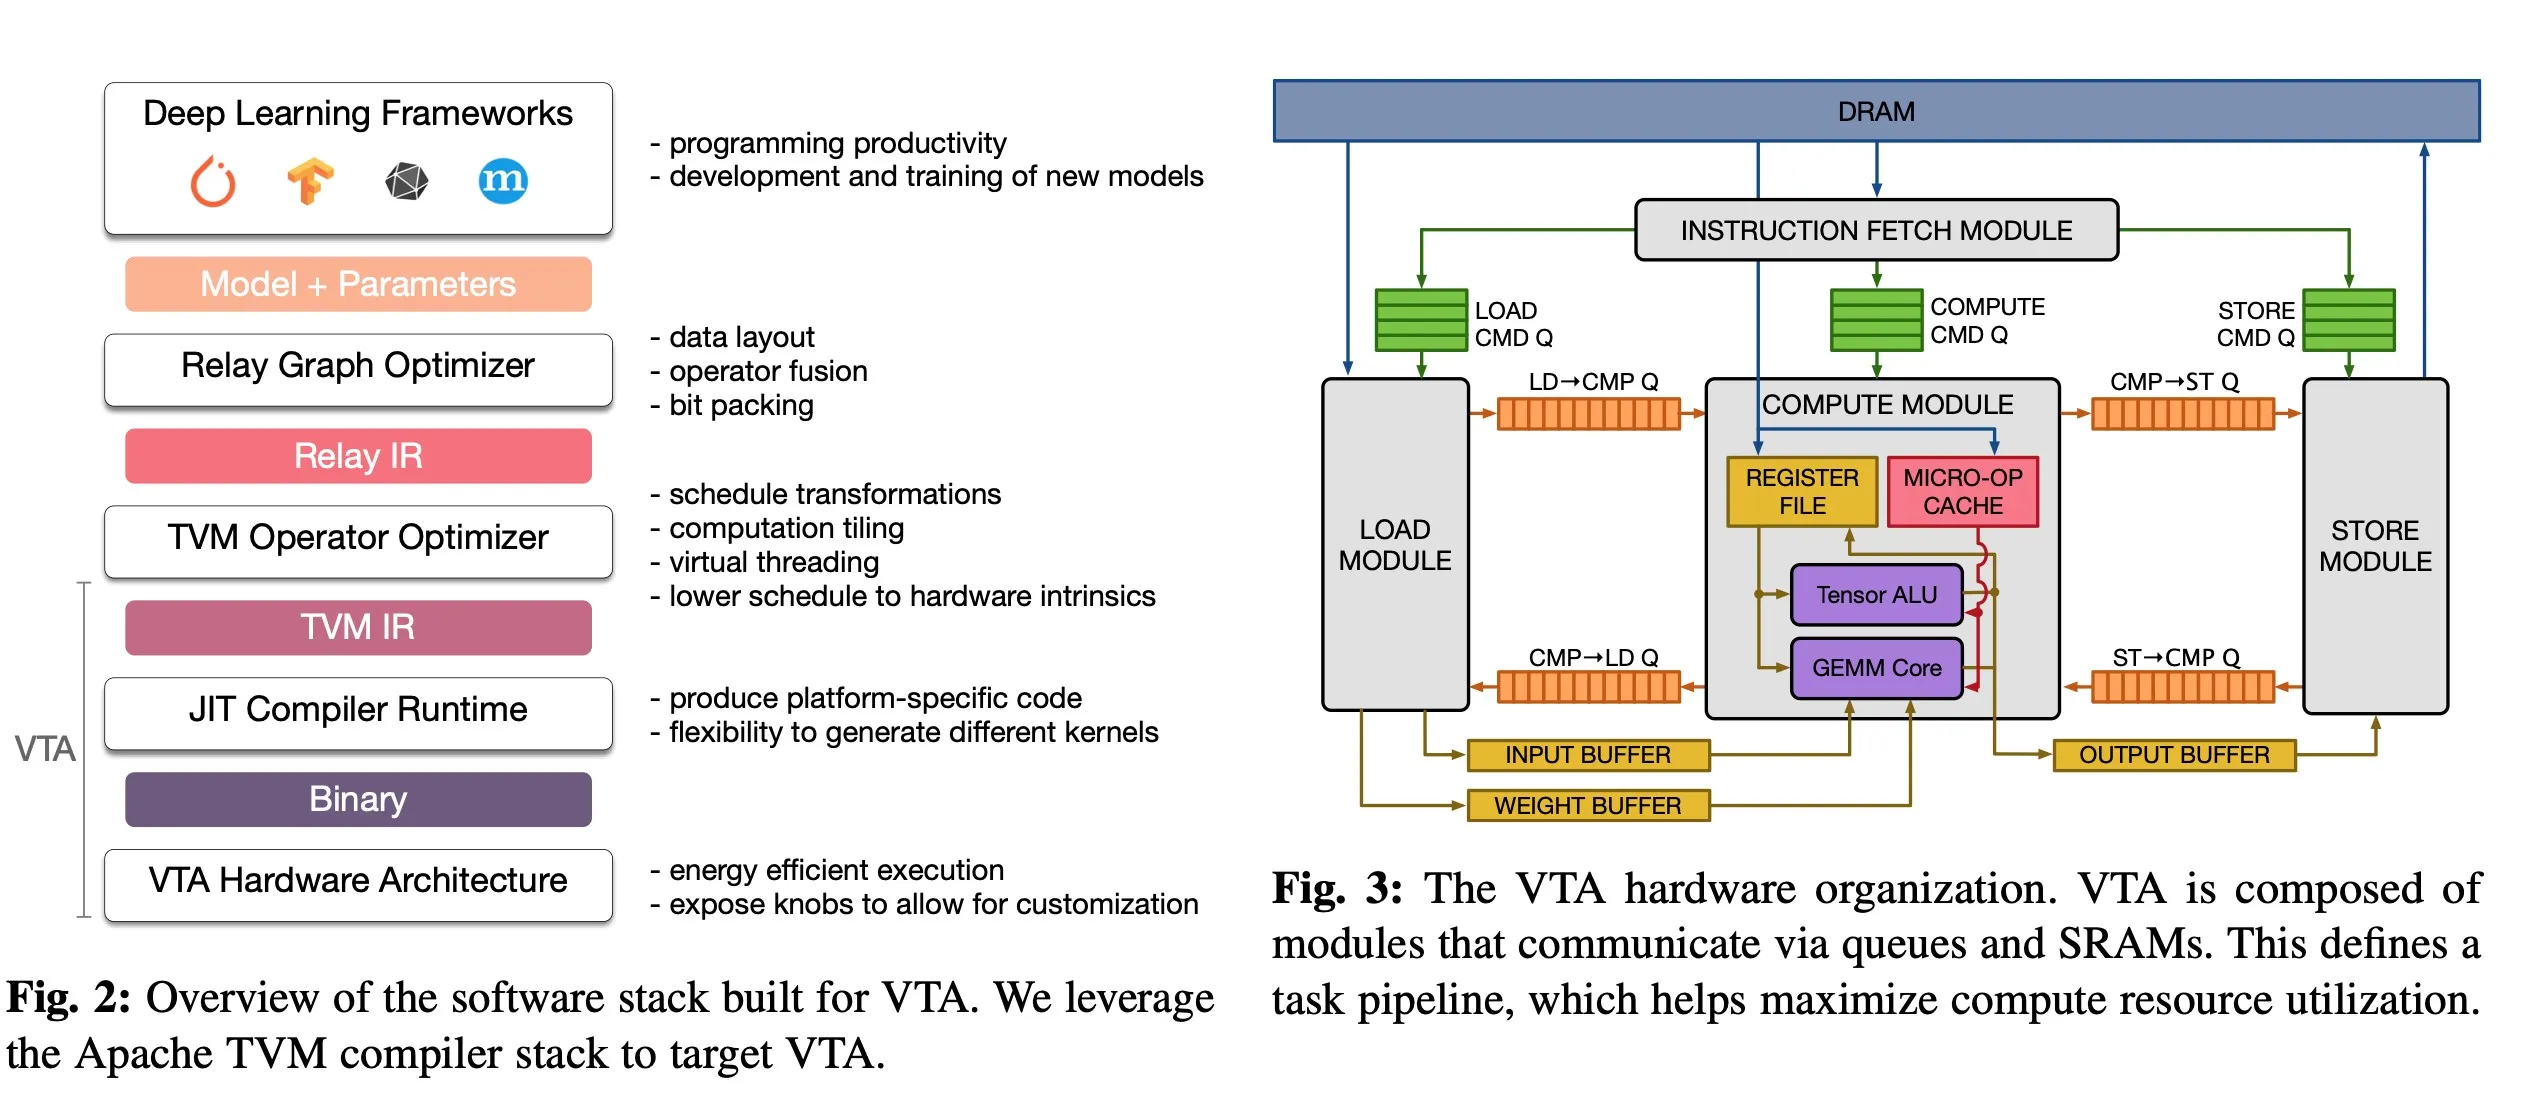
VTA 类似接在 TVM 的一个后端,上层部分和 TVM 是一样的,额外增加了 JIT Compiler&Runtime 和硬件部分的设计
3.VTA Architecture and JIT Runtime
3.1. Hardware Architecture
如图 3. 支持 fetch、load、compute 和 store 四个命令,支持流水线。特点:
- 可参数化,支持修改 GEMM 的形状、整形精度、SRAM 位宽
- 通过流水线实现了 latency hiding,实现形式和 TVM 里面的虚拟线程相对应
- task level ISA
- 有 tensor ALU 和 GEMM 两个计算模块;tensor ALU 负责 element wise 的操作,比如加法、激活函数、normalization、pooling 等,GEMM 做矩阵乘
3.2. JIT Runtime System
中间层,协调 CPU 和加速器的异构计算,同时把下层抽象成单个 TVM 后端便于开发;添加中间层还可以做内存管理之类的操作,使得模型不用被一次全部载入到加速器中,“overcome physical limitations”;
4.VTA Hierarchical Optimization
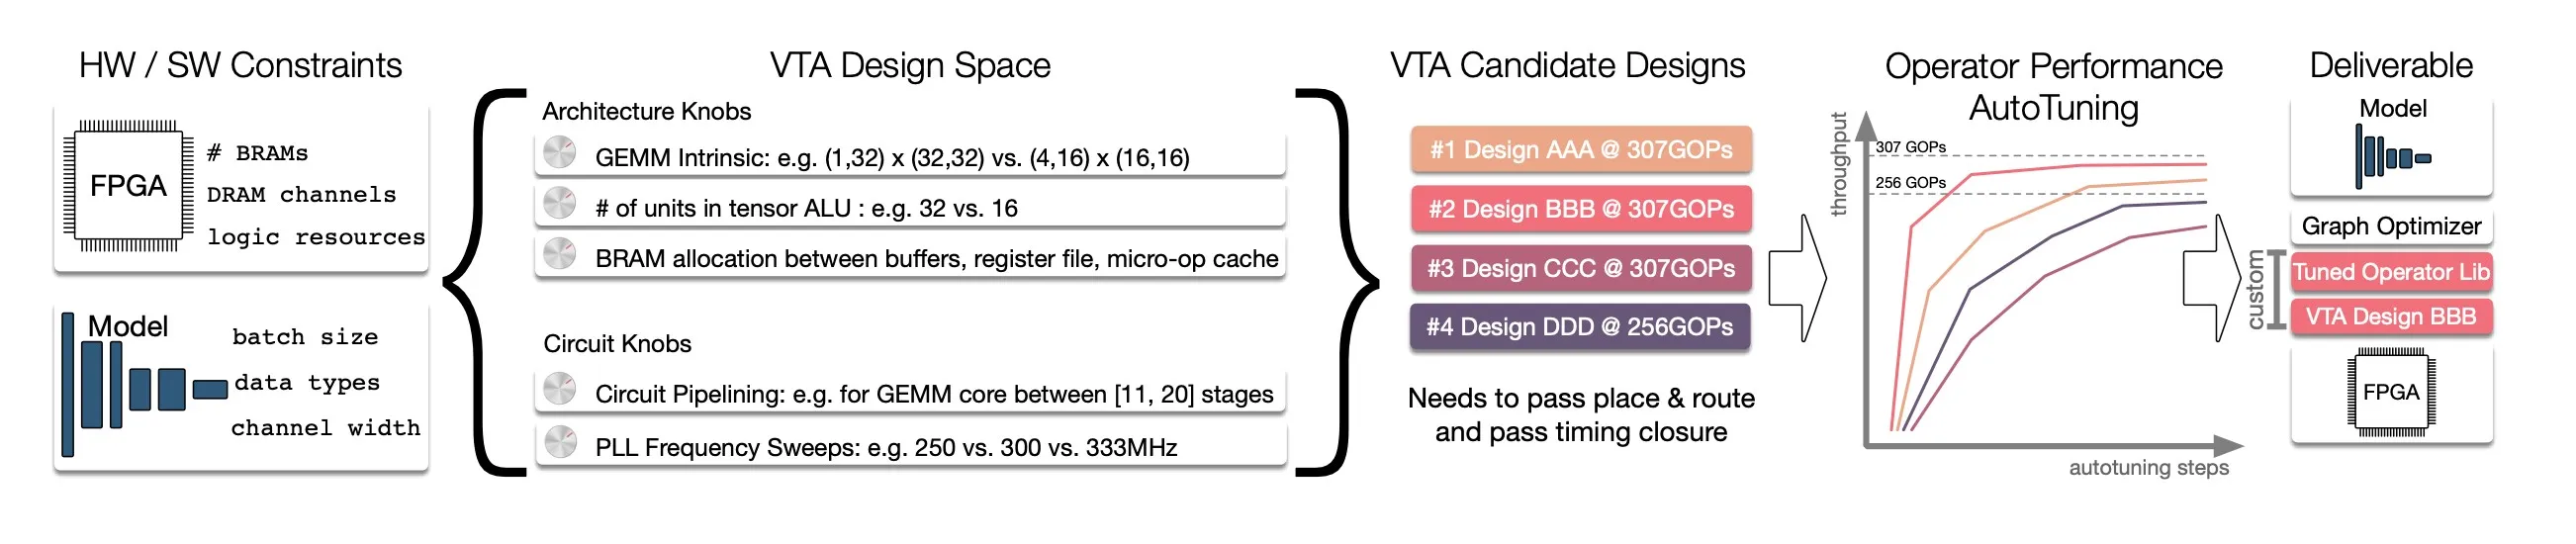
4.1. Hardware Exploration for Varying FGPA Sizes
VTA 的 GEMM 形状、数据类型、ALU 分配和电路相关的东西都是可调节的,设计空间很大,优化的软件要能搜索便于布线、性能较高的配置。 具体的配置要根据实际部署的模型运算性质进行调整,比如 conv2D 如果 kernel 面积大,按照 roofline model 描述的算术强度就高,就依赖于计算强度,而 kernel 很小甚至为 1(退化成 element wise 操作)就更依赖于内存带宽。
4.2. Schedule Exploration for Operator Autotuning
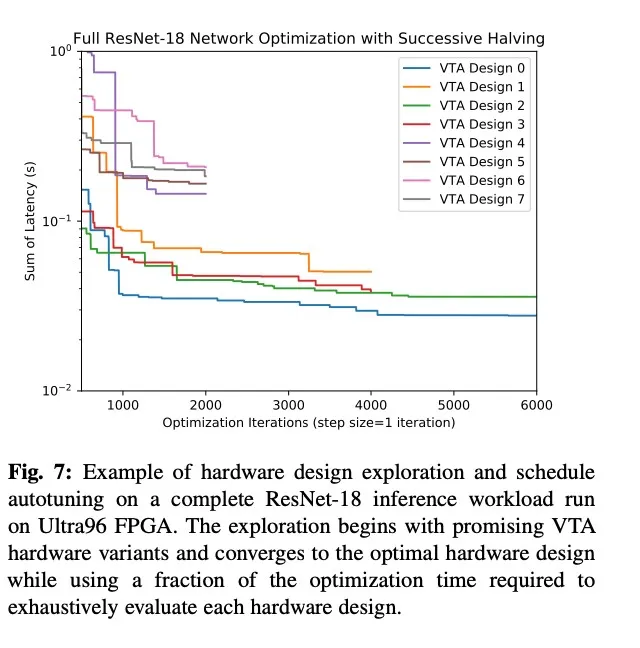
用的 TVM 之前做的方法,不同的 VTA 硬件参数本身也属于一个超参数,对这个参数的选择用了基于 SuccessiveHalving 的方法作为备选项。
- 看一下 SuccessiveHalving SuccessiveHalving: 首次迭代验证所有超参数组,平均分配资源,然后选择前 x%(一般是前一半,所以叫 halving)的超参数组重新迭代;
4.3. Full Network Optimization Case Study